
Multi-period Mean-Expectile Portfolio Optimization under Wasserstein Ambiguity: Reformulation, Degeneracy and the Role of the Ground Metric
Rupendra Yadav, Aparna Mehra
위험을 어떻게 재는가에 따라, 똑같은 데이터에서 완전히 다른 포트폴리오가 나온다 — 그리고 "위험 측도를 CVaR에서 엑스펙타일로 바꾸고 분포가 틀릴 가능성까지 감안하자"고 제안한 최신 연구는, 조건을 철저히 맞춘 대결에서 9전 전승을 기록했다.
들어가며: "가장 나쁜 날"만 보는 위험 측도의 맹점
주식 투자를 하다 보면 언젠가 이런 생각을 하게 됩니다. "지난달 최악의 날에 5%를 잃었어. 앞으로도 그 정도는 감수해야 하는 걸까?" 퀀트 세계에서는 이런 질문을 숫자로 옮기기 위해 여러 가지 '위험 측도'를 씁니다. 그중 요즘 표준처럼 쓰이는 것이 CVaR(조건부 가치위험, Conditional Value-at-Risk)인데, 쉽게 말하면 "가장 나쁜 5% 날들에 평균적으로 얼마나 잃는가"입니다.
그런데 이 방식에는 흥미로운 맹점이 하나 있습니다. 최악의 5% 구간에 속한 날들이냐 아니냐만 따지기 때문에, "5% 안에 든 날들"이 전부 비슷하게 나쁘든 한두 날이 압도적으로 나쁘든 CVaR 값이 같게 나올 수 있습니다. 순위(순서)만 보고 손실의 '크기'를 충분히 반영하지 않는 거죠. 게다가 CVaR 예측은 실현 결과와 견줘 채점을 하기가 까다로운 성질을 갖고 있어서, "우리가 예측한 위험이 맞았는지"를 검증(백테스트)하는 것 자체가 어렵습니다.
2026년 10월에 나온 논문 "Multi-period Mean-Expectile Portfolio Optimization under Wasserstein Ambiguity"는 이 문제를 정면으로 파고듭니다. 위험 측도를 엑스펙타일(expectile)로 바꾸고, 게다가 "내가 추정한 수익률 분포 자체가 틀렸을 수 있다"는 불확실성까지 모형에 넣으면 어떻게 되는지를, 이론과 13년치 실증 데이터로 모두 따져 본 것입니다.
무엇이 문제였나: 계산이 안 돼서 못 쓰던 위험 측도
엑스펙타일은 1987년에 제안된 비대칭 최소제곱의 일반화로, 직관적으로는 "나쁜 날에 훨씬 큰 가중치를 주어 평균을 내는 것"에 가깝습니다. 예를 들어 0.95 엑스펙타일은 평범한 날은 거의 무시하고, 나쁜 날일수록 급격히 큰 가중치를 매겨 "극단적 국면에서의 평균 손실"을 측정합니다. CVaR와 달리 손실의 크기에 반응하고, 더 중요한 성질이 하나 더 있습니다. 유도 가능성(elicitability) — "예측한 위험 vs 실제 손실"을 점수 매겨 비교할 수 있어서, 위험 예측 자체를 백테스트로 검증할 수 있습니다. 날씨 예보가 "내일 강수 확률 30%"라고 했을 때 실현 결과로 예보의 정확도를 채점할 수 있는 것과 같은 이치입니다. 수학적으로 엑스펙타일은 "법칙 불변 + 정합적 + 유도 가능"을 모두 만족하는 유일한 위험 측도로 알려져 있습니다(Ziegel, 2016).
문제는 계산이었습니다. CVaR는 수학적으로 다루기 편한 표현(Rockafellar–Uryasev 표현)이 있어서, "분포가 틀릴 수 있다"는 불확실성을 넣은 강건 최적화(DRO, distributionally robust optimization)로도 쉽게 옮길 수 있었습니다. 반면 엑스펙타일에는 그런 지름길이 없었고, 그래서 강건 포트폴리오 연구는 거의 전부 CVaR에 편중되어 있었습니다.
핵심 아이디어: "어려운 최악의 값"을 "쉬운 방정식의 근"으로 바꾸다
이 논문의 첫 번째 기여는 수학적 장치입니다. Wasserstein 모호성 집합 — 쉽게 말하면 "관찰한 데이터에서 너무 멀지 않은, 가능한 수익률 분포들"의 모음 — 위에서 최악의 엑스펙타일을 구하려면 보통 아주 어려운 최적화 문제가 됩니다. 논문은 이 값을 "한 방정식의 유일한 해(근)"로 재해석하는 포착 정리(envelope theorem)를 새로 증명했습니다. "최악의 경우를 일일이 찾아 헤매는" 문제를 "방정식을 푸는" 문제로 바꾼 셈인데, 이렇게 하면 최적화 이론의 표준 도구(Wasserstein 쌍대성)를 그대로 쓸 수 있게 됩니다.
이 장치를 쓰면 원래 문제가 아주 복잡한 3중 구조(배분 결정 → 목표수익 제약 → 최악의 분포 선택)였던 것이, 제한된 변수 개수의 선형계획 문제 4개로 정확히 바뀝니다. "복잡한 금융 최적화를 사실상 표준 소프트웨어로 풀 수 있는 형태로 환원했다"는 것이 실무적으로 큰 의미입니다.
두 번째 기여는 더 재미있습니다. 강건 최적화에는 지름자(ground metric)라는 선택이 있는데, 이건 "두 분포가 얼마나 비슷한가"를 잰 방법입니다. 연구진은 이 선택이 포트폴리오의 성격을 통째로 바꾼다는 걸 수학적으로 보여 줍니다.
- ℓ∞ 방식으로 거리를 재면: "가장 크게 벌어진 한 개 자산"만 보고 거리를 잽니다. 그런데 주식만 사는(비중의 합이 1) 포트폴리오에서 이 거리 측정은 어떤 배분을 골라도 똑같은 값이 나와서, 강건화가 포트폴리오를 구별하지 못하고 집중에 사실상 무관심해집니다.
- ℓ1 방식으로 거리를 재면: 거꾸로 "가장 비중이 큰 종목"에 벌칙이 붙습니다. 한 종목에 몰수록 페널티가 커지니 자연스럽게 분산화가 유도됩니다.
같은 데이터, 같은 강건화라도 자를 바꾸면 결과가 달라진다는 이야기인데, 선행 연구가 쓰던 설정(ℓ∞)이 바로 집중을 부추기는 쪽이었다는 점이 이 논문이 짚은 함정입니다.
세 번째로, 반경(불확실성의 허용 범위 ρ)이 커지면 언젠가 모형이 사실상 엑스펙타일을 버리게 된다는 "퇴화 임계값"을 찾아냅니다. 반경이 이 임계값을 넘으면 최악의 경우를 방어하는 항이 완전히 죽고 남는 건 "평균 수익 최대화"뿐입니다. "강건하게 투자한다"고 믿었는데 알고 보니 그냥 평균만 추구한 셈이 되는 거죠. 이 임계값은 포트폴리오 배분에 따라 달라지기 때문에, 투자자가 실제로 계산해서 감시해야 할 지표입니다.
결과 — 무엇을 알아냈나
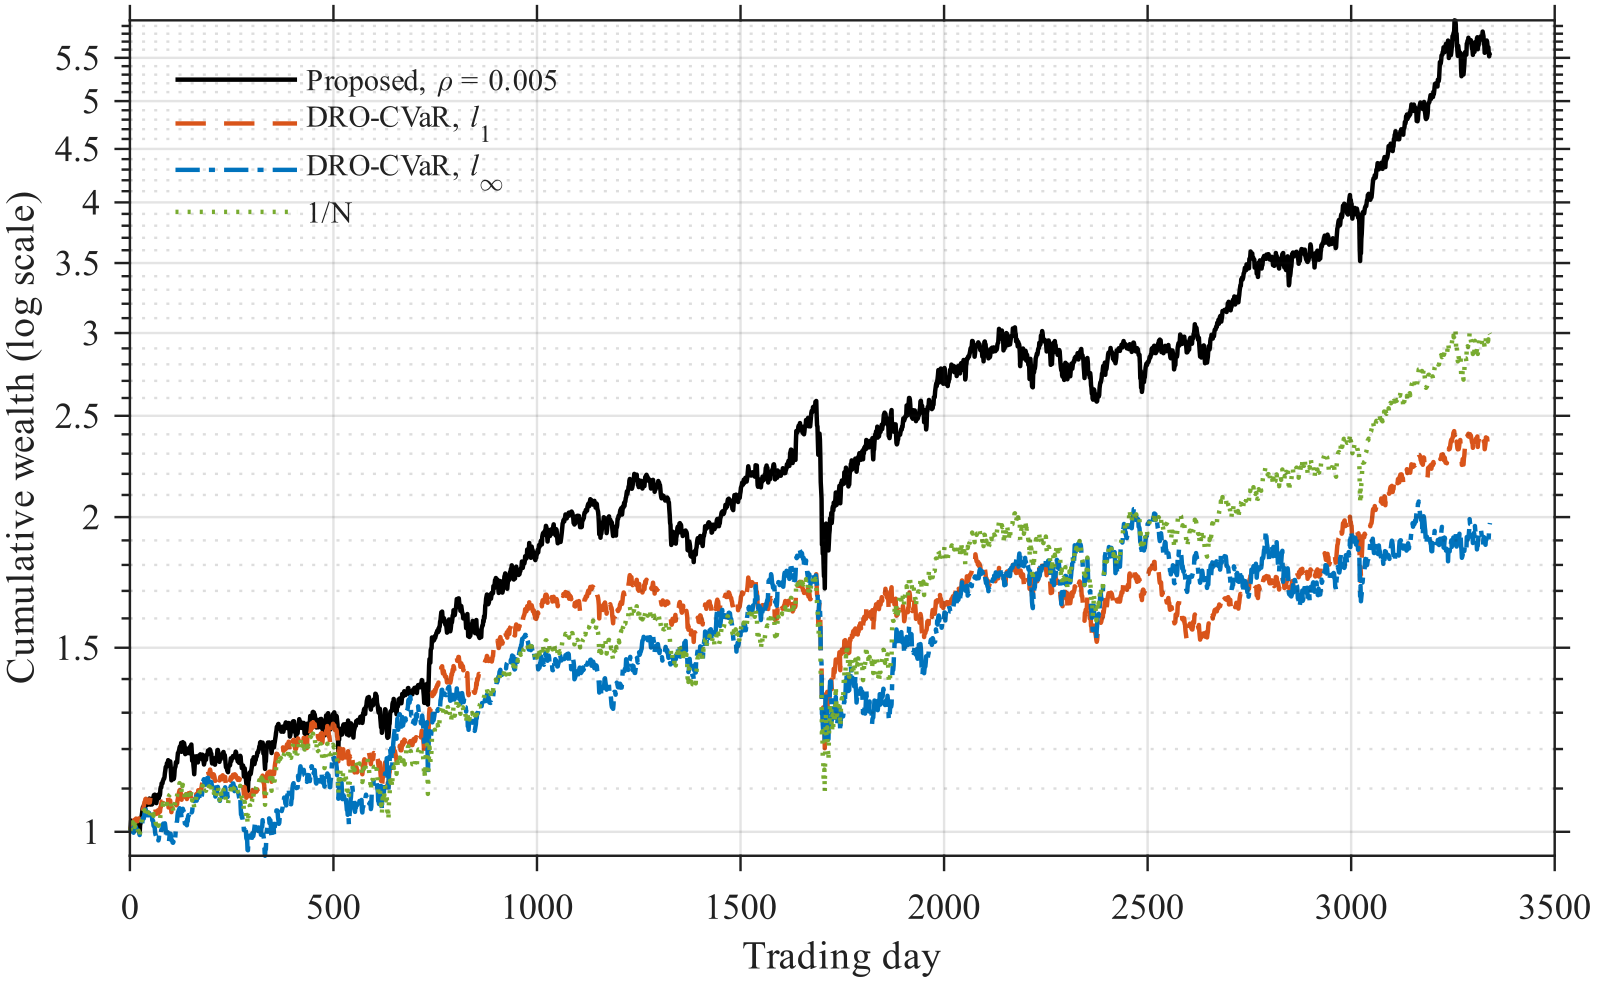
실험은 FTSE 지수 구성종목 90개의 일간 수익률(2012년 9월 ~ 2026년 6월, 3,591거래일)로 진행했습니다. 250일짜리 창으로 분포를 추정하고 21거래일마다 갈아 타서, 표본 외 3,341거래일(약 13.3년) 동안 성과를 쌓았습니다. 리스크 수준(0.95), 트레이드오프 가중치(0.10/0.15/0.20), 불확실성 반경(0.001/0.005/0.010)의 9가지 조합을 돌렸습니다.
가장 깔끔한 대결은 "오직 위험 측도만 바꾼" 비교입니다. 모호성 집합, 지름자, 반경, 가중치, 목표수익, 리밸런싱 주기, 제약을 전부 똑같이 맞추고 엑스펙타일과 CVaR만 교체했는데 — 9개 조합 전부에서 엑스펙타일이 더 높은 샤프 비율을 기록했고 평균 격차는 +0.243이었습니다. 다만 솔직하게 짚어야 할 부분도 있습니다. 일간 수익률은 서로 연관되어 있어서(변동성 군집) 단순 검정은 과신하기 어렵고, 이에 맞춘 블록 부트스트랩 검정에서는 불확실성 반경이 가장 작은 0.001에서는 격차가 통계적으로 유의하지 않았고, 반경이 0.005 이상인 6개 조합에서만 전부 유의했습니다. "원래 분포와 거의 다르지 않은 세상"에서는 두 측도의 차이가 아직 증명되지 않았다는 뜻입니다.
눈에 띄는 개별 결과를 몇 가지 정리하면:
- 반경 0.005, 가중치 0.10 조합에서 두 모형은 거의 똑같이 분산화되어 있는데(유효 종목 수 18.64 대 18.59), 연 수익률은 13.9% 대 7.2%로 벌어졌습니다. 분산화 수준이 같으니 "같은 리스크 안에서 더 안전한 종목 조합을 골랐다"는 해석이 가능합니다.
- 흔한 벤치마크인 동일가중(1/N) 투자 대비로는, 같은 조합에서 연 수익 13.9% 대 9.5%(+47%), 변동성 14.4% 대 15.4%(−7%), 최대 낙폭 33.8% 대 37.6%(−10%)로 네 가지 지표를 모두 이겼습니다. 9개 조합 중 6개가 이처럼 네 가지를 동시에 상회했습니다.
- 반면 "강건화를 아예 뺀" 명목 모형은 샤프 비율 1.209로 최고처럼 보이지만, 유효 종목이 2.07개에 평균 최대 비중 57.6%, 최대 낙폭 50.6%입니다. 화려한 샤프 비율 뒤에 극단적 집중이 숨어 있는 전형적인 모습입니다.
- 지름자 실험에서는 예측된 "퇴화"가 그대로 관찰되었습니다. ℓ∞ 지름자에서는 반경이 5배, 가중치가 2배나 다른 6개 조합이 완전히 동일한 포트폴리오(연 6.54%, 샤프 0.390)를 뱉어 냈고, 이 모형은 9개 조합 전부에서 동일가중에 못 미쳤습니다.
한계와 주의점
- 한 시장, 한 데이터셋입니다. FTSE 구성종목만, 게다가 "표본 말일 기준"으로 고정해 썼기 때문에 생존편향이 있을 수 있습니다(논문도 명시). 비교 대상 모형에 공통으로 적용되므로 상대 비교는 유지되지만, 절대 수익률은 과대평가됐을 가능성이 있습니다.
- 거래비용 전(gross) 수익 기준입니다. 보충 자료에서는 고려한 비용 수준 내에서 핵심 결과가 유지된다고 주장하지만, 원문 본문 기준으로는 비용 차감 전 수치라는 점을 기억해야 합니다.
- 엑스펙타일(0.95)과 CVaR(0.95)은 같은 눈금이 아니어서, 나쁜 비교가 되기 쉽습니다. 이 논문은 양쪽 수치를 모두 보고하고 반경 매칭 계수로 눈금을 맞추는 등 이 문제를 의식적으로 통제했지만, 이런 "측도 매칭"은 항상 확인해야 할 부분입니다.
- 강건화 반경 ρ는 여전히 사람이 정해야 하는 매개변수입니다. 논문은 데이터 기반 캘리브레이션(정상 블록 부트스트랩)을 제안하지만, "올바른 ρ"가 존재한다는 보장은 없습니다.
- 재현성 측면: 데이터가 LSEG Refinitiv라는 상용 소스이고 코드 공개가 없어(우리 KB 재현성 점수 38/100), 독립 재현에는 공개 지수로의 대체 검증이 필요합니다. 문제 구조 자체는 상세히 명시되어 있어 직접 구현은 가능합니다.
그래서 투자/실무엔?
일반 투자자 입장에서는 "리스크 측도도 결국 설계 선택"이라는 교훈이 가장 중요합니다. 같은 시장 데이터를 두고 "가장 나쁜 5%의 평균"(CVaR)을 볼지, "나쁜 날에 큰 가중치를 준 평균"(엑스펙타일)을 볼지에 따라 13년 뒤 자산 곡선이 달라질 수 있다는 뜻입니다. 그리고 엑스펙타일 쪽이 갖는 실용적 장점은 위험 예측을 채점할 수 있다는 점 — "우리 리스크 모델이 맞나"를 정기적으로 검증하는 체계를 만들 수 있습니다.
자기자본 운용처럼 포트폴리오를 직접 짜는 실무자에게는 세 가지가 바로 쓸모 있습니다.
- 지름자는 경제적 선택이다. 주식 비중 100% 포트폴리오를 강건화할 거면 "가장 큰 한 종목"에 벌칙이 가는 방식(ℓ1)을 써야 분산화 유도가 실제로 작동합니다. 라이브러리 기본값이 어떤 거리 함수를 쓰는지 확인해 볼 일입니다.
- 불확실성 반경은 절대값이 아니라 임계값 대비 비율(ρ/ρ_crit)로 관리하세요. 임계값을 넘으면 모형은 "강건한 척하는 평균 추구기"가 됩니다. 이 논문의 실험에서는 반경 비율이 최대 0.34에서 놀았기 때문에 꼬리 항이 살아 있었습니다.
- 매개변수가 실제로 작동했는지 기록하세요. 논문은 리밸런싱마다 "수익–리스크 트레이드오프가 실질적으로 작동한 비중"을 함께 보고하라고 권합니다. 이 비중이 21%까지 떨어졌던 조합처럼, 매개변수를 키웠는데 오히려 모형의 의도가 무력화되는 경우를 잡아낼 수 있습니다.
과장 없이 말하면, 이 논문은 "엑스펙타일이 만능"이라는 이야기가 아닙니다. 반경이 작은 영역에서는 아직 두 측도의 차이가 통계적으로 증명되지 않았고, 시장도 하나뿐입니다. 다만 위험 측도·거리 함수·반경처럼 대충 넘기기 쉬운 선택들이 실제로 성과를 좌우한다는 점을, 이론과 실증 양쪽에서 정확하게 짚어 냈다는 점에서 읽어볼 가치가 있는 연구입니다.
더 알아보기
- 원문: Multi-period Mean-Expectile Portfolio Optimization under Wasserstein Ambiguity (arXiv:2610.11917)
- OHSE AI Lab KB 5차원 점수(참고): 참신성 78 · 적용성 68 · 엄밀성 72 · 재현성 38 · 통찰 76 (종합 67.6, A등급)
- 관련 논문 (KB 유사도 기준):
- Certified High-Dimensional Wasserstein Robust Portfolio Optimization (arXiv:2608.07032) — Wasserstein 강건 포트폴리오의 고차원 버전
- Data-driven Multiperiod Robust Mean-Variance Optimization (arXiv:2306.16681) — 다기간 강건 최적화의 또 다른 경로
- A fully data-driven approach to minimizing CVaR for portfolio of assets (arXiv:2007.01672) — CVaR 쪽 데이터 기반 접근과의 비교점
관련 글
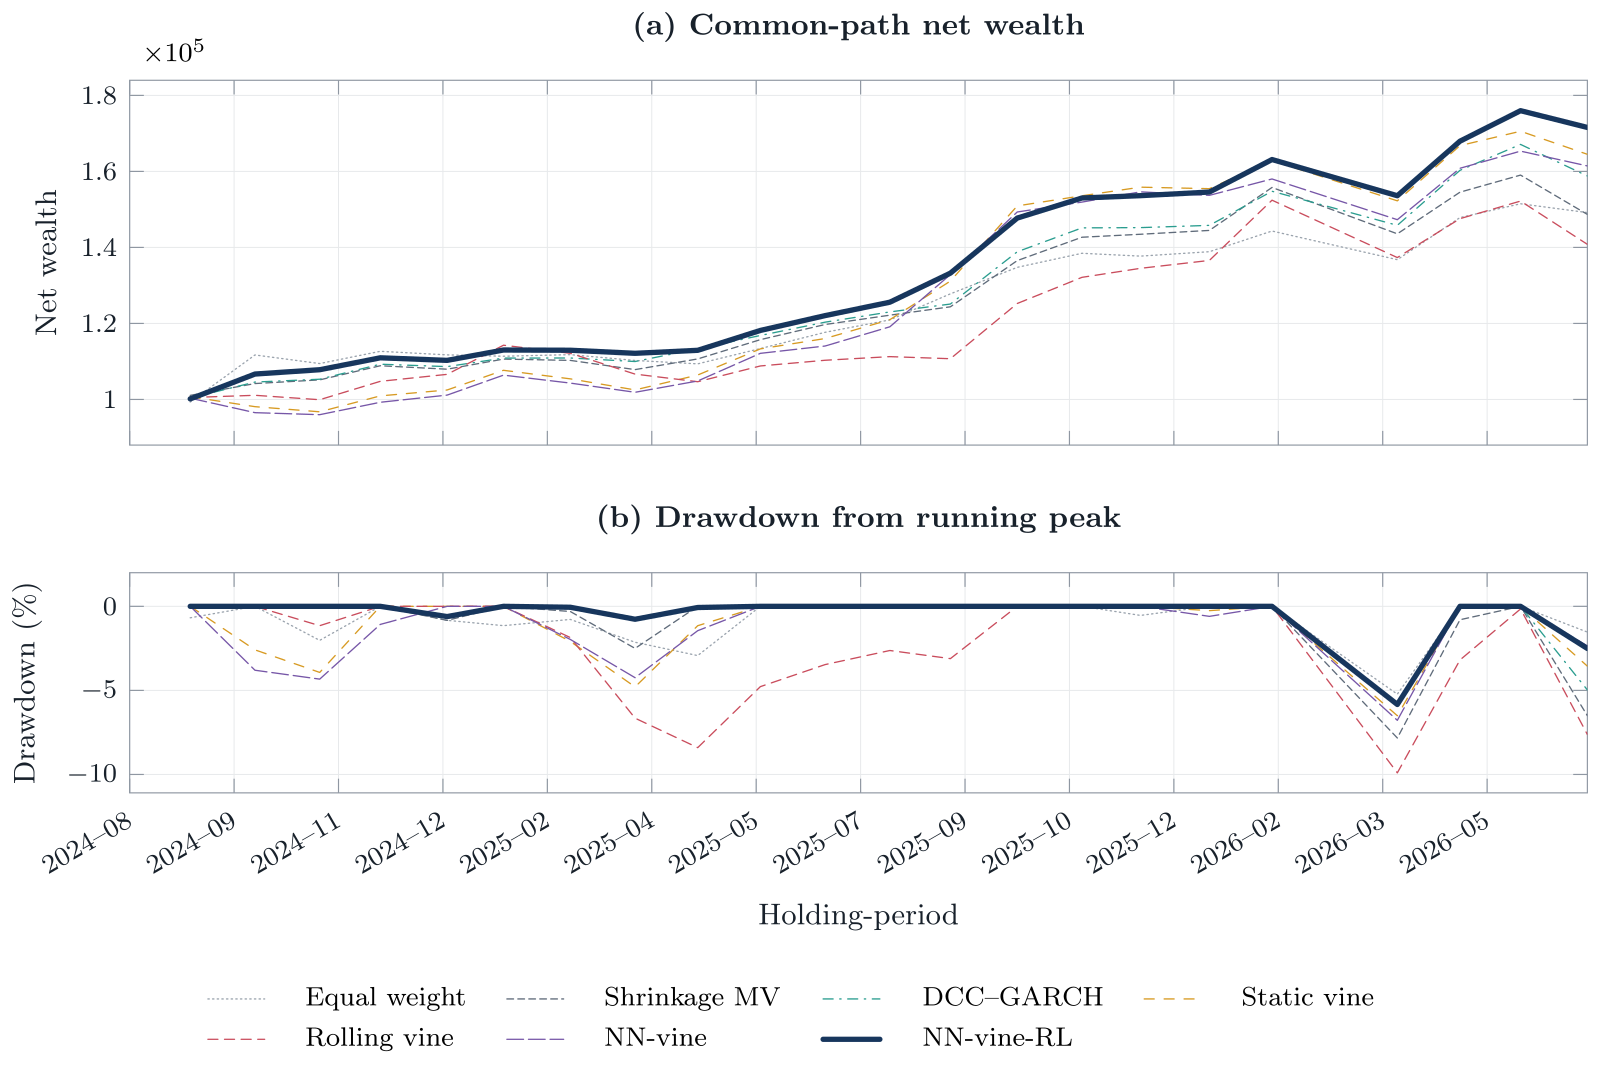 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 포트폴리오 최적화A
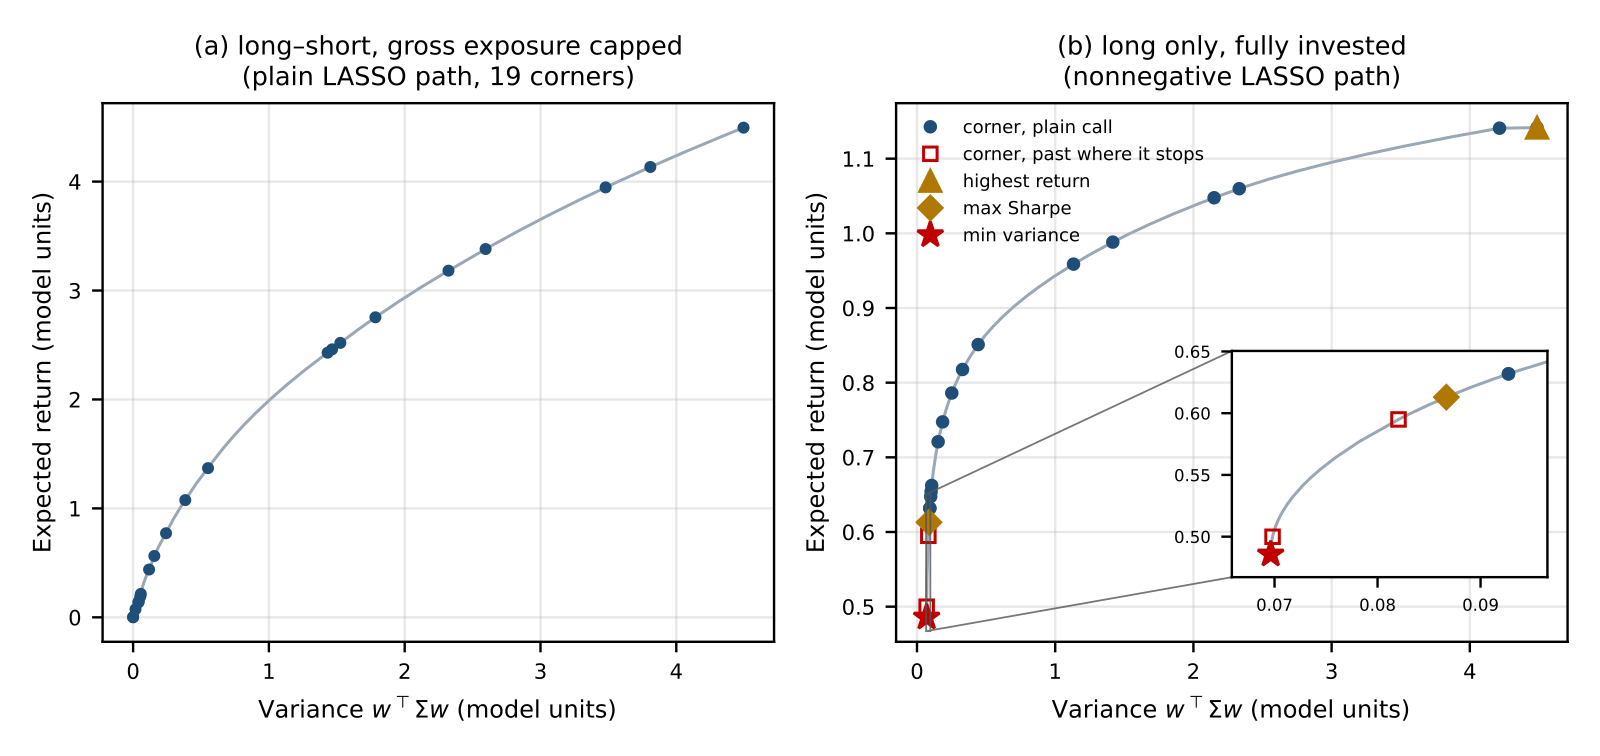
포트폴리오 최적화, 어렵게 풀 필요 없이 LASSO 한 번으로 — 효율적 프런티어의 놀라운 등가성
머신러닝에서 흔히 쓰는 변수 선택 도구 LASSO가 마코위츠의 효율적 프런티어를 그대로 그려 준다는 연구를 쉽게 풀어 설명합니다. 포트폴리오 최적화 계산이 왜 수십 배 빨라지는지, 그리고 주의할 한계까지 정리합니다.
 포트폴리오 최적화A
KellyBoost: 머신러닝으로 최적 포트폴리오를 직접 만드는 새로운 방법
그래디언트 부스팅 트리로 켈리 기준 성장 최적 포트폴리오를 직접 학습하는 KellyBoost 방법론을 소개합니다. 예측과 최적화를 분리하는 기존 방식의 한계를 넘어, 목표 함수를 직접 최적화하는 엔드투엔드 접근법의 가능성과 한계를 살펴봅니다.