Rachev-Ratio Portfolio Optimization with TimeGAN Scenarios: Replacement versus Supplementation
Yifan He
한 줄 요약: 인공지능이 만들어 낸 "가짜 과거"로 투자하면 더 잘 벌 수 있을까? 한 연구팀이 12개 ETF로 정직하게 실험해 본 결과, 생각보다 답은 "글쎄요"였습니다. 그리고 그 "글쎄요"를 정확히 밝히는 방법 자체가 이 논문의 진짜 보물입니다.
들어가며
우리가 투자 결정을 내릴 때 가장 아쉬운 것은 "미래를 알 수 없다"는 사실입니다. 그래서 흔히 하는 방법이 과거 데이터를 되풀이해서 보는 겁니다. 2008년 금융위기 때는 어떻게 움직였고, 2020년 코로나 폭락 때는 어땠는지. 그런데 이런 과거 사례는 많아야 수십 개뿐입니다. 위기라는 것은 드물게 일어나니까요.
그러면 이런 생각이 떠오릅니다. "그냥 비슷한 가짜 데이터를 잔뜩 만들어 내면 안 될까?"
바로 이 아이디어가 요즘 생성형 인공지능을 금융에 쓰는 가장 인기 있는 방법 중 하나입니다. 마치 사진을 사실적으로 만들어 내는 인공지능처럼, 주가 흐름 자체를 사실적으로 만들어 내는 모델이 있습니다. 그중 대표적인 것이 TimeGAN이라는 시계열 생성 모델입니다. 진짜 주가의 특징(변동성, 상승·하락 패턴, 종목 간 연동 등)을 학습해서, 겉보기에 진짜 같은 "가짜 주가 시나리오"를 무한정 뽑아 줍니다.
이 논문은 이렇게 만든 가짜 시나리오를 실제 포트폴리오 운용에 넣었을 때 정말로 돈이 더 벌리는지를 냉정하게 검증합니다. 그리고 결론은 예상 밖으로 담백합니다.
무엇이 문제였나: "그럴듯한 가짜"는 "돈이 되는 가짜"와 다르다
가짜 데이터를 투자에 쓰는 연구들은 대부분 이렇게 평가합니다. "생성한 데이터가 진짜 데이터와 얼마나 비슷한가?" 통계 지표로 비슷함을 확인하고 끝입니다.
하지만 이 논문은 지적합니다. 데이터가 비슷해 보여도, 그 데이터로 만든 투자 전략이 실제로 돈을 벌지 못할 수 있다고요. 두 가지 이유가 있습니다.
첫째, 포트폴리오 최적화라는 계산은 "잘못된 데이터"에 민감하게 반응합니다. 이 논문이 쓰는 투자 기준은 Rachev 비율(라셰프 비율)이라는 건데, 이름이 어렵지만 의미는 단순합니다. 투자로 잘 벌 때의 이익(상위 꼬리)이 크게 잃을 때의 손실(하위 꼬리)보다 얼마나 큰지를 재는 지표입니다. 쉽게 말해 "복권을 샀을 때의 짜릿함 대비 파산할 때의 고통"을 비교하는 셈이죠. 그런데 이 비율은 "드물게 일어나는 극단적 사건"에 의존합니다. 가짜 데이터가 바로 그 극단적 사건을 못 만들어 내면, 계산 자체가 엉뚱한 방향으로 흔들립니다.
둘째, 현실의 투자에는 거래비용과 체결 지연이 있습니다. 가짜 데이터 실험에서 자주 빠지는 부분이죠. 전략이 자주 사고팔면 그 비용이 수익을 갉아먹습니다.
이 논문은 이 두 가지를 모두 정면으로 다룹니다.
핵심 아이디어: 가짜 데이터를 "섞는 방법"과 "개수"를 따로 실험하다
이 연구의 설계가 훌륭한 이유는, 흔히 뭉개지는 변수들을 분리해서 실험했기 때문입니다.
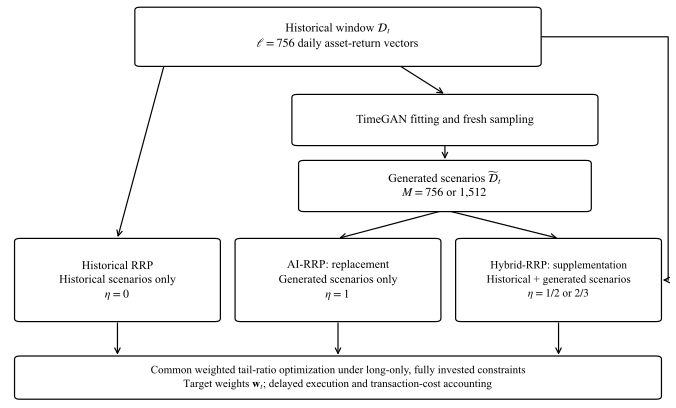
- 얼마나 섞을까? 과거 데이터를 가짜 데이터로 통째로 대체(replacement)할지, 아니면 원래 데이터에 가짜를 보충(hybrid)해서 확률적 무게를 줄지.
- 몇 개를 뽑을까? 가짜 시나리오를 756개 뽑을지, 1,512개 뽑을지. 이건 "합성 데이터의 무게"와 별개 문제입니다.
그리고 모든 전략에 공통 규칙을 적용했습니다. 2007년 4월 11일부터의 12개 ETF(원유, 국채, 회사채, 주식 지수 등 다양한 자산), 756일(약 3년)짜리 학습 창, 20일 간격의 리밸런싱(총 198번의 의사결정), 그리고 거래비용 10bp(거래 대금의 0.1%)와 체결 지연까지 반영. 게다가 TimeGAN 학습을 5개의 다른 초기값(시드)으로 반복해서, "운 좋게 잘 나온 모델 하나"가 아닌 "보통 수준의 모델들"을 평가했습니다.
결과 — 무엇을 알아냈나
1. 가짜 데이터는 "덜 위험해 보이게" 만든다.
TimeGAN이 만든 시나리오는 진짜보다 변동성이 작고, 큰 손실(꼬리 위험)을 과소평가했으며, 종목들이 서로 어떻게 같이 움직이는지도 왜곡했습니다. 학습을 더 오래 돌려도(50 에포크 → 200 에포크) 재구성 오차는 좋아졌지만 종목 간 상관 정확도는 나아지지 않았습니다. "학습을 많이 했다 = 믿을 만하다"가 성립하지 않는다는 뜻입니다.
2. 수익은 기대만큼 좋지 않았다.
순수익(거래비용 제하고 연 환산)을 비교하면:
| 전략 | 연 환산 순수익 |
|---|---|
| 과거 데이터만 사용 (기준) | 3.48% |
| 가짜 데이터 동일 비중 보충 | 약 2.80% |
| 가짜 데이터 높은 비중 보충 | 3.99 ~ 4.25% |
| 가짜 데이터로 완전 대체 | 3.53 ~ 4.03% |
| (참고) 단순 등가중 리밸런싱 | 6.41% |
| (참고) 사서 묻어두기 | 8.41% |
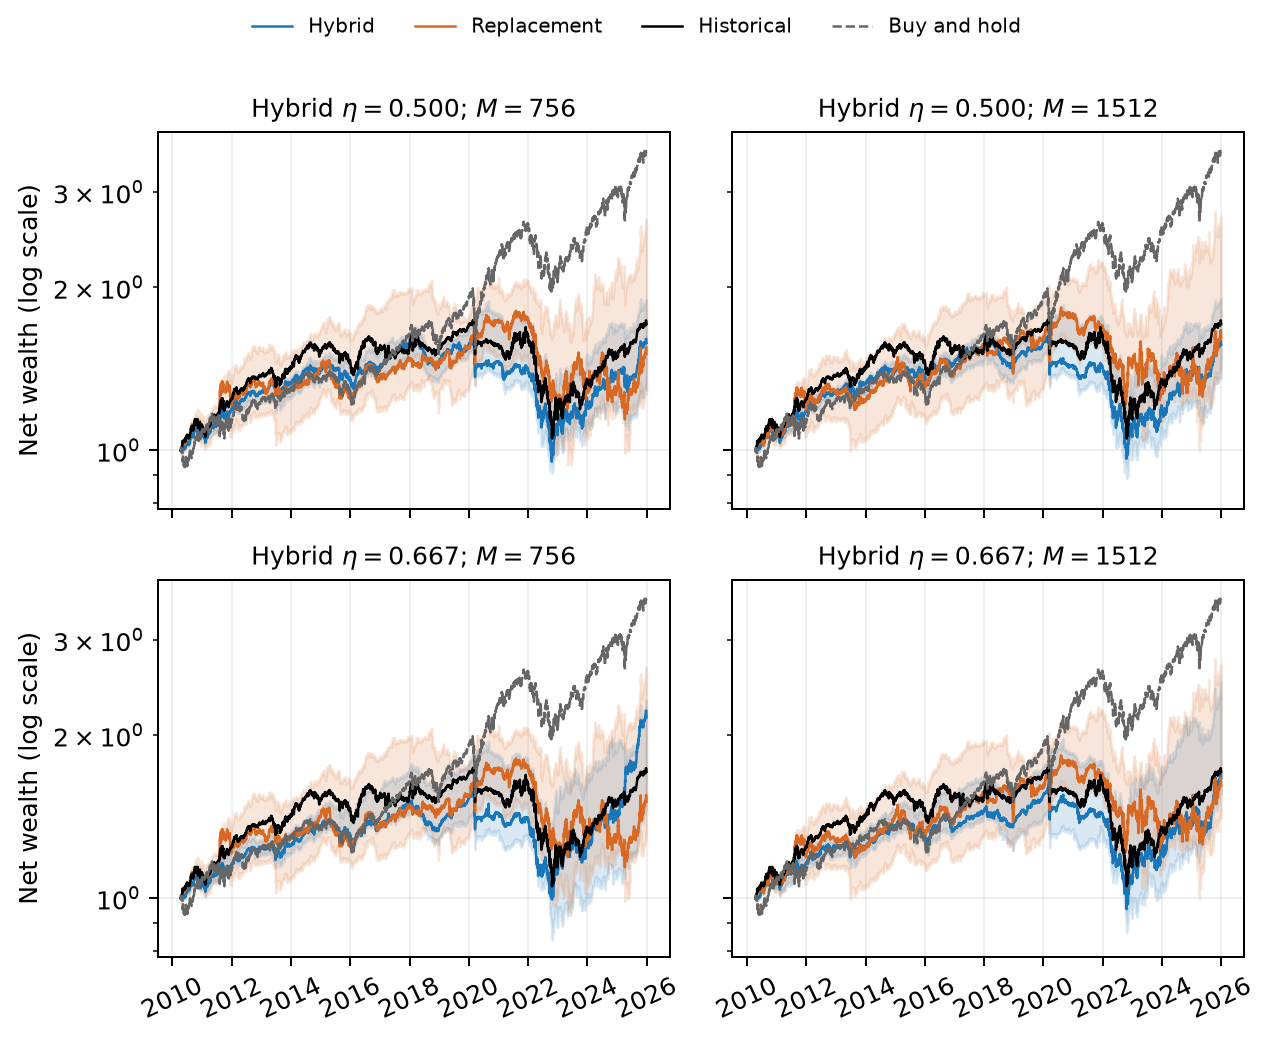
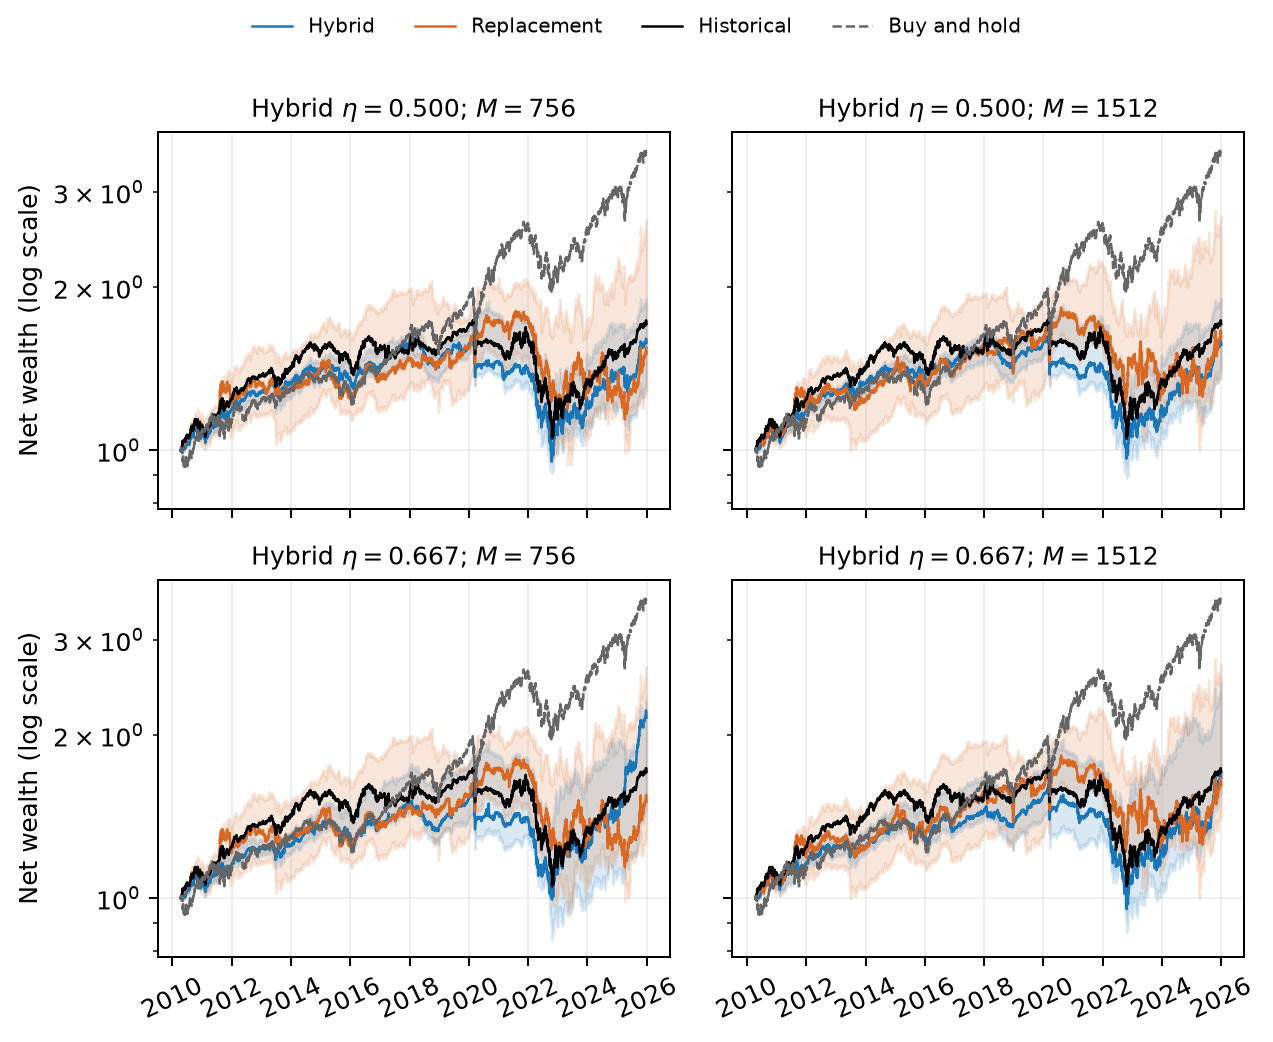
눈에 띄는 점이 두 가지입니다. 우선 "높은 비중 보충"이 평균적으로는 기준보다 높아 보이지만, 5개 모델 시드별로 나눠 보면 2.42~5.26%(756개 생성 시)로 천차만별이고, 기준을 넘은 시드는 5개 중 3개뿐입니다. 그리고 통계적으로 "확실히 낫다"고 말할 수 있는 비교는 하나도 없었습니다. 모든 신뢰구간이 0을 포함했거든요. 쉽게 말해 "이 정도 차이는 그냥 운일 수 있다"입니다.
더 뼈아픈 사실은, 아무것도 안 하는 사서 묻어두기(8.41%)가 30개의 모든 생성 전략을 이겼다는 점입니다. 물론 논문은 정직하게 덧붙입니다. "성장률과 꼬리 위험은 별개의 이야기다. 과거 데이터 전략은 사서 묻어두기보다 꼬리비율(실현 기준 약 0.956 대 0.909)이 오히려 좋았다"고요.
3. 가짜 데이터로 대체하면 거래가 폭증한다.
완전 대체 전략의 연간 회전율(자금이 얼마나 자주 갈아타는지)은 약 840~850%로, 과거 데이터 전략(234%)의 3.5배가 넘었습니다. 수수료 10bp가 작은 것 같아도, 3.5배 자주 거래하면 그만큼 이득을 깎아먹습니다.
4. 단순 리샘플링보다는 평균이 나았다.
흥미로운 위로거리도 있습니다. TimeGAN 시나리오의 평균 수익은 "가짜가 아니라 그냥 과거 데이터를 섞어 쓰는" 단순 리샘플링(IID, 이동블록)보다는 높았습니다. 다만 이것도 신뢰구간이 0을 포함합니다. 즉, "충실도가 별로인 생성기가 단순 복사보다는 낫다"는 방향성은 있으나 확정할 수 없다는, 아주 조심스러운 결론입니다.
5. "좋은 성과"가 수치 장난일 수 있다.
Rachev 비율 계산식의 분모(손실 부분)에 최소값(바닥)을 두는 방식이 있는데, 이 바닥값을 바꾸자 완전 대체 전략의 목표 포트폴리오 가중치 35.21%가 이동했고, 일일 손실 위험(CVaR)은 오히려 올라갔습니다. 계산식의 작은 설정 하나가 전략의 성격을 통째로 바꿀 수 있다는 뜻입니다. 투자 전략 백테스트에서 "수치가 잘 나왔다"는 말이 얼마나 연약할 수 있는지를 보여 주는 대목입니다.
한계와 주의점
논문 스스로가 한계를 아주 솔직하게 적고 있습니다.
- 이 결론은 ETF 12종목, 특정 기간, 특정 TimeGAN 구현, 고정된 학습 예산에 대한 것입니다. 모든 TimeGAN, 모든 생성 모델에 대한 일반 결론이 아닙니다.
- 실험 설계가 진행되면서 평가 기준이 조정되었고(사전 등록 없음), 깨끗한 "최종 시험" 데이터셋이 따로 없습니다.
- 5개 시드는 같은 시장 역사를 놓고 모델을 다르게 학습시킨 것이지, 시장을 5번 독립적으로 겪은 게 아닙니다. 그래서 불확실성이 큽니다.
- "생성 오차 → 수익 하락"의 인과 관계를 입증하지 못했습니다. 함께 관찰된 현상일 뿐, 원인과 결과로 단정할 수 없습니다.
그래서 투자/실무엔?
이 논문의 진짜 가치는 "TimeGAN 쓰지 마라"가 아니라 "합성 데이터를 투자에 넣을 때 무엇을 점검해야 하는가"의 교과서라는 점입니다. 정리하면 세 가지입니다.
- 충실도, 수치 거동, 실현 성과 — 세 가지를 반드시 함께 볼 것. 데이터가 비슷한지(통계 지표), 계산이 흔들리지 않는지(목표 함수의 분모 같은 디테일), 실제 돈이 남는지(거래비용·회전율 반영 후). 셋 중 하나라도 빠지면 과장된 결론이 나옵니다.
- 생성 개수를 늘리는 것과 유용성을 개선하는 것은 다르다. 가짜 시나리오를 2배로 뽑아도 "새로운 정보"가 생기지는 않습니다. 표본을 많이 뽑는 것과 좋은 데이터를 갖는 것은 별개예요.
- 차라리 보충이 낫다. 이 실험에서 데이터를 통째로 대체한 전략은 거래가 3.5배 늘었는데 확실한 이득이 없었습니다. 가짜 데이터는 "기존 데이터의 빈틈을 메우는 보조재"로 쓰는 편이 안전합니다.
우리가 운용하는 시스템 트레이딩 관점에서도 시사점이 분명합니다. 백테스트 성과를 보고할 때 "생성 데이터로 보강하면 좋아진다"는 주장을 만나면, 첫 질문은 "회전율과 거래비용 반영 후에도?", 두 번째 질문은 "단순 리샘플링 대비로도?"여야 합니다.
더 알아보기
- 원문: Rachev-Ratio Portfolio Optimization with TimeGAN Scenarios: Replacement versus Supplementation (arXiv:2610.24544)
- 5차원 점수 (OHSE AI Lab KB 기준): 새로움 68 / 실용성 72 / 엄밀성 82 / 재현성 84 / 통찰 76 (종합 76.5, A등급)
- 관련 논문 (KB 엔티티 공유 기준):
- Robustifying Markowitz (arXiv:2212.13996) — 포트폴리오 최적화를 불안정하게 만드는 요인을 다루는 고전적 접근
- A dynamic conditional approach to portfolio weights forecasting (arXiv:2004.12400) — 시장 상태에 따라 포트폴리오 가중치를 예측하는 방법
- Realistic Market Impact Modeling for Reinforcement Learning Trading Environments (arXiv:2603.29086) — 거래비용·시장 충격을 현실적으로 반영한 거래 환경 모델링
관련 글
 포트폴리오 최적화A
거래비용이 변동하는 현실, 포트폴리오 이론이 드디어 답하다
거래비용이 고정이 아니라 시장 상황에 따라 변동하는 현실을 반영한 포트폴리오 이론. 확률적 거래비용 하에서도 시장 대비 초과 성과를 보장하는 새로운 수학적 프레임워크를 소개합니다.
 강화학습 포트폴리오
가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.
 포트폴리오 최적화A
CVaR를 이긴 엑스펙타일 포트폴리오: Wasserstein 강건 최적화로 따져보니
리스크 측도를 CVaR에서 엑스펙타일(expectile)로 바꾸고 분포 불확실성까지 반영한 포트폴리오 최적화가 FTSE 13년 실증에서 9개 조합 전부 이겼다. 엑스펙타일의 백테스트 가능성, 지름자 선택, 퇴화 임계값까지 쉽게 풀어 설명한다.