
Importance Sampling Enhanced with the COS Method for the Portfolio Risk Allocation
Fang Fang, Xiaoyu Shen, Qinling Wang
"100년에 한 번 일어날 손실을 계산하려면, 100년치 데이터가 아니라 '일어나기 쉬운 조건'에서 표본을 뽑으면 된다. 그런데 그 조건을 맞추는 방식이 서툴면, 시뮬레이션 25만 번도 사실상 표본 몇 개 값이다. 이 논문은 그 조건 맞추기를 '합격/불합격' 대신 '확률의 모양'으로 하면 정보량이 두 배로 늘어난다는 걸 보여 준다."
들어가며: 100년 만의 홍수를 미리 시뮬레이션하는 방법
기상청이 '100년 만의 홍수'를 대비하려면 어떻게 해야 할까요? 지난 100년의 관측만으로는 한두 번 올까 말까 한 극단 사건을 제대로 알 수 없습니다. 그래서 컴퓨터로 비가 오는 날씨를 수십만 번 '가상 실행'해 보는 겁니다. 문제는, 가상 실행 25만 번 중에 홍수가 실제로 일어나는 경우는 손에 꼽을 만큼 적다는 것. 그러면 "홍수가 났을 때 물이 얼마나 차오르나"를 계산할 데이터가 사실상 없는 셈입니다.
금융에서도 똑같은 문제가 생깁니다. 신용 포트폴리오 — 여러 회사의 채권을 잔뜩 들고 있는 포트폴리오 — 에서 "100개 회사 중 20개가 한꺼번에 부도날 확률"은 극히 낮지만, 일어나면 자본을 쓸어가는 손실입니다. 은행과 운용사는 이 희귀 손실의 크기(VaR, CVaR 같은 지표)와 '누가 이 손실의 주범인가'(채무자별 기여도)를 알아야 자본 배분과 헤지를 할 수 있습니다.
이때 쓰는 대표 기법이 중요도 샘플링(importance sampling)입니다. 핵심 아이디어는 단순합니다. 평소에는 잘 일어나지 않는 조건을 인위적으로 자주 만들고, 나중에 수학적 가중치로 원래 세계로 되돌려 보정하는 것. 마치 100년 만의 홍수를 연구하기 위해 일부러 폭우 조건에서만 날씨를 시뮬레이션하는 것과 같습니다. 다만 보정이 까다로워서, 조건을 잘못 잡으면 오히려 계산이 더 불안정해집니다.
2026년 8월 네덜란드 FF Quant Advisory와 TU Delft 연구진이 올린 이 논문은, 중요도 샘플링의 '조건 잡기(보정)' 단계를 한 단계 정교하게 만드는 방법 ISCOS를 제안합니다. 결론부터 말하면, 동일한 계산 예산에서 유용한 정보량(유효 표본 수)이 최대 약 2배, 추정 구간은 최대 27% 좁아졌고, 총 계산 시간은 4% 정도만 늘었습니다. 그리고 무엇보다 "무엇을 조심해야 하는가"를 저자가 솔직하게 정리한 논문이라, 실무자에게 특히 유용합니다.
무엇이 문제였나: '합격/불합격'으로는 극단 사건을 배울 수 없다
중요도 샘플링의 표준적인 구현 중 하나가 교차엔트로피 중요도 샘플링(CEIS, Cross-Entropy Importance Sampling)입니다. 작동 방식을 쉽게 말하면 이렇습니다.
- 먼저 가상 실행(파일럿 시뮬레이션)을 대규모로 돌립니다.
- 그중 '손실이 임계값을 넘은' 실행만 골라 봅니다. 이때 쓰는 정보가 바로 0/1 지시자 — "사건이 일어났다(1)/안 일어났다(0)".
- 이 1인 실행들의 공통점을 보고 "꼬리사건이 일어날 때는 이런 조건이 우세하구나" 하고 제안 분포를 조정합니다.
- 조정된 분포로 다시 표본을 뽑아 희귀 손실을 추정합니다.
문제는 2단계에 있습니다. 임계값이 극단적일수록 파일럿에서 사건이 '1'인 표본이 아주 적습니다. 예를 들어 99.9% 신뢰수준의 손실을 찾으려면, 25만 번 실행해도 넘는 경우가 수백 개쯤에 불과할 수 있습니다. '합격자 수십 명'만 보고 시험 전체의 난이도를 맞추는 격이라, 구한 제안 분포가 흔들리기 쉽습니다. 이 흔들림은 나중에 계산의 유효 표본 수(ESS) — 가중치가 고르게 퍼져 있어 실제로 정보를 주는 표본의 개수 — 를 떨어뜨립니다. 시뮬레이션을 25만 번 돌려도, 소수 표본이 가중치를 독식하면 실제 정보량은 표본 몇 개 수준으로 줄어듭니다.
핵심 아이디어: 0과 1 대신 '확률의 부드러운 곡선'을 쓰자
ISCOS는 이 0/1 지시자를 조건부 확률의 근사값으로 바꿉니다. 쉽게 말하면 "이 조건이면 손실이 임계값을 넘을 확률이 몇 퍼센트인가"라는 0과 1 사이의 부드러운 값을 파일럿의 모든 표본에 대해 계산하는 것입니다. '합격/불합격 결과만 있는 시험'을 '문제별 정답 확률을 아는 시험'으로 바꾸면, 틀린 학생에게서도 정보를 얻을 수 있는 것과 같은 이치입니다.
그런데 이 확률을 어떻게 효율적으로 계산할까? 여기에 두 가지 수학적 지렛대가 쓰입니다.
- 조건부 독립: 시장 전체를 움직이는 공통 요인(금리, 경기 등)이 정해지면, 각 회사의 부도는 서로 독립이 됩니다. 덕분에 포트폴리오 전체 손실의 특성함수(푸리에 변환 세계에서 분포를 나타내는 함수)를 닫힌 형식으로 쓸 수 있습니다.
- COS 방법(COS, Fourier-cosine method): 이 특성함수를 코사인 급수로 풀어 확률값을 빠르게 구하는 기법입니다. 옵션 가격 계산에서 오래 쓰인 검증된 도구인데, 이 논문은 그것을 '조건부 꼬리확률' 계산에 끌어온 것입니다.
이렇게 하면 추가 부도 시뮬레이션 없이 매끄러운 가중치를 얻을 수 있고, 저자는 이 가중치로 맞춘 제안 분포를 ISCOS라고 부릅니다. 논문은 가우시안 코퓰라(상관 구조 모형)에는 가우시안 제안 분포를, 두꺼운 꼬리를 가진 Student t 코퓰라에는 가우시안-역감마 곱 제안 분포를 각각 유도합니다.
이론적으로도 깔끔한 결과가 있습니다. 정확한 조건부 확률을 쓴다면 ISCOS의 보정치는 기존 CEIS 보정치의 라오-블랙웰화(Rao-Blackwellisation) — 통계학에서 '중간 단계를 확률로 평균 내면 추정이 안정된다'는 고전적 기법 — 이며, 분산(공분산 행렬)이 결코 커지지 않습니다. 그리고 COS 근사가 쓰이므로 생기는 오차까지 포함해, 총 보정 오차가 파일럿 표본 크기의 제곱근 역수 + COS 근사 오차로 깔끔하게 분해됨을 증명합니다. 쉽게 말하면 "표본을 늘리면 어디까지 좋아지고, 급수 항을 늘리면 어디까지 좋아지는가"를 수학적으로 가르쳐 주는 셈입니다.
결과 — 무엇을 알아냈나
실험은 신용리스크 계산의 고전적인 벤치마크(Glasserman의 예제)를 씁니다. 회사 100개를 10개 묶음으로 나누고, 각 회사 부도확률 1%, 회사마다 손실 규모(1, 4, 9, 16, 25 중 하나)를 주고, 시장 요인 10개 + 공통 요인 1개로 상관을 만드는 구성입니다. 99.9% 신뢰수준의 손실 임계값은 250, 파일럿과 본 시뮬레이션에 각각 25만 개 표본을 쓰되 두 방법에 완전히 같은 예산을 배분했습니다. 비교 대상은 표준 CEIS, 고전적 벤치마크인 Glasserman 방법, 그리고 ISCOS입니다.
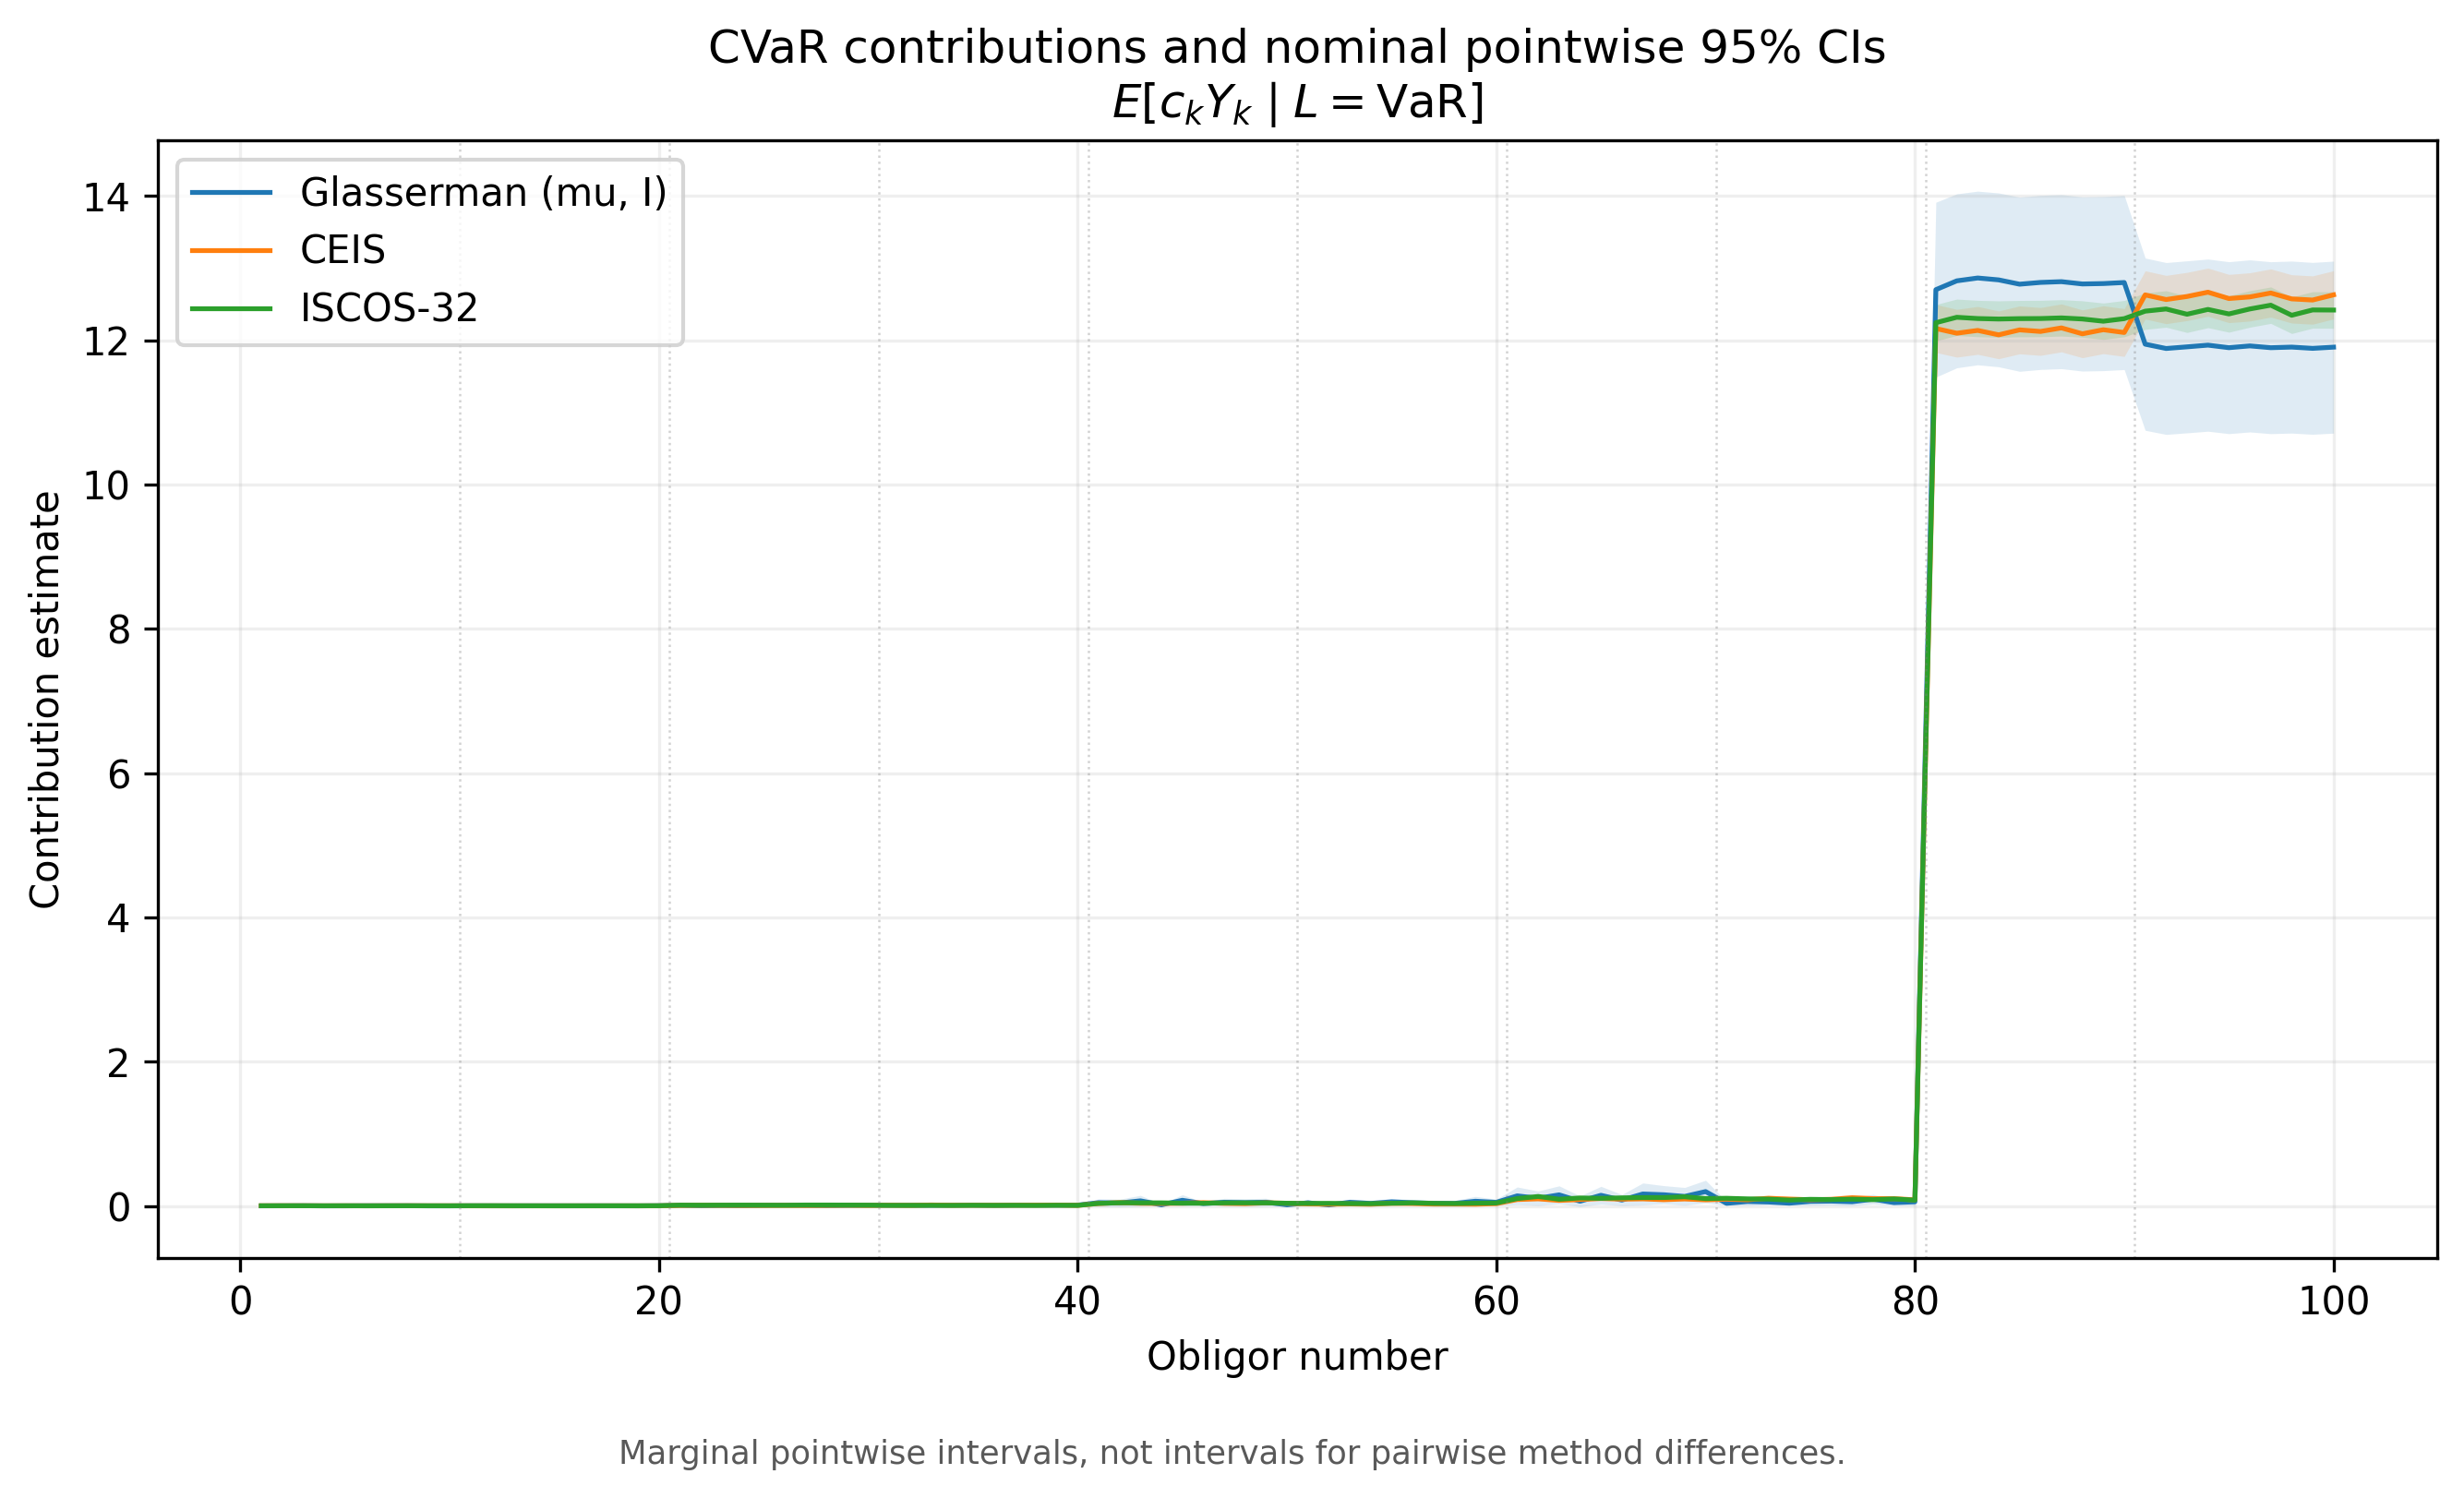
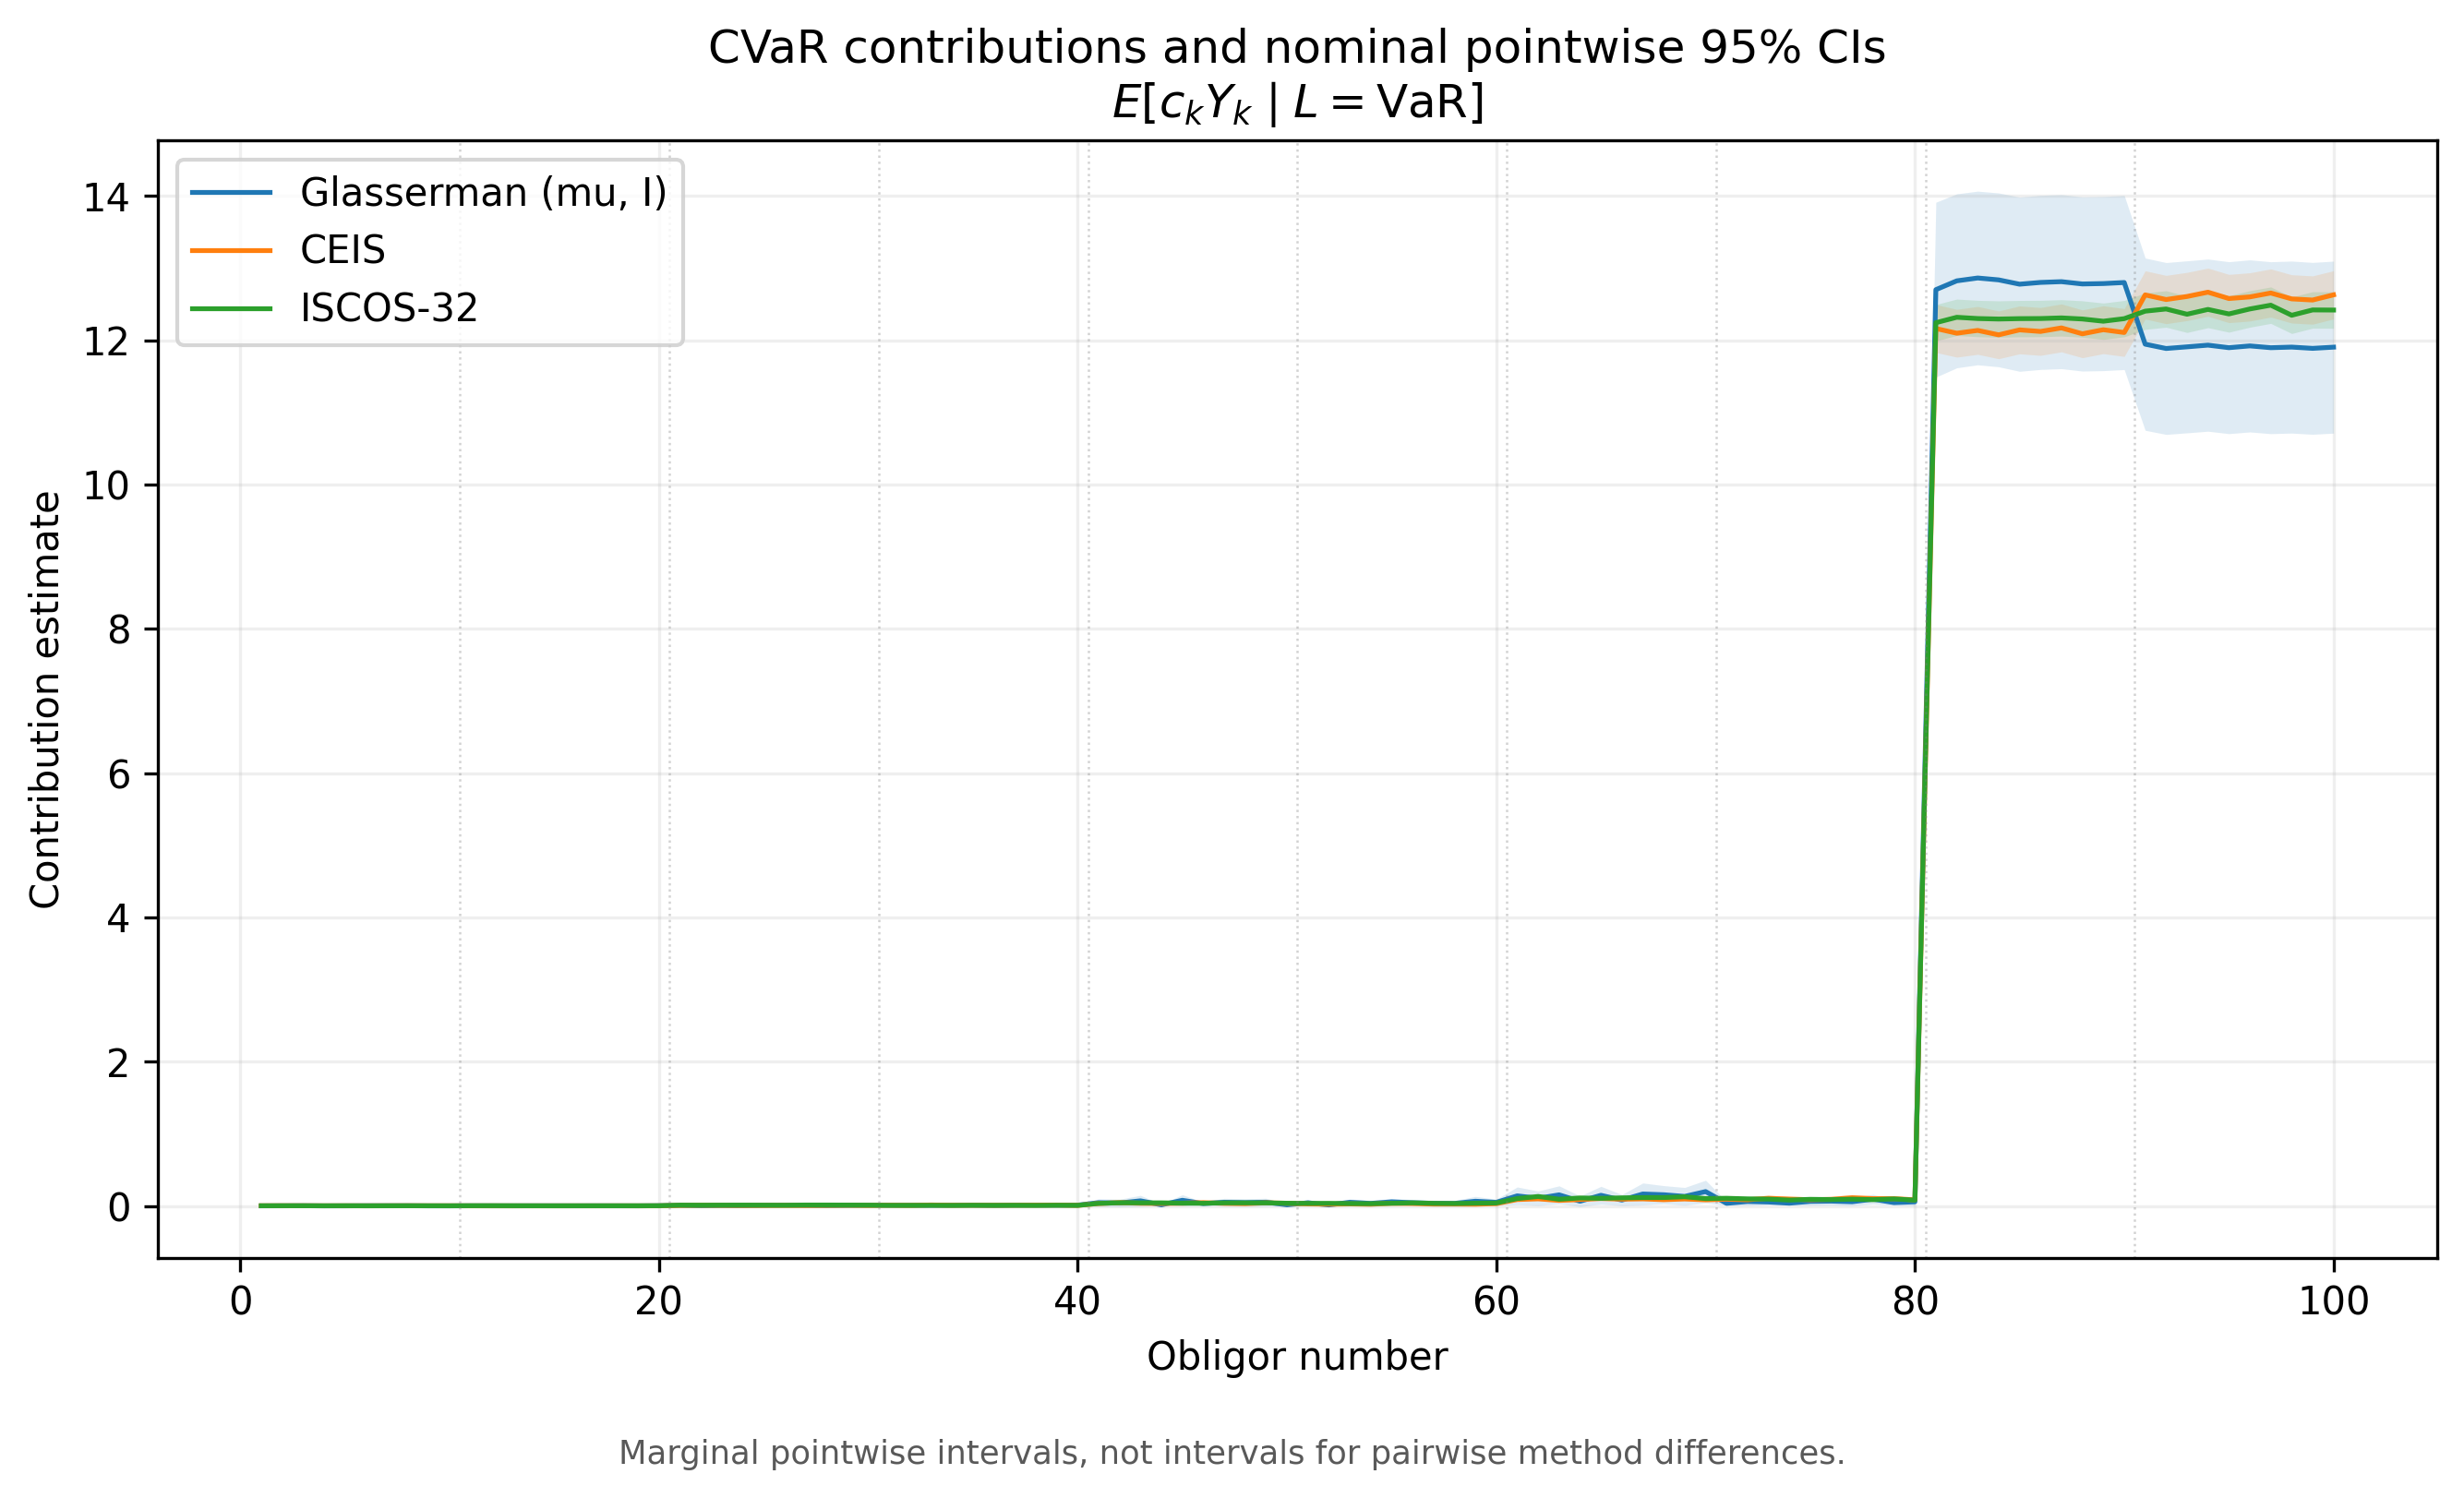
1. 정보량(ESS)이 크게 늘었다. 가우시안 코퓰라 실험에서 ISCOS의 캘리브레이션 ESS는 9,404.8로 CEIS의 5,337.8의 2배 이상이었습니다. 최종 추정에서 쓰이는 사건 가중치의 ESS도 정확레벨 사건에서 76.2%, 꼬리사건에서 54.7%(29,354.6 → 45,413.0) 늘었습니다. 흥미로운 점은, 단순히 '사건을 더 자주 맞힌' 게 아니라는 것입니다. 사건 적중률은 오히려 ISCOS(13.16%)가 CEIS(13.87%)보다 약간 낮은데도, 가중치가 고르게 퍼져서 정보량이 늘었습니다. 여론조사 응답자 몇 명이 표본을 독식하는 대신, 모두가 비슷한 기여를 하는 셈입니다. 참고로 고전적 Glasserman 방법은 적중률은 높지만 가중치가 쏠려 ESS가 402.5에 그쳤습니다.
2. 추정 구간이 좁아졌다. 채무자별 기여도 추정의 평균 구간 반길이(불확실성의 절반 폭)는 CVaR에서 21.4%, 꼬리평균(CES)에서 22.7% 줄었습니다. 다만 솔직한 제한도 함께 보고됩니다. CVaR의 경우 채무자 100명 중 ISCOS 쪽 구간이 좁은 경우는 50명으로 거의 절반이고, CES에서만 99/100으로 뚜렷합니다.
3. 큰 숫자는 서로 일치한다. 두 방법 모두에서 추정한 사건확률(정확레벨 약 0.0002730.000277, 꼬리사건 약 0.00110.0012)과 채무자별 기여도 벡터(차이 CVaR 1.52%, CES 0.39%)가 거의 같습니다. 즉 값은 틀리지 않으면서 불확실성만 줄인 것입니다.
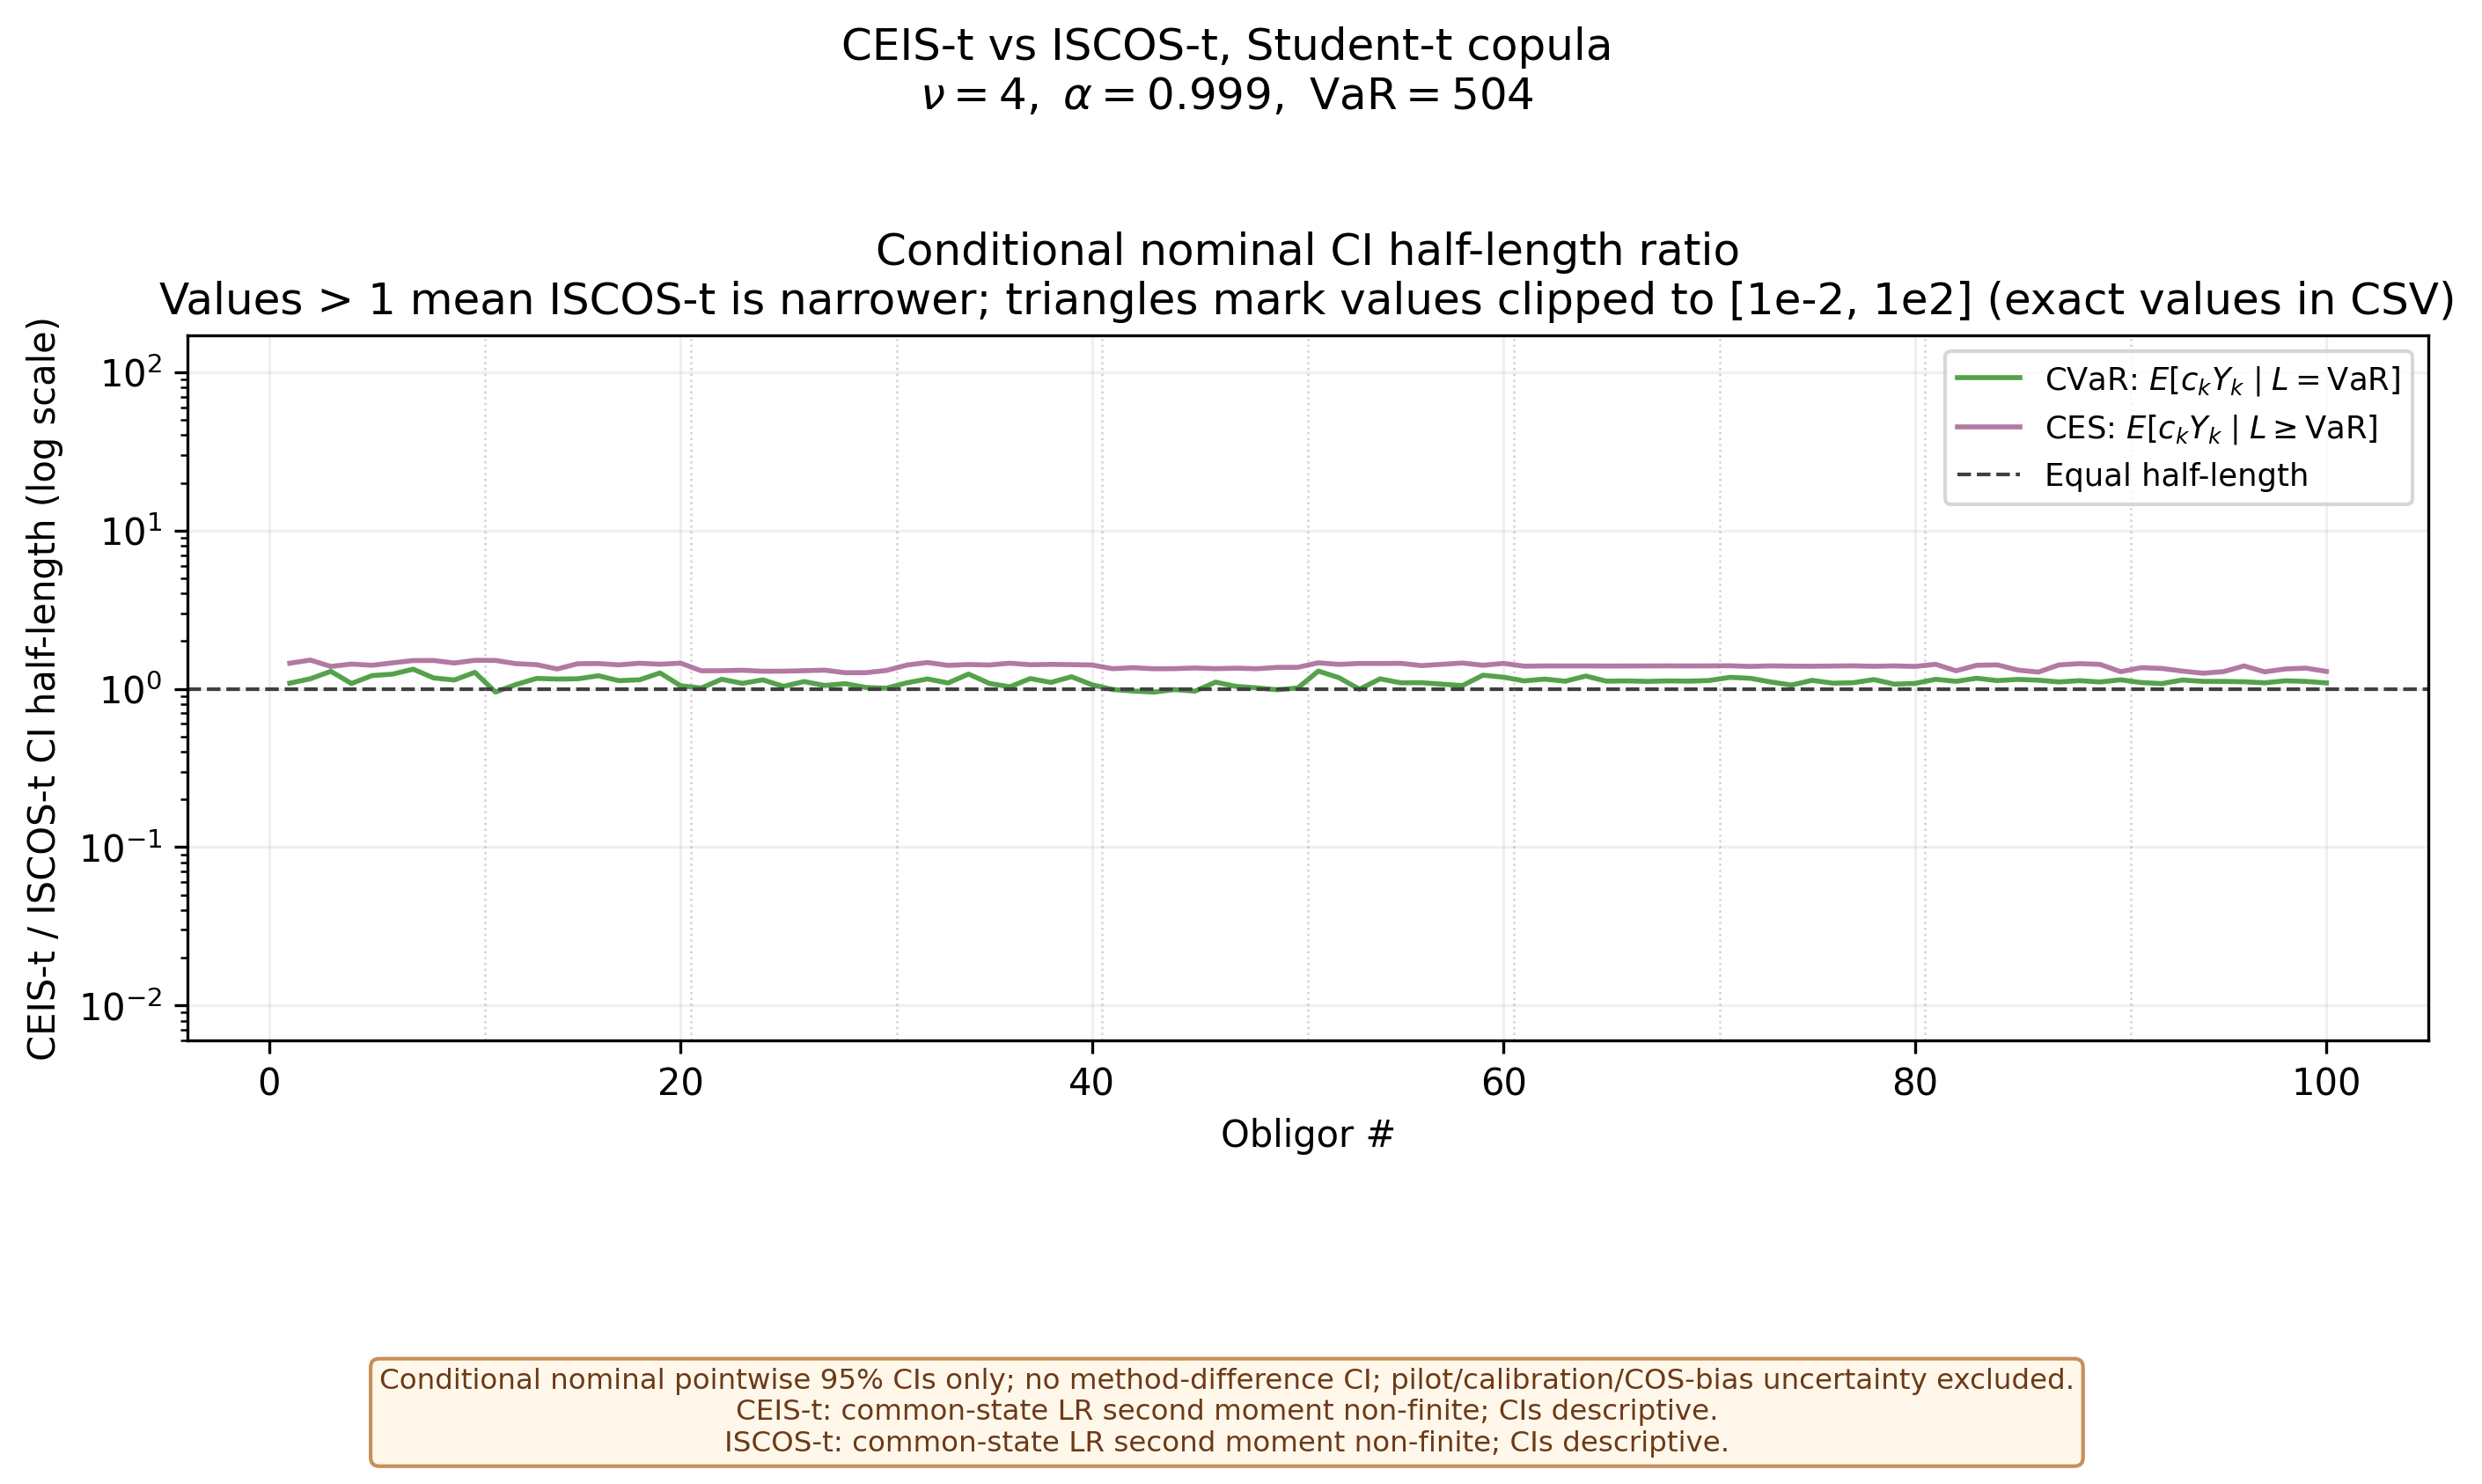
4. 두꺼운 꼬리(Student t)에서도 통한다. 상관 구조에 두꺼운 꼬리를 가진 더 어려운 설정에서 ISCOS-t는 CEIS-t 대비 캘리브레이션 ESS +38.6%, 꼬리사건 ESS +93.8%(22,688.8 → 43,964.5)를 기록했고, 꼬리평균 구간 반길이는 27.0%(0.06891 → 0.05031) 줄었습니다. 아래 그림은 채무자별로 'CEIS 구간 폭 ÷ ISCOS 구간 폭'을 그린 것으로, 1보다 크면 ISCOS 쪽이 더 좁다는 뜻입니다. CES 곡선이 1 위에서 뚜렷하게 분리되어 있는 것이 개선 효과를 직관적으로 보여 줍니다.
5. 계산 비용은 거의 그대로다. 가우시안 실험에서 세 방법의 총 소요시간은 모두 약 96~97초로 거의 같았고, Student t에서 ISCOS-t는 186.2초 → 194.2초로 4.3% 늘어나는 데 그쳤습니다. 조금 더 내고 두 배의 정보량을 사는 셈입니다.
한계와 주의점 — 저자가 직접 밝힌 것들
이 논문은 자기 실험의 약점을 숨기지 않습니다. 실무 판단에 중요한 것만 정리하면:
- 단 한 번의 매치드 실험입니다. 파일럿 1회, 본 시뮬레이션 1회, 고정 임계값에서의 비교이며, 반복 실험을 통한 편향·분산·커버리지·평균제곱오차는 추정하지 않았습니다. "언제나 2배"가 아니라 "이 구성에서 2배"로 읽어야 합니다.
- 구간은 모두 '명목상'입니다. 파일럿에서 임계값을 추정한 불확실성, 제안 분포 보정의 불확실성, 유한 급수 근사 오차가 구간에 포함되어 있지 않습니다.
- 가장 중요한 경고: CEIS의 CES 가중치는 이 구성에서 2차 모멘트가 무한합니다. 저자가 직접 증인을 구해 입증했습니다. 즉 CEIS 쪽 꼬리평균 구간은 통계적으로 유효한 신뢰구간이 아니라 '이번 계산에서 흔들린 정도'를 보여 주는 지표에 불과합니다. 구간 비교를 '통계적 유의성 검정'처럼 읽으면 안 되는 이유입니다.
- Student t 실험에는 정확한 답(조건부 벤치마크)이 없습니다. 그리고 가우시안-역감마 곱 제안 분포는 꼬리사건이 만드는 요인 간 의존성을 표현하지 못하며, 적합된 척도 분포도 논문이 요구한 2차 모멘트 조건을 통과하지 못했습니다(두 제안 모두). 저자는 이 구간들도 '명목상'이라고 강조합니다.
- 실험 범위가 좁습니다. 표준 신용 포트폴리오 벤치마크 하나, 코퓰라 모형 가정, 유한 채무자 구조. 주식·상품 포트폴리오나 실전 데이터 검증은 이 논문의 몫이 아닙니다. 계산 시간 측정도 하드웨어 정보가 없는 단일 실행이라 '벤치마크'가 아니라 '대략적 비교'입니다.
그래서 투자/실무엔?
- 신용 포트폴리오 리스크 계산을 빠르고 안정적으로. 회사채·커버드본드 같은 신용 익스포저의 VaR/ES와 채무자별 꼬리 기여도는 자본 배분과 리스크 한도의 기초 데이터인데, 희귀사건 시뮬레이션 탓에 계산 비용이 항상 발목이었습니다. 같은 예산에서 정보량이 늘면, 더 자주 업데이트하거나 더 많은 시나리오를 돌릴 여지가 생깁니다.
- CDO/CLO 같은 구조화 신용상품. 상위 트랜치처럼 '거의 일어나지 않는 손실'의 가격·위험이 핵심인 영역에서 중요도 샘플링은 필수인데, 이 논문은 그 보정 단계의 실질적 개선을 구체적 수치로 보여 줍니다.
- 더 근본적인 교훈은 '부드러운 정보'의 힘입니다. '사건 발생 여부'라는 거친 정보 대신 '조건부 확률'이라는 매끄러운 정보를 쓰면 추정이 안정된다는 원리는 신용 외의 희귀 리스크 — 운영리스크, 보험 부채, 극단 손실 백테스트, 스트레스 테스트 — 에도 그대로 통용됩니다.
- 그리고 하나의 체크리스트. 중요도 샘플링 기반 리스크 수치를 볼 때는 "가중치의 2차 모멘트가 유한한가, 유효 표본 수(ESS)는 얼마인가"를 반드시 물어보세요. 이 논문처럼 ESS가 수백 수준이라면, 아무리 표본을 많이 돌려도 구간은 넓을 수밖에 없습니다.
더 알아보기
- 원문: Importance Sampling Enhanced with the COS Method for the Portfolio Risk Allocation (arXiv:2608.30749) — Fang Fang, Xiaoyu Shen, Qinling Wang (FF Quant Advisory B.V. / Delft University of Technology), 2026년 8월 31일 게재 [q-fin.CP], CC BY 4.0.
- 5차원 점수 (OHSE AI Lab KB 평가, 참고용): 참신성 74 · 적용성 78 · 엄밀성 72 · 재현성 38 · 통찰 70 — 종합 68.3 (A등급). 재현 벤치마크가 공개 표준(Glasserman 예제)이고 실험 설정이 상세하지만, 코드 공개는 확인되지 않아 재현성 점수는 낮습니다.
- 관련 논문 (KB 엔티티 기반):
- Efficient Black-Box Importance Sampling for VaR and CVaR Estimation (arXiv:2106.10236) — 모형을 가정하지 않는 블랙박스 중요도 샘플링으로 VaR/CVaR 추정.
- Portfolio risk allocation through Shapley value (arXiv:2103.05453) — 게임이론적 분배로 포트폴리오 리스크 기여도를 나누는 접근.
- Multilevel Richardson-Romberg and Importance Sampling in Derivative Pricing (arXiv:2209.00821) — 파생상품 가격 계산에서 다중 수준 기법과 중요도 샘플링을 결합.
관련 글
 포트폴리오 최적화A
포트폴리오 최적화, 어렵게 풀 필요 없이 LASSO 한 번으로 — 효율적 프런티어의 놀라운 등가성
머신러닝에서 흔히 쓰는 변수 선택 도구 LASSO가 마코위츠의 효율적 프런티어를 그대로 그려 준다는 연구를 쉽게 풀어 설명합니다. 포트폴리오 최적화 계산이 왜 수십 배 빨라지는지, 그리고 주의할 한계까지 정리합니다.
 고빈도 트레이딩(HFT)A
HFT 시스템 설계, 단일 스레드 법칙을 뒤집은 CME 1년 측정 연구
CME 나스닥 선물 시장 데이터 1년치를 패킷 단위로 추적한 측정 연구를 쉽게 풀어봅니다. 고빈도 트레이딩 시스템의 단일 스레드 설계 법칙은 언제 뒤집히는가, 마이크로초 지연 꼬리의 진짜 원인은 무엇인가 — 초 단위가 아닌 마이크로초의 세계에서 벌어지는 일들입니다.
 LLM 트레이딩 에이전트A
알파 팩터 마이닝 LLM 에이전트: 로컬 훈련으로 탐색 다양성을 되살리다
LLM 멀티 에이전트로 알파 팩터를 자동 발굴하면서도 같은 아이디어만 반복하는 연구 경로 붕괴를 극복하고, 외부 API 없이 로컬 모델로 훈련한 AlphaDiverse 논문을 쉽게 설명합니다. 예측 성능과 탐색 다양성을 함께 얻은 비결과 한계를 짚어봅니다.