매달 arXiv에 쏟아지는 금융 연구 논문 중에서 가장 의미 있는 연구를 골라 정리합니다. 이번 글은 2017년 5월에 공개된 논문들을 지금의 눈으로 다시 읽은 회고 리뷰입니다.
한 줄 요약: "위험을 어떻게 정의하는가가 포트폴리오를 바꾼다" — 분산 대신 엔트로피를 쓰면 성과가 좋아지고, 시장을 하나의 수식으로 묶으면 시장을 이기는 조건이 보이며, 은행들이 서로 얼마나 많이 빌려주었는지를 알면 붕괴의 시점이 수학으로 잡힙니다.
들어가며: "AI가 오기 전", 금융 수학이 한창이던 시절
2017년 5월을 기억하시나요? 알파고가 이세돌 9단을 꺾은 지 1년이 조금 지난 때였고, "AI 트레이딩"은 아직 신문 기사의 단골 소재에 불과했습니다. arXiv 금융 논문들의 무기는 인공지능이 아니라 확률미적분과 최적제어 이론이었죠.
하지만 이 "구식" 논문들이 묻는 질문들은 2026년의 우리에게 그대로 도착합니다. 아무리 예측 모델이 정교해도 거래비용이 이익을 다 먹어치우면 소용없고, 아무리 좋은 포트폴리오 이론이 있어도 "분산"만 보면 크래시의 날을 대비할 수 없으며, 한 은행이 무너지면 다른 은행들이 줄줄이 무너지는 구조를 이해하지 못하면 시스템 전체의 위험을 놓칩니다.
2017년 5월의 코호트는 논문 63편(우리 기준 관련 논문 48편)이고, A등급 11편 중 7편이 포트폴리오 최적화에 모여 있습니다. 한마디로 "위험의 정의를 다시 쓰는 작업"이 한창이던 달입니다. 다섯 개 테마로 정리했습니다.
테마 1: 분산만 보지 말자 — 엔트로피로 위험을 재정의하다
일상 비유로 시작하자면
체중계만 보고 건강을 판단하면 놓치는 게 많습니다. 같은 70kg이라도 근육형과 복부비만형은 완전히 다른 건강 상태니까요. 포트폴리오의 "위험"을 분산(변동의 폭) 하나로 보는 것도 비슷합니다. 자산 수익률은 실제로는 가운데가 뾰족하고 양쪽 꼬리가 두꺼운, 종 곡선과는 다른 모양을 갖습니다. 변동의 폭은 같아도 "얼마나 자주, 얼마나 크게 깨지는가"가 다른 거죠.
대표 논문: Minimum Rényi Entropy Portfolios (1705.05666)
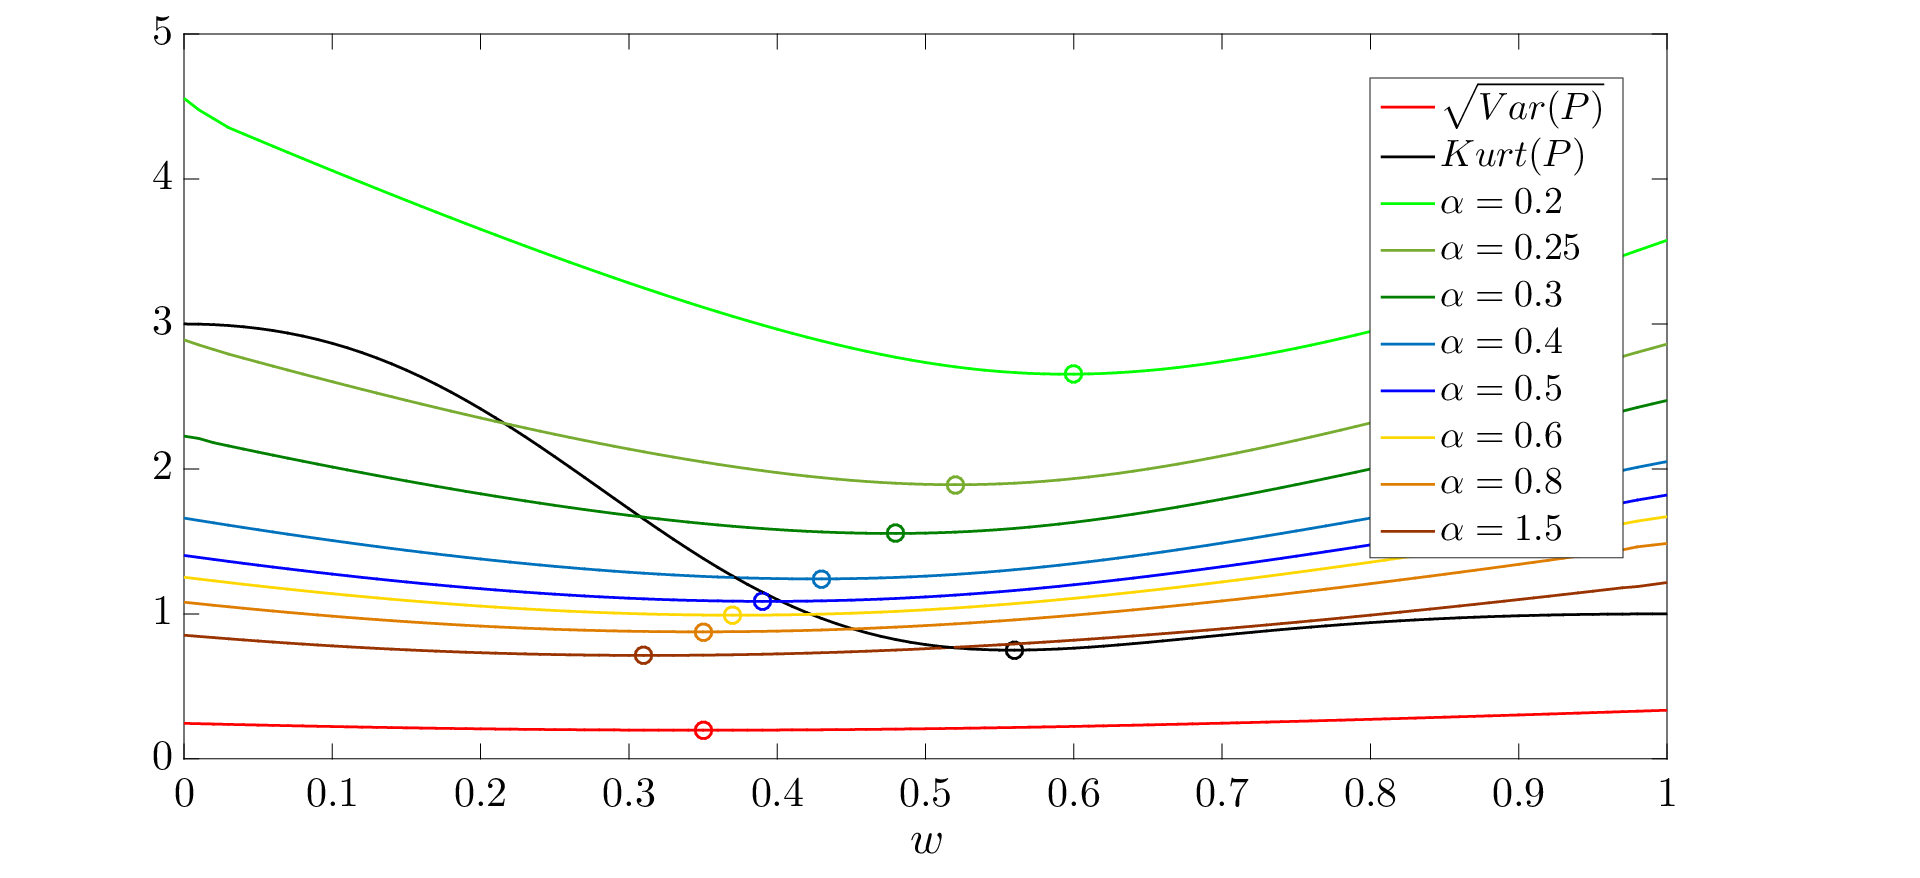
벨기에 루뱅 대학의 Lassance와 Vrins이 쓴 이 논문(복합점수 68.0)은 위험을 "수익률에 담긴 무작위성의 양"으로 재정의합니다. 정보 이론에서 쓰는 엔트로피라는 척도를 빌려온 건데, 여기에 레니(Rényi)라는 변형을 적용하면 매개변수 하나(α)로 "중심(분산)을 더 볼까, 꼬리(첨도)를 더 볼까"를 조절할 수 있습니다.
핵심 아이디어를 세 줄로 정리하면:
- 위험 = 엔트로피: 포트폴리오 수익률 분포의 "무작위성"이 클수록 위험하다. 분산만 보는 게 아니라 분포 전체 모양을 봅니다.
- α가 대역폭 조절: 수학적으로 확인해 보면(그램-샤를리에 전개), α는 "분산 최소화 대 첨도 최소화"의 가중치 역할을 합니다. α가 작을수록 꼬리에 민감해집니다.
- 강건한 추정: 엔트로피를 데이터에서 추정할 때 이상치에 흔들리지 않는 m-간격(m-spacings) 추정량을 씁니다. 데이터 120개 기준 m = 24로 묶어 계산하면, 튀는 값 하나가 최적 비중을 뒤흔들지 않습니다.
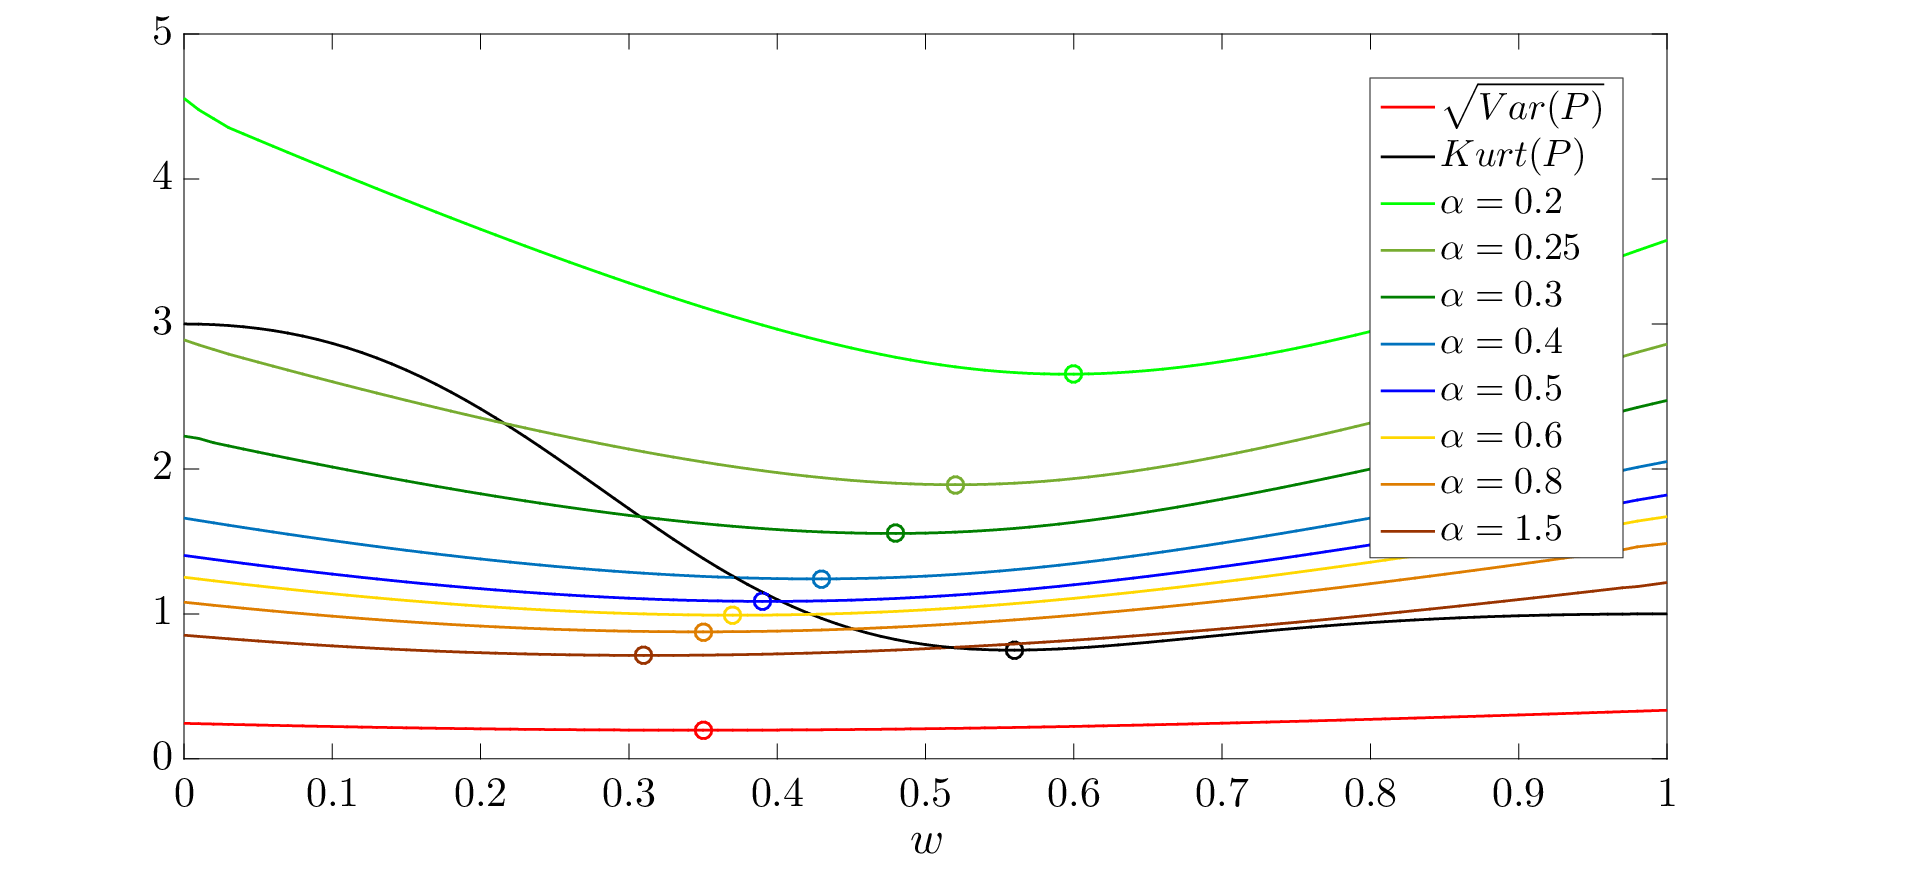
결과가 인상적입니다. Kenneth French 라이브러리의 6개 표준 데이터셋(규모·장부가치 6/25개, 모멘텀 6/25개, 업종 10/17개)에 월간 수익률(1963년 7월~2016년 6월)을 적용하고, 10년 추정창으로 43년간 표본외(out-of-sample)로 굴렸습니다.
| 전략 | 6개 데이터셋 평균 샤프비율 | 평균 회전율 |
|---|---|---|
| 최소 엔트로피 (α = 0.3) | 0.911 | 0.360 |
| 최소 엔트로피 (α = 0.7) | 0.913 | 0.427 |
| 최소분산 (최고 벤치마크) | 0.890 | 0.323 |
| 최소분산 (평균) | 0.886 수준 | 0.32 수준 |
- 분산 대신 엔트로피를 최소화하면 43년 내내 샤프비율이 일관되게 더 높았습니다(평균 0.911
0.915 대 0.8820.891). - 회전율(리밸런싱 규모)은 α = 0.3에서 최소분산 대비 겨우 약 4%p 높은 수준이라, 거래비용이 크게 들지 않습니다.
- 반면 α를 1보다 크게(1.5, 2) 하면 오히려 성과가 나빠졌습니다(평균 샤프 0.886 / 0.863). 꼬리를 "선호"하는 방향으로 최적화되기 때문입니다.
- 저자들의 권장: α ≈ 0.3 부근이 위험·수익·회전율의 균형점.
한계도 분명합니다. 최적화 문제가 일반적으로 볼록하지 않아 전역 탐색에 의존하고, 엔트로피가 통계학에서 말하는 "일관된 위험 척도"(손실을 합칠수록 위험이 커진다는 성질)를 항상 만족하지는 못합니다. 실증도 미국 월간 주식 데이터에 한정됩니다.
공통 인사이트: 위험 측정의 정의를 바꾸면 최적 포트폴리오가 바뀐다. 분산만 보는 시스템은 "평소엔 멀쩡하지만 가끔 크게 깨지는" 포트폴리오를 만들어낼 수 있다.
같은 테마에서, CVaR(조건부 가치위험) 제약을 만족하면서도 자산이 가장 빨리 불어나는 온라인 포트폴리오 전략을 제안한 연구(1705.09800), "비중의 점추정"이 아니라 비중의 불확실성 분포 전체를 베이지안으로 계산해 파산 위험까지 정량화한 연구(1705.06533), 1968년 Black이 남긴 최적 투자 방정식을 현대적으로 해석한 연구(1705.07472)도 같은 문제의식을 공유합니다.
테마 2: 시장 전체를 하나의 수식에 담다
비유로 시작하면
지도를 그리려면 도시마다 일일이 표시할 수도 있지만, "해안선은 이러하고 강은 저렇다"는 규칙을 찾을 수도 있습니다. 주식 시장도 그렇습니다. 수백 개 종목을 각각 예측하려 하기보다, "시가총액이 어떻게 분포하고 어떻게 움직이는가"라는 시장 전체의 규칙을 찾으면 시장을 이기는 포트폴리오의 조건이 수학으로 따라옵니다.
대표 논문: Polynomial processes in stochastic portfolio theory (1705.03647)
이 달 최고 점수(복합점수 71.7)를 받은 비엔나 대학 Cuchiero의 이 논문은, 시장의 두 가지 양 — 기업의 시가총액과 그 기업이 시장에서 차지하는 비중(시장가중치) — 을 동시에 모델링합니다.
- 기존의 명작 모형(Fernholz–Karatzas의 변동성 안정화 모형)은 아름답지만 치명적 제약이 있었습니다: 종목 간 상관이 0이라는 비현실적 가정.
- 이 논문은 다항 과정(polynomial process)이라는 도구로 상관을 허용하면서도 계산 가능한 모형을 만듭니다. 다항 과정의 묘미는 평균·분산·공분산 같은 모멘트가 지수행렬 계산만으로 나온다는 점 — 수백 개 종목의 데이터로 모형을 맞추는 작업(캘리브레이션)이 실무적으로 가능해집니다.
- 저자들은 실제로 동반 연구에서 MSCI World 300종목에 캘리브레이션해, 시장에서 부(富)가 어떻게 분포하는지 보여 주는 "자본분포곡선"의 실제 형태와 변동을 잘 재현했다고 보고합니다.
- 수학적 하이라이트: 특정 파라미터 조건 하에서 시장 포트폴리오를 체계적으로 이기는 전략(상대적 차익거래)이 존재할 수 있음을 증명합니다. "작은 종목일수록 변동성이 크다"는 시장의 비대칭 구조가 그 원동력입니다.
한계: 본 논문은 이론 논문이라 실증 검증은 동반 논문에 의존하고, 코드·데이터 공개는 없습니다. 그래도 "고차원 시장 모형을 계산 가능하게 만든다"는 기여는 이후 포트폴리오·리스크 연구의 토대로 남았습니다.
공통 인사이트: 시장의 구조(누가 얼마나 큰가, 어떻게 상관되어 있는가)를 모형에 담으면 "무리한 예측 없이도 시장을 이길 수 있는 조건"이 보인다.
같은 테마에서, 파생상품의 그릭스(민감도)를 이용해 거래가 어려운 지수의 목표 노출을 동적으로 맞추는 연구(1705.10454), "은퇴에 가까워지면 주식을 자동으로 줄인다"는 타깃데이트 펀드의 글라이드패스가 오히려 하방 위험을 키울 수 있다고 경고한 연구(1705.00543), 장기 투자를 소수 펀드로 단순화한 프레임워크(1705.03929)가 함께 읽히면 좋습니다.
테마 3: 분산스왑을 "옵션 몇 개"의 문제로 환원하다
비유로 시작하면
비 오는 날을 완벽하게 대비하려면 하늘의 모든 구름을 추적해야 하지만, 실전에 필요한 건 우산입니다. 변동성 파생상품의 가격결정도 비슷합니다: "앞으로의 변동성 전체"를 거래하려면 복잡한 모형이 필요하지만, 좋은 이론은 그것을 이미 시장에 있는 단순한 계약 몇 개의 문제로 바꿔 줍니다.
대표 논문: Pricing Variance Swaps on Time-Changed Markov Processes (1705.01069)
Peter Carr(NYU), Roger Lee(시카고대), Matthew Lorig(워싱턴대)의 이 논문(복합점수 69.5)은 분산스왑 — "미래 변동성을 미리 정한 가격에 사고파는 계약" — 의 공정 가격을 묻습니다.
- 고전적 결과(2012년): 기초자산이 "시간이 랜덤하게 늘어졌다 줄어드는" 레비 과정이면, 분산스왑은 고정 개수의 로그 계약과 정확히 같은 값이라는 놀라운 정리가 있었습니다.
- 이 논문은 그 가정을 크게 넓힙니다: 변동성과 점프가 자산 가격 수준에 따라 변해도 되고, 시간을 늘리는 "확률적 시계"가 기초 과정과 마음대로 상관되어도 됩니다.
- 핵심 정리(Theorem 3.5): 이런 일반적 설정에서도 분산스왑의 공정 가격은 만기 시 "로그 값의 변화"를 지급하는 유럽형 계약 한 개와 같으며, 그 지급 함수는 시계와 무관하게 풀리는 방정식 하나로 결정됩니다. 시장의 "시간이 빠르게 흐르는 구간"을 걱정하지 않아도 된다는 뜻입니다.
- 흥미로운 발견: 기존 연구에서는 분산스왑 값 대 로그계약 값의 비율이 상수였지만, 상태의존 모형에서는 기초자산 가격 수준에 따라 이 비율이 변합니다. 가격이 높은 구간과 낮은 구간에서 "로그 계약 몇 개"가 달라진다는, 실무 정가(定價)에 바로 와닿는 결론입니다.
한계: 이론 논문이라 실제 시장 데이터 보정과 수치 구현이 별도로 필요하고, 연속 관측 가정을 씁니다(실제 분산스왑의 이산(離散) 샘플링 문제는 다른 문헌이 다룹니다).
공통 인사이트: 복잡한 모형에서도 "시장에 이미 있는 단순 계약의 조합"으로 환원할 수 있으면 가격결정이 실전에 쓸 수 있게 된다. 모형이 정교해질수록 환원의 기술이 중요해진다.
같은 테마에서, 점프가 있는 레비 모형에서 옵션 가격과 그릭스의 명시적 해석식을 유도한 연구(1705.05934), "채권만으로는 헤지할 수 없는 변동성 위험"이 언제 생기는지 조건을 정확히 밝힌 연구(1705.02789), 확률모형을 아예 가정하지 않고 최악의 경우 헤지 비용을 계산하는 쌍대성 이론(1705.02933)도 이 계열의 보석입니다.
테마 4: 주문장에서 벌어지는 일 — 유동성은 공짜가 아니다
비유로 시작하면
번화가에서 가게를 열면 손님이 많지만 임대료가 비싸고, 한적한 곳이면 싸지만 손님이 없습니다. 주식 거래도 마찬가지입니다. 빨리 사고 팔수록 가격이 나에게 불리하게 움직이고(가격충격), 천천히 하면 기회를 놓칩니다. 이 균형을 수학으로 잡는 것이 "실행(execution)과 시장조성(market making)"의 과학입니다.
대표 논문: Algorithmic trading in a microstructural limit order book model (1705.01446)
CentraleSupélec의 Abergel, Paris Diderot 대학의 Huré와 Pham이 쓴 이 논문(복합점수 69.0)은 현실적인 주문장(호가장) 위에서 시장조성자의 최적 전략을 계산합니다.
- 기존 연구들은 보통 "가격 과정을 먼저 정하고 주문장을 덧붙이는" 쉬운 길을 갔습니다. 이 논문은 반대로 주문장 자체를 모형으로 삼습니다: 지정가·시장가·취소 주문의 도착이 주문장 상태에 따라 달라지고(Cox 과정), 내 주문이 선착순(FIFO) 대기열의 어디에 있는지도 상태에 포함됩니다.
- 문제를 마르코프 결정 과정으로 바꿔 최적 전략을 이론적으로 특성화하고, Qknn 알고리즘(제어 무작위화 + 양자화 + 최근접이웃 회귀)으로 실제로 계산했습니다. 상태 차원이 10을 넘는 고차원 문제입니다.
- 수치 결과(시뮬레이션 주문장, 주문 강도는 실제 Alcatel-Lucent 데이터에서 추정한 형태):
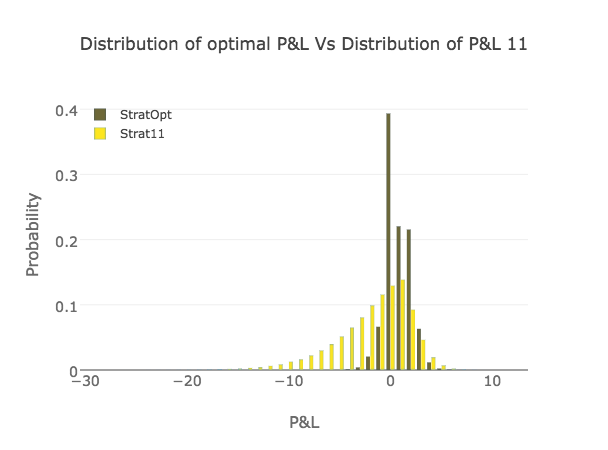
- 시장이 대칭적일 때는 "항상 양방향 1호가에 내놓는" 단순 전략도 나쁘지 않았습니다. 하지만 계산 그리드가 촘촘할수록(10^5 점) 최적 전략이 손실 꼬리를 줄였습니다.
- 주문 강도가 주문장 상태에 따라 변하면 단순 전략은 확실히 무너졌고, 최적 전략은 그리드가 커질수록(10^3 → 10^6) 성과가 체계적으로 올라갔습니다.
- 인위적으로 "가격이 오를 것 같은" 흐름을 주면, 학습된 전략은 가격이 오를 때 매도를 꺼리는 쪽으로 정책을 바꿨습니다. 추세를 제대로 읽은 겁니다.
- 소스 코드를 공개해(재현성 점수 62) 이 달 A등급 중 재현성이 가장 좋습니다.
한계: 전부 시뮬레이션 기반이라 실제 거래소 검증이 남아 있고, 최근접이웃 탐색의 계산 비용이 큽니다. "계산 예산이 전략의 품질을 결정한다"는 점은 오히려 실무적 교훈입니다.
공통 인사이트: 거래에는 눈에 보이지 않는 마찰(가격충격·대기열·유동성)이 있다. 그 마찰을 모형에 넣지 않으면 "이론적으로 최적인" 전략이 실제 돈을 잃는다.
같은 테마에서, 임시·일시적 가격충격을 동시에 고려해 최적 거래 속도를 공식으로 유도한 연구(1705.00672), 유동성이 서로 다른 자산들로 헤지할 때의 비용-위험 균형을 다룬 연구(1705.06918), 이후 수많은 LOB 예측 연구의 표준이 된 공개 벤치마크 데이터셋(1705.03233), 미니 플래시 크래시가 왜 생기는지 수학적으로 설명한 연구(1705.09827)가 이 테마를 완성합니다.
테마 5: 붕괴의 조건 — 은행은 왜 줄지어 무너지는가
비유로 시작하면
도미노를 생각해 보세요. 한 개가 넘어지면 옆을 쓰러뜨리고, 그 도미노가 또 다음을 쓰러뜨립니다. 은행 시스템의 부도 연쇄도 비슷하지만, 한 가지가 더 있습니다: 은행들은 서로에게 돈을 빌려주고 있어서, 한 곳이 무너지면 남은 은행의 자산 가치가 동시에 깎입니다. 즉, 도미노가 넘어질 때 바닥 자체가 흔들리는 겁니다.
대표 논문: Particle systems with singular interaction through hitting times (1705.00691)
미시간 대학의 Nadtochiy와 프린스턴 대학의 Shkolnikov이 쓴 이 논문(복합점수 65.0)은 "부도 연쇄가 언제 폭발하는가"를 임계 조건의 수학으로 답합니다.
- N개 은행의 자산가치가 각각 확률적으로 움직이다가, 일정 수준(장벽) 아래로 떨어지면 부도합니다.
- 한꺼번에 k개 은행이 부도하면, 남은 은행의 자산가치는 (1 − k/S)^(−C)만큼 깎입니다. 여기서 C가 바로 "상호 익스포저", 은행들이 서로에게 얼마나 많이 빌려주었는가를 나타내는 0과 1 사이의 수치입니다. C가 클수록 연결이 촘촘합니다.
- 은행이 수없이 많아지는 극한(N → ∞)에서 이 시스템은 하나의 깔끔한 방정식("평균장 극한")으로 수렴하며, 총손실 과정이 갑자기 점프하는 순간이 곧 시스템 위기입니다. "위기가 무엇인가"를 외부 정의가 아니라 시스템 내부에서 정의한 겁니다.
- 핵심 결과: 부도 직전(자산이 0에 바짝 근접)까지 몰린 은행들의 밀도가 "상수 ÷ C"(C는 상호 연결성)를 넘는 순간, 연쇄 붕괴가 반드시 발생합니다. 다시 말해 위기는 (1) 얼마나 많은 은행이 벼랑 끝에 있는가, (2) 은행들이 서로 얼마나 얽혀 있는가 — 이 두 지표의 곱이 일정 수준을 넘는 순간 찾아옵니다. 두 요인 중 하나만으로는 안전할 수 있습니다.
- 정책적 시사점도 분명합니다: 상호 익스포저는 규제로 통제 가능한 변수입니다. 실제로 한국은 2008년 금융위기 이후 은행 간 비핵심 익스포저를 제한하는 규제를 도입한 바 있습니다.
한계: 전적으로 이론 논문이고(수치 실험이 없음), 은행들이 비슷하다는 동질 가정이 강합니다. 임계 상수의 정확한 값도 아직 추측에 머물러 있습니다.
공통 인사이트: 위기는 예측의 문제가 아니라 조건의 문제다. 꼬리(극단 손실)와 연결(상호 익스포저)을 봐야 붕괴가 보인다.
같은 테마에서, 극단 손실(VaR·Expected Shortfall) 추정에 데이터 자체의 불확실성을 반영한 연구(1705.08301), 중국 주식시장에서 군집행동이 "너무 연결되어 실패하기 어려운" 리스크를 키운다는 실증(1705.08240), 극단적으로 얇은 꼬리를 가진 운영 리스크 분포의 문제(1705.06868)도 함께 읽을 만합니다.
월 전체 Big Picture: "위험을 다시 정의하는 달"
2017년 5월의 다섯 테마를 관통하는 메시지는 하나입니다: 위험을 어떻게 정의하고, 현실의 마찰과 꼬리를 어디까지 모형에 넣는가. 분산 대신 엔트로피를 쓰면 43년의 표본외 성과가 달라지고(테마 1), 시장의 구조를 모형에 담으면 시장을 이기는 조건이 보이며(테마 2), 복잡한 변동성 모형도 단순 계약으로 환원되면 실전에 쓸 수 있고(테마 3), 거래의 마찰을 넣어야 전략이 실제로 돈을 벌며(테마 4), 연결과 꼬리를 봐야 붕괴가 보입니다(테마 5).
흥미로운 점은, 요즘 AI 트레이딩이 결국 마주치는 문제들이 바로 이것이라는 사실입니다. 딥러닝으로 아무리 정교한 예측을 만들어도, 위험의 정의가 틀리면 포트폴리오가 깨지고, 거래비용을 무시하면 이익이 사라지며, 시스템의 연결을 모르면 위기를 놓칩니다. A등급 11편 중 7편이 포트폴리오 최적화에 몰려 있다는 점이 이 달의 성격을 상징합니다 — 예측이 아니라 구조가 화두였습니다.
한계와 주의점
- 시대의 한계: 이 코호트에는 강화학습·LLM 기반 트레이딩 연구가 사실상 없습니다. 예측 기법은 통계 모형 중심이지만, 그 뒤의 어떤 AI 연구도 여기 다룬 문제들(비정규 수익률, 거래비용, 모델 위험, 전염, 계산)을 피할 수 없습니다.
- 실험의 조건: 대표 논문들의 실증은 각각 조건부입니다. 엔트로피 포트폴리오는 미국 월간 주식 데이터, 시장조성 연구는 시뮬레이션 주문장, 시스템 리스크 연구는 동질 은행 가정입니다. "항상 그렇다"보다 "이 조건에서 그렇다"로 읽어야 합니다.
- 재현성 점수: 이 달 A등급 논문들의 재현성 점수는 35~62로 넓게 분포합니다. 코드를 공개한 건 시장조성 연구(62) 정도이고, 나머지는 수학이 훌륭하다는 뜻이지 코드가 있다는 뜻은 아닙니다.
- 수치의 맥락: 샤프비율 0.911 대 0.890은 6개 데이터셋·43년 표본외 평균이며, 특정 자산군·기간에서는 격차가 다를 수 있습니다. 분산스왑-로그계약 비율의 변화도 모형 구성에 좌우됩니다.
- 논문의 개정: 분산스왑 논문은 2017년 공개 이후 2019년까지 개정됐고, 시장조성 논문도 2020년 판까지 다듬어졌습니다. 원문 링크는 최신 버전을 보여 줍니다.
그래서 투자/실무엔?
- 위험 측정을 분산 하나로 한정하지 마세요. 포트폴리오 최적화의 목적함수를 분산 대신 꼬리에 민감한 척도(엔트로피·CVaR)로 바꾸면, 평소 비슷해 보여도 크게 깨지는 날의 방어력이 달라집니다. 회전율 부담은 크지 않았습니다.
- 리밸런싱은 "마찰"을 넣고 설계하세요. 가격충격·거래비용을 최적화에 미리 반영한 전략이 이론적 최적을 좇는 전략보다 오래 살아남습니다.
- 변동성 상품을 다룬다면 "로그 계약 환원"을 기억하세요. 분산스왑의 헤지·정가는 옵션 조합의 문제로 환원될 수 있으며, 그 비율이 가격 수준에 따라 변한다는 사실이 실제 정가의 디테일을 결정합니다.
- 시장조성·대량주문 실행은 "계산 예산"을 전략의 일부로 보세요. 상태공간 근사가 촘촘할수록 성과가 올라간다는 결과는, 튜닝만큼이나 인프라가 중요하다는 뜻입니다.
- 시스템 리스크는 "연결성 × 취약 기관 밀도"로 감시하세요. 한 지표가 아니라 두 지표의 곱이 임계값을 넘는 순간이 위기의 신호입니다. 포트폴리오 내 클러스터 붕괴 분석에도 같은 관점이 통합니다.
더 알아보기
이 글에서 다룬 A등급 논문 11편의 arXiv 링크와 5차원 평가 점수입니다(참신성 / 실용성 / 엄밀성 / 재현성 / 통찰, 복합점수 기준 내림차순).
이 외에도 테마별 보석 같은 논문들(타깃데이트 펀드 비판, LOB 공개 벤치마크 데이터셋, 모델 프리 초헤징 쌍대성 등)은 각 테마 섹션의 링크에서 확인하세요.
📚 이 글에서 다룬 논문 (21편)
- APricing Variance Swaps on Time-Changed Markov Processes
Peter Carr, Roger Lee, Matthew Lorig
- AAlgorithmic trading in a microstructural limit order book model
Frédéric Abergel, Côme Huré, Huyên Pham
- A
- APortfolio Choice with Small Temporary and Transient Price Impact
Ibrahim Ekren, Johannes Muhle-Karbe
- ALocal risk-minimization with multiple assets under illiquidity with applications in energy markets
Panagiotis Christodoulou, Nils Detering, Thilo Meyer-Brandis
- AGrowth-Optimal Portfolio Selection under CVaR Constraints
Guy Uziel, Ran El-Yaniv
- ABayesian Inference of the Multi-Period Optimal Portfolio for an Exponential Utility
David Bauder, Taras Bodnar, Nestor Parolya 외 1명
- AParticle systems with singular interaction through hitting times: application in systemic risk modeling
Sergey Nadtochiy, Mykhaylo Shkolnikov
- BOn the Black's equation for the risk tolerance function
Sigrid Källblad, Thaleia Zariphopoulou
- B
- BAre target date funds dinosaurs? Failure to adapt can lead to extinction
Peter A. Forsyth, Yuying Li, Kenneth R. Vetzal
- BUnspanned Stochastic Volatility in the Multi-factor CIR Model
Damir Filipović, Martin Larsson, Francesco Statti
- BDuality for pathwise superhedging in continuous time
Daniel Bartl, Michael Kupper, David J. Prömel 외 1명
- BBenchmark Dataset for Mid-Price Forecasting of Limit Order Book Data with Machine Learning Methods
Adamantios Ntakaris, Martin Magris, Juho Kanniainen 외 2명
- BMini-Flash Crashes, Model Risk, and Optimal Execution
Erhan Bayraktar, Alexander Munk
- BHerding boosts too-connected-to-fail risk in stock market of China
Shan Lu, Jichang Zhao, Huiwen Wang 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-04 월간
AI가 진짜 돈을 움직이기 시작했다 — 2026년 4월 금융 AI 연구 하이라이트
2026년 4월 금융 AI 연구 동향. LLM 에이전트가 실제 자본으로 온체인 거래를 시작하고, 백테스트의 허상이 대규모 실증으로 검증된 달의 핵심 논문들을 살펴봅니다.
 📊 2026-03 월간
AI가 주식을 예측할 수 있을까? — 2026년 3월 금융 AI 연구 리뷰
2026년 3월 금융 AI 논문 734편을 분석한 월간 종합. LLM의 시간 편향 문제, 백테스트 엔진의 숨겨진 오차, 포트폴리오 최적화의 새로운 수학, LOB 시뮬레이션의 현실화, 강화학습 트레이딩 시스템의 실전 전환까지 — 신뢰할 수 있는 금융 AI를 만드는 5가지 연구 테마를 살펴봅니다.
 📊 2026-01 월간
AI가 포트폴리오를 짜고, 뉴스를 조작하고, 블록체인에서 대량 매도한다 — 2026년 1월 금융 AI 연구 하이라이트
2026년 1월 arXiv에 올라온 금융 AI 연구를 5개 테마로 정리했습니다. 파라미터 불확실성을 포트폴리오에 반영하는 방법, LLM 에이전트의 결정 재현성 문제, DEX에서의 대량 매도 최적화, 연합학습으로 신용리스크를 예측하는 방법, 그리고 주문흐름과 변동성을 하나로 묶는 미시구조 이론까지.