매달 arXiv에 쏟아지는 금융 연구 중에서 의미 있는 논문을 골라 정리합니다. 이번은 2017년 6월입니다. 이 달의 논문들을 읽다 보면 하나의 흐름이 보입니다. 인공지능이 "다음에 오를 종목을 맞히는" 일에서 한 걸음 물러나, "자금을 어떻게 나눌까"라는 결정 자체를 맡기 시작했다는 것. 그리고 그 결정이 기대는 계산기와 시뮬레이션을 얼마나 믿을 수 있는지를 수학으로 따지는 연구들이 옆에서 함께 나왔다는 것입니다.
들어가며: 짐 싸기, 지도 정확도, 그리고 비상 탈출 계획
오랜 여행을 떠난다고 상상해 봅시다. 배낭은 하나인데 넣을 짐은 열한 가지입니다. 무엇을 얼마나 넣을지 — 이게 포트폴리오 문제입니다. 그런데 배낭 싸기 전에 확인할 게 또 있죠. 손에 든 지도가 실제 지형과 얼마나 맞는지(계산의 정확도), 가야 할 도시가 백 개쯤 되면 최적 경로를 어떻게 찾을지(차원의 저주), 큰 짐을 한꺼번에 옮기다 보면 시장 가격이 흔들리는 문제(가격 충격), 그리고 문제가 생겼을 때 바로 되돌아오는 규칙(손절).
2017년 6월의 금융 연구들은 놀랍도록 정확하게 이 네 가지를 각각 파고들었습니다. 그 이야기를 차례로 따라가 봅시다.
1. "예측하지 말고 결정하라" — 강화학습 포트폴리오 관리의 탄생
무엇이 문제였나
전통적인 투자 알고리즘의 대다수는 "다음 가격을 예측한다 → 사람이 만든 규칙으로 주문을 바꾼다"는 구조였습니다. 예를 들어 "내일 오를 것 같은 종목에 더 많이 넣자"처럼요. 그런데 이 구조에는 두 가지 병이 있었습니다.
- 예측이 틀리면 끝입니다. 예측 정확도에 성과가 통째로 매달립니다.
- 예측과 행동 사이의 규칙이 사람이 만든 것입니다. 거래비용 같은 현실적인 요소를 이 규칙이 잘 흡수하지 못합니다. 예측은 좋은데 매매가 너무 잦아 수수료로 다 까먹는 식이죠.
한편 강화학습으로 매매를 배우려 해도, 당시 알고리즘들은 대부분 "사라/판다" 같은 단일 자산의 단순 신호에 묶여 있었습니다. 열한 개 종목에 자금을 나누는 다자산 포트폴리오 문제에는 못 쓰는 도구들이었죠.
핵심 아이디어: 신경망이 '예측' 대신 '비중표'를 내놓는다
시안교통리버풀대학교의 Jiang, Xu, Liang 세 명은 아예 다른 출발점을 택했습니다. 가격을 예측하지 않고, 포트폴리오 비중표 자체를 출력하는 강화학습 프레임워크입니다. 논문의 별칭이 "Deep Portfolio Management"입니다.
- EIIE(Ensemble of Identical Independent Evaluators): 종목마다 "똑같이 생긴 평가기" 신경망을 하나씩 붙입니다. 각 평가기는 자기 종목의 최근 가격 흐름만 보고 "지금 얼마나 매력적인가"를 점수로 매깁니다. 이 점수를 "이번에 비중을 얼마나 바꾸려 하는가"에 따라 깎아서 소프트맥스에 넣으면 새 비중표가 나옵니다. 비중표가 곧 매매 행동입니다. 종목별 평가기가 가중치를 공유하므로 종목 수가 늘어도 구조가 단순하게 확장됩니다.
- PVM(Portfolio-Vector Memory): 직전 시점의 비중표를 기억해 둡니다. "어제 30%였는데 오늘 60%로" 같은 과도한 조정을 하면 수수료가 많이 나가니까, 아예 기억해 두고 억제하게 만드는 장치입니다. 덤으로 반복 신경망의 기울기 소실 문제도 피합니다.
- OSBL(Online Stochastic Batch Learning): 시장 데이터가 계속 밀려오는 중에도 학습을 멈추지 않는 학습 방식입니다.
- 보상 함수는 단순합니다. "최종적으로 자산이 얼마나 불어났는가"를 그대로 보상으로 씁니다.
결과: 수수료 0.25%를 내고도 50일에 최소 4배
암호화폐 거래소 폴로니엑스(Poloniex)에서, 거래량 상위 11개 코인과 현금(비트코인)을 합친 12자산 포트폴리오를 30분마다 재조정하는 실험을 세 번 했습니다. 참고로 이때 폴로니엑스의 매매 수수료는 건당 0.25%로, 꽤 비싼 편입니다.
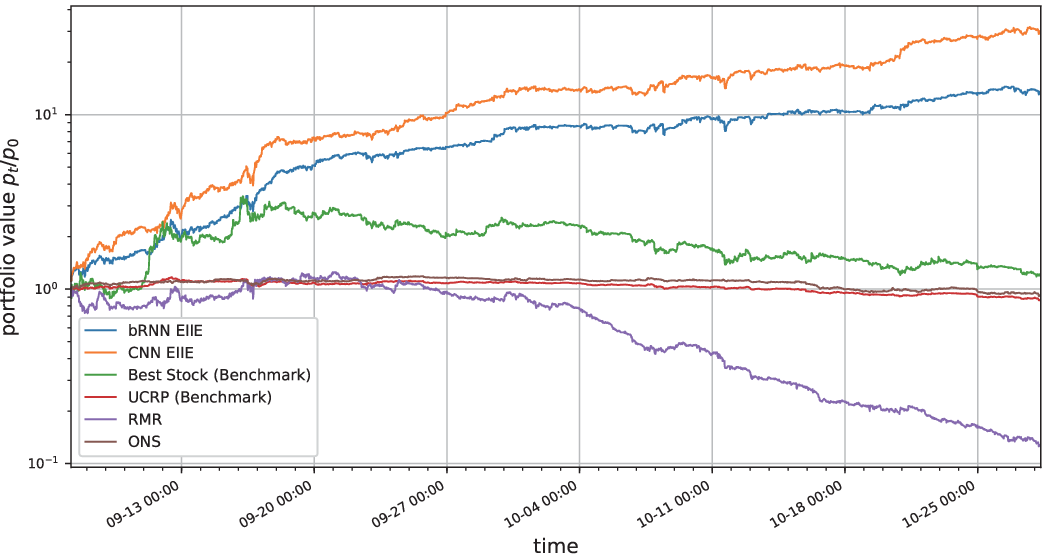
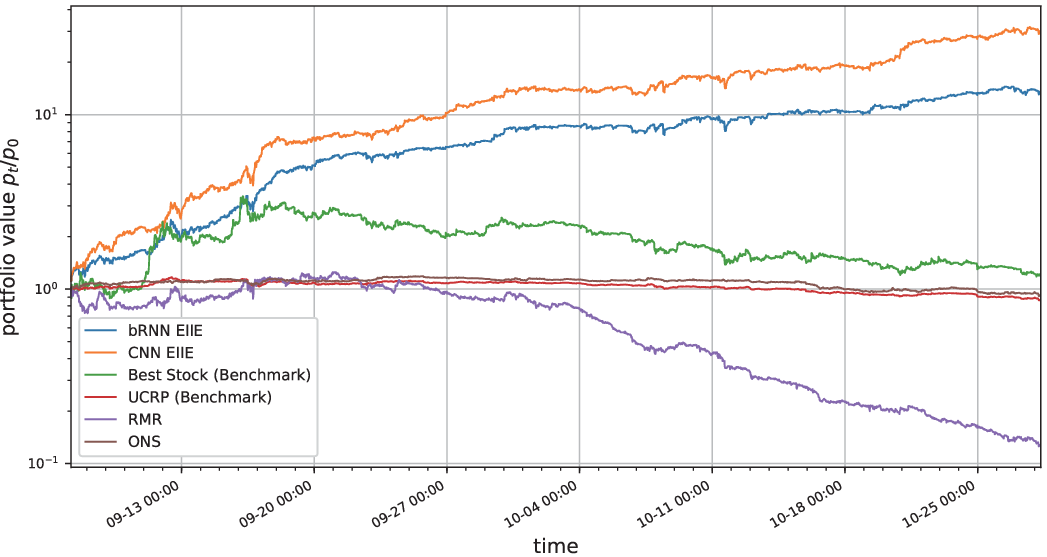
- 백테스트 1(2016년 9월 7일~10월 28일): CNN 평가기 버전이 최종 자산이 처음의 약 29.7배(fAPV 29.695). 같은 기간 "가장 잘 오른 단일 종목"은 1.22배, 균등 보유는 0.87배 — 대부분의 전통 알고리즘은 오히려 손실이었습니다.
- 백테스트 2(2016년 12월 8일~2017년 1월 28일, 세 번 중 가장 어려운 구간): 8.03배.
- 백테스트 3(2017년 3월 7일~4월 27일): 기본 RNN 버전이 약 47.1배. 이 구간에서조차 최고 단일 종목은 4.59배에 그쳤습니다.
세 실험 모두 EIIE 계열 세 모델이 수익률·위험조정 지표 상위 3위를 독식했습니다. 논문 초록의 요약처럼, 높은 수수료에도 약 50일 남짓한 기간에 최소 4배 이상을 번 셈입니다.
솔직하게 본 한계
이 숫자들을 그대로 믿으면 곤란합니다. 세 구간 모두 2016~2017년 암호화폐 초강세장이었습니다. 게다가 30분 주기로 자주 재조정하는 전략이 그 시장의 높은 변동성과 만나 만든 결과라, 주식시장에 그대로 옮길 수 없습니다. 논문도 세 번째 백테스트에서 두 번의 큰 하락(2017년 3월 15일, 4월 9일)을 겪은 사실을 숨기지 않습니다. 다만 종목 선정에 쓰는 거래량 정보를 "백테스트 직전 30일치"로만 제한해 미래 정보가 스며드는 생존 편향을 피하려 한 점은, 실증 수준이 꽤 높다는 인상을 줍니다.
이 테마의 공통 인사이트
이 달의 포트폴리오 논문들은 서로 다른 길로 가지만 같은 결론에 닿습니다. "성과를 가르는 것은 예측 정확도만이 아니라, 자금을 어떻게 나누고 어떻게 오래 들 것인가"라는 것이죠. 잘 분산된 포트폴리오가 시장의 '성장 최적 포트폴리오'에 근사한다는 이론(1706.06832)이 균등가중의 오랜 성공을 설명하고, "적게 사서 자주 바꾸지 않는" 희소 포트폴리오 선택 기준(1706.10180)과 변동성의 장기 기억을 반영한 최적 배분(1706.03139)이 같은 방향을 가리킵니다.
2. 계산기를 믿어도 될까 — 변동성 모형과 시뮬레이션 오차
무엇이 문제였나
옵션 가격을 매기는 모델은 갈수록 정교해졌습니다. 시장 가격을 그대로 재현하는 '국소 변동성' 모델, 변동성 자체가 출렁이는 '확률 변동성' 모델, 둘을 합친 '확률-국소 변동성' 모델에, 심지어 과거 최고가 같은 경로 정보까지 변동성에 반영하는 모델까지 나왔습니다. 현실적인 모델일수록 좋죠.
그런데 결정적인 구멍이 있었습니다. 이런 복잡한 모델에는 닫힌 형태의 가격 공식이 없습니다. 그래서 몬테카를로 시뮬레이션 — 무작위로 가격 경로를 수만~수억 번 만들어 평균을 내는 방법 - 에 의존해야 합니다. 그러면 자연히 이런 질문이 나옵니다. "시뮬레이션을 촘촘하게 하면 오차가 정말 줄어드는가? 얼마나 빨리?" 놀랍게도, 현업이 실무에서 널리 쓰던 시뮬레이션 기법(Euler 분할법)에 대해 이 질문에 답한 이론이 없었습니다.
핵심 아이디어: 오차의 속도를 증명으로 붙잡다
옥스퍼드대학교의 Cozma와 Reisinger는 실무에서 그대로 쓰이는 조합을 겨냥했습니다. 가격에는 로그-Euler, 제곱 변동성에는 '완전절사 Euler' 또는 '내향 Euler-마루야마' 방식을 쓰는 몬테카를로 체계입니다. 그리고 증명해 냈습니다 — 이 근사의 오차가 시간 간격을 촘촘하게 할수록 차수 1/2의 속도로(로그 보정 포함) 줄어든다는 것을, 일정한 "임계 시간" 안에서 말이죠.
이게 왜 중요하냐면, (1) 이 클래스에서 인기 있는 Euler 방식의 양(+)의 수렴률 증명은 처음이고, (2) 그 차수가 매끈한 계수를 가진 훨씬 단순한 모델에서 알려진 최적 차수와 똑같다는 뜻입니다. 즉 이 단순한 계산법이 복잡한 모델에서도 "적당히 쓸 만한"이 아니라 "이론적으로도 최적인" 방법이라는 것이 확인된 셈입니다. 덤으로 오차가 1/2 차수로 줄어든다는 것은 '다중수준 몬테카를로'라는 효율화 기법을 그대로 쓸 수 있다는 뜻이기도 합니다.
결과: 이론이 '평소 쓰는 구간'을 덮는지 확인
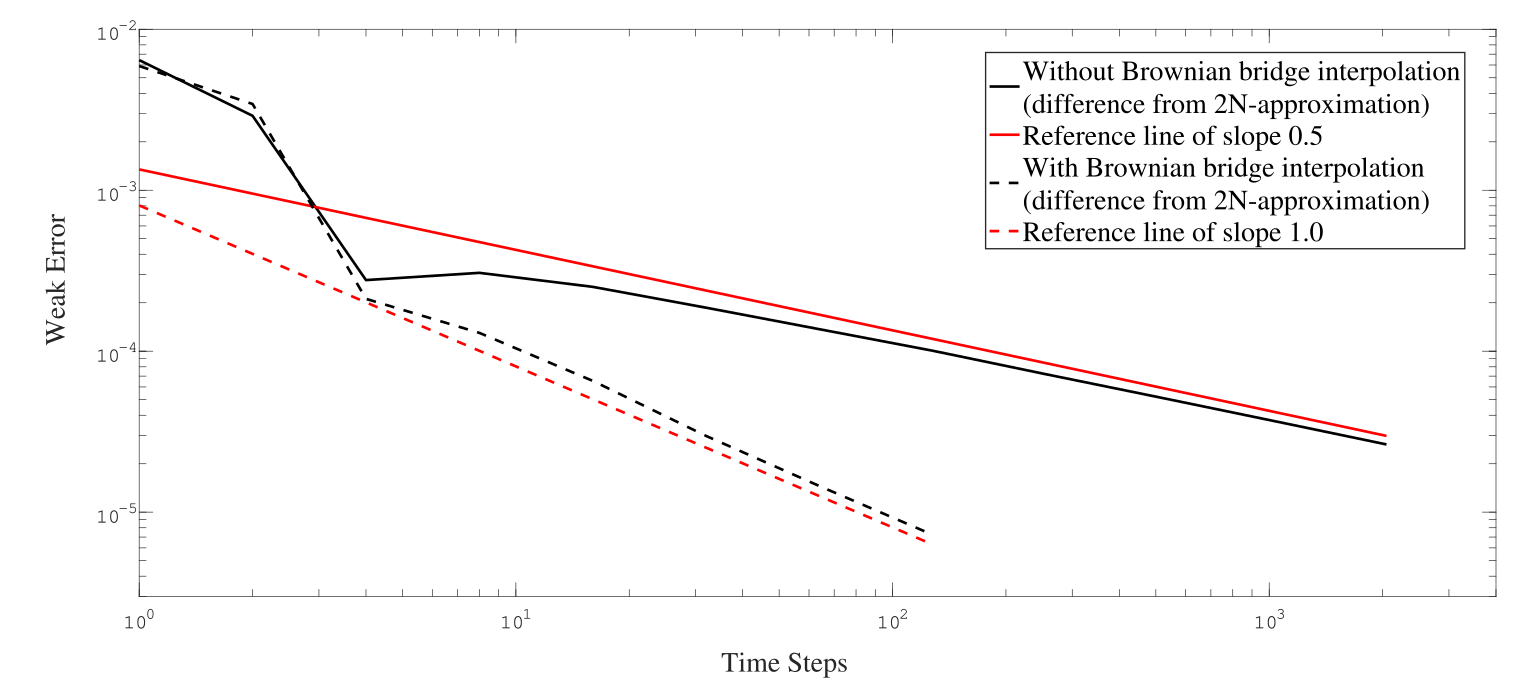
저자들은 주식·FX 시장의 실측값에 근접한 파라미터로 수치 실험을 했습니다. 계산된 임계 시간은 p=1에서 132.58, p=2에서 12.57 — 실제 거래 기간(1)을 넉넉히 덮습니다. "이론이 이상한 조건에서만 성립하는 게 아니구나"를 확인하는 과정입니다. 옵션 가격의 오차(약한 오차)는 브라운 운동 다리 보간이라는 기법을 쓰면 오차가 시간 간격에 대해 훨씬 빠르게 줄어듦(기울기 약 1.0 대 0.5)도 실험으로 보여 줍니다.
옵션 가격 계산의 '계산기 비교' 논문들
같은 달에 푸리에 변환 기반 옵션 가격 알고리즘 7종의 속도와 편향을 비교한 연구(1706.05935)도 나왔습니다. 블랙-숄즈 모델을 벗어날수록 절단 오차·이산화 오차가 크게 늘어난다는 사실을 보여 주며, "어느 계산기가 빠르고 정확한가"의 순위표를 제공합니다. 힐베르트 변환 계산에 스펙트럼 필터를 끼워 정확도를 끌어올린 연구(1706.09755), 변동성이 직접 관측되지 않는다는 근본적 난관에서 헤스톤 모델 파라미터를 추정한 연구(1706.04566)도 같은 문제의식을 공유합니다.
이 테마의 공통 인사이트
"더 좋은 모델"은 "더 정직한 계산"이 받쳐줄 때만 가격이 됩니다. 모델이 정교해질수록 시뮬레이션 오차는 숨어들기 쉬운데, 이 달의 연구들은 그 오차를 감이 아니라 증명과 비교 실험으로 붙잡습니다.
3. 100차원 방정식을 10분에 — 딥러닝이 수치해석에 들어오다
무엇이 문제였나
금융에는 "차원의 저주"라는 오래된 암초가 있습니다. 자산이 100개면 100차원 편미분방정식(PDE)을 풀어야 하는데, 격자(눈금)를 촘촘히 깔아 푸는 고전적 방법은 차원이 커질수록 필요한 점수가 폭발적으로 늘어납니다. 자산 100개짜리 파생상품의 가격, 포트폴리오 최적화의 가치함수 — 모두 이 암초에 걸립니다.
핵심 아이디어: 격자를 버리고 '학습'으로 푼다
프린스턴과 ETH 취리히의 E, Han, Jentzen 세 연구자는 상당히 대담한 번역을 제안했습니다.
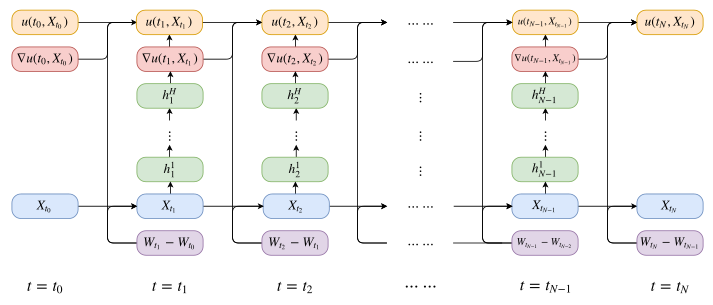
- PDE를 후방 확률 미분방정식(BSDE)로 바꾸고,
- 그 BSDE를 강화학습 문제로 읽습니다. 해의 기울기가 '정책 함수'이고, 풀이의 오차가 '손실 함수'가 되는 식입니다.
- 그 정책 함수를 신경망으로 근사해 학습시킵니다.
결국 격자는 하나도 만들지 않습니다. 무작위 시뮬레이션 경로 위에서 신경망이 대답을 학습하는 구조입니다. 유명해진 이름 "딥 BSDE"의 탄생 순간입니다(이 연구는 2018년 PNAS에 정식 게재되어 고차원 PDE의 대표적 딥러닝 해법으로 자리 잡습니다).
결과: 100차원에서 오차 0.3%, 약 10분
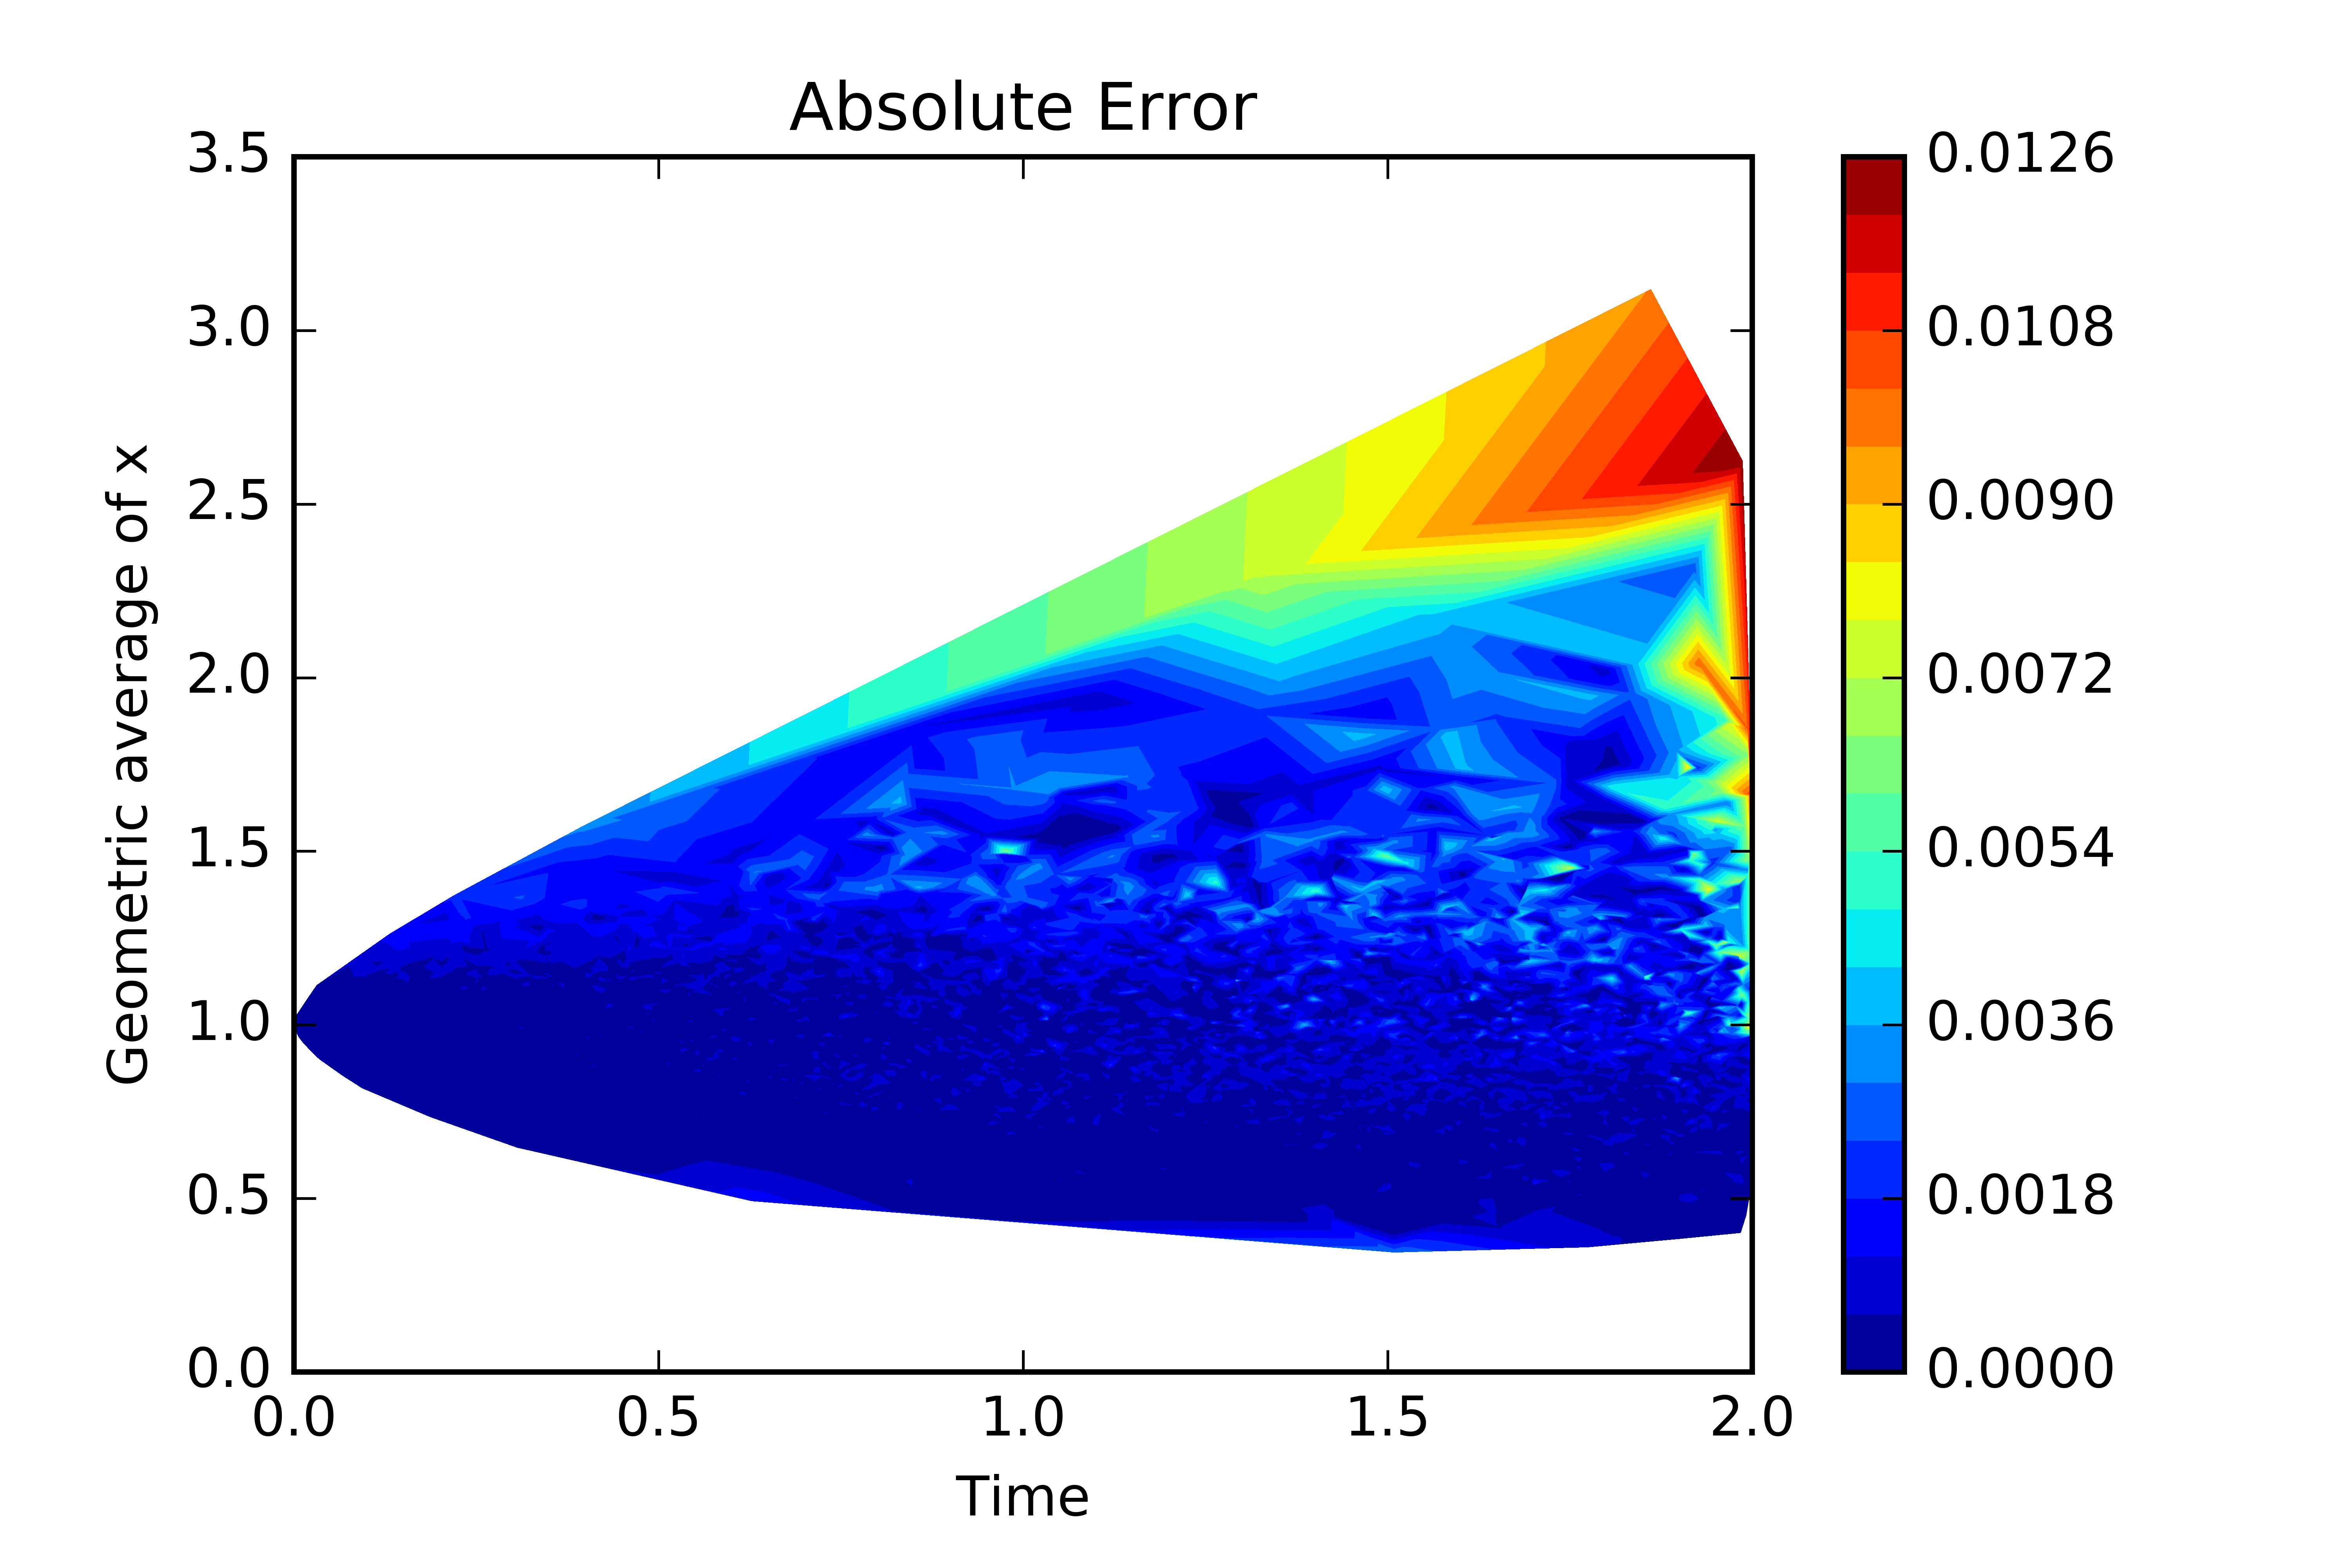
- 100차원 Allen-Cahn 방정식(물리학의 표준 테스트 문제): 4,000번 학습 후 상대 오차 약 0.0030(0.3%). 정답 참고값은 0.052802인데 신경망은 0.0528을 냈습니다. 한 번 돌리는 데 약 595~647초 — 10분 안팎입니다.
- 금융 예제 — 차입 금리와 대출 금리가 다른 시장에서의 파생상품 가격(100개 자산의 최댓값에 연동된 지급액): 상대 오차 약 0.0039, 566초. 참고값 21.299 대비 21.217을 냈습니다.
- 참고로 이 논문은 TensorFlow 구현 소스코드를 부록에 공개했습니다. 재현성 면에서 이 달 코호트 중 손꼽힙니다.
솔직하게 본 한계
저자들 스스로 명확히 밝힙니다. "차원의 저주를 딥러닝이 풀었다는 이론적 근거는 아직 없다"고요. 이 논문의 진짜 기여는 100차원에서 실용적으로 작동한다는 계산적 증거입니다. 또 "오차 0.3%"는 다른 고급 수치법이 낸 참고값과의 차이이므로, 정답을 모르는 문제에서는 별도의 검증 절차가 필요합니다.
같은 달에 모델 자체가 불확실한 상황에서 배우면서 보수적으로 행동하는 '적응형 강건 제어'(1706.02227), 시장이 변할 때마다 다시 학습하지 않고 온라인으로 갱신하는 내재변동성 표면 모델링(1706.01833)도 같은 방향 — "모르는 것을 감수하면서 계산한다" — 의 연구입니다.
이 테마의 공통 인사이트
2017년 6월의 인공지능은 "가격 예측기"가 아니라 수치해석의 엔진으로 금융에 들어옵니다. 격자를 버리고 학습과 샘플링으로 계산 병목을 옮기는 전략이, 금융의 오래된 계산 난제에 처음으로 본격 적용된 달입니다.
4. 가격은 왜 움직이는가 — 충격의 보편적 법칙과 '고정된 가격'
무엇이 문제였나
주가가 왜 움직이는가 — 오래된 질문입니다. 최근의 답 중 하나는 "뉴스가 아니라 주문의 흐름이 가격을 움직인다"입니다. 사려는 주문이 몰리면 가격이 오르고, 팔려는 주문이 몰리면 내려갑니다(가격 충격). 그런데 이상한 실증 사실이 있었습니다. 큰 투자자가 잘게 쪼개어 실행하는 대형 주문의 충격은 거래량의 제곱근에 비례한다는 것 — 교과서적인 선형 모델과 어긋나는 법칙이었습니다. 기존 연구들은 "거래 몇 건을 묶어 계산하면 충격이 다시 선형이 된다"고 보고했지만, 헤지펀드 Capital Fund Management의 Patzelt와 Bouchaud는 이 그림이 불완전하다고 봤습니다.
핵심 아이디어: 축을 제대로 맞추면 하나의 곡선이 된다
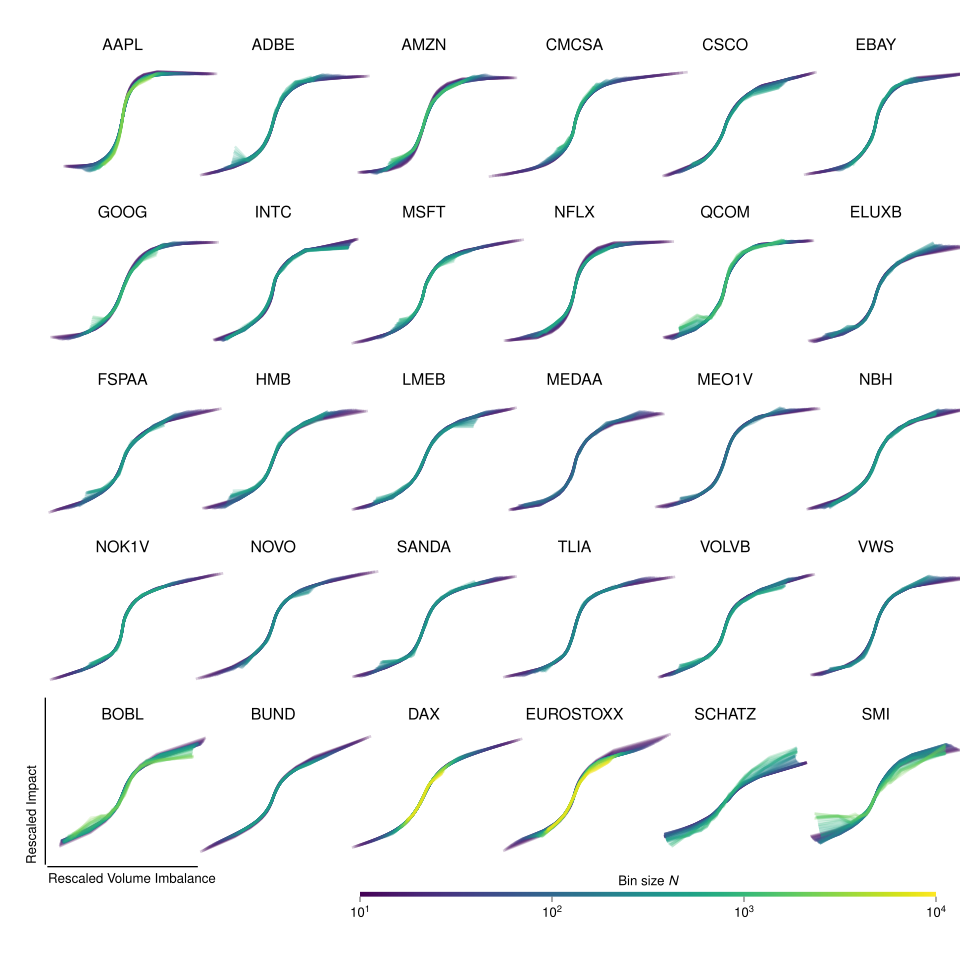
여러 건의 거래를 묶었을 때의 충격 곡선을 거래 건수에 맞춰 축을 재조정하면, 놀라운 일이 벌어집니다. 10건 이상부터 모든 곡선이 하나의 마스터 곡선으로 겹쳐 붙는 것입니다. 종목이 대형주든 소형주든 선물이든 거의 상관없고, 어떤 시간 척도에서 묶었는지도 거의 상관없습니다. 그 곡선은 선형이 아니라 시그모이드(자라서 포화하는) 모양입니다. "집계 충격은 선형"이라는 통념에 정면으로 도전하는 발견이죠.
스케일링 법칙도 정리됩니다. 거래량 불균형 축의 폭은 건수의 약 0.75제곱, 충격 높이의 약 0.5제곱으로 늘어나 — 결과적으로 충격 곡선의 기울기는 건수가 늘수록 −0.25제곱으로 감소합니다. 같은 불균형이라도 거래가 쌓일수록 충격 효율이 줄어든다는 뜻입니다.
더 기이한 발견: '고정된 가격'
가장 흥미로운 결과는 따로 있습니다. 주문 방향(사자/팔자)의 불균형이 극단적으로 심하면 — 한쪽으로만 주문이 쏠리면 — 평균 가격 변화가 오히려 0에 가까워진다는 것입니다. 직관과 정반대죠.
원인은 이겁니다. 방향이 한쪽으로 극단적으로 쏠린 구간에서는 한 거래가 호가 중앙가를 바꿀 확률 자체가 0으로 떨어집니다. 가격이 특정 레벨에 "핀으로 고정"된 것처럼 보이는 상태입니다. 가격은 주문 흐름이 충분히 균형을 이룰 때만 움직입니다. 극단적 불균형은 큰 수익의 신호가 아니라, 오히려 가격이 멈춘 상태의 신호였습니다.
옆에서 함께한 미시구조 연구들
호가장의 주문들이 서로를 촉발하는 자기-여파 구조를 새 방법으로 추정한 연구(1706.03411), 불규칙한 간격의 고빈도 데이터에서 선행-후행 관계를 측정한 연구(1706.06355), 뉴스 센티먼트 네트워크로 위험을 측정한 연구(1706.05812) 등이 같은 세계를 다른 도구로 들여다봤습니다.
이 테마의 공통 인사이트
가격은 정보의 즉각적 반영이 아니라, 유동성의 공급과 소비 양측이 서로 적응하며 만들어내는 현상입니다. 그리고 그 역학은 측정할 수 있을 때만 — 주문 흐름의 물리학을 붙잡을 때만 — 매매 비용과 시장 안정성의 문제로 다뤄질 수 있습니다.
5. 이론이 실전이 되려면 — 손절과 레버리지를 넣은 차익거래
무엇이 문제였나
"고무줄처럼 원래 자리로 돌아오는" 가격(평균회귀)을 활용하는 페어 트레이딩에는 잘 알려진 최적 매매 전략이 있었습니다. 사는 경계와 파는 경계 — 매매 밴드 — 를 정하고 그 밴드 밖에서만 움직이는 전략입니다. 그런데 실전의 헤지펀드는 이 이론을 그대로 못 씁니다. 두 가지가 빠져 있으니까요.
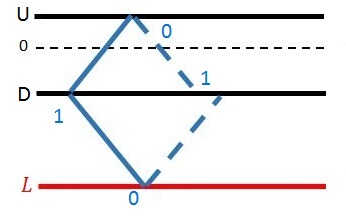
- 손절(stop-loss): 과거의 평균회귀 관계가 미래에도 유지된다는 보장은 없습니다. 손실이 커지기 전에 자르는 레벨은 실전에서 필수인데, 이 손절 레벨이 들어가면 매매 밴드가 비대칭으로 바뀝니다.
- 레버리지(차입 투자): 포지션을 키우면 수익도 커지지만, 손절 레벨과 얽히면서 최적해가 완전히 달라집니다.
밀라노 폴리테크니코와 J.P. Morgan의 Baviera, Santagostino Baldi는 이 두 요소를 처음으로 해석적으로(공식으로) 최적 전략에 통합했습니다.
핵심 아이디어: '처음으로 경계를 벗어나는 시간'으로 풀기
도구는 '최초 통과 시간' 이론입니다. 가격이 매매 밴드를 처음으로 벗어나는 시간의 평균을 공식으로 구하면, 손절 레벨이 주어졌을 때의 최적 레버리지와 최적 밴드, 그리고 장기 수익률이 손절 레벨의 함수로 표현됩니다. 손절이 있으면 "손실 시나리오"가 생기기 때문에 레버리지가 수익을 단순히 키우지 못하고, 각 손절 레벨마다 "이 정도 거래비용까지만 전략이 살아남는다"는 한도(허용 최대 거래비용)가 생기는 구조까지 공식으로 드러납니다.
결과: 에너지 선물 페어로 검증
뉴욕의 히팅오일 선물과 런던의 가스오일 선물 가격 비율(스프레드)의 1년치 30분 데이터(2015년 4월~2016년 4월)로 검증했습니다. 9개월로 공식을 뽑고(인샘플), 3개월로 검증(아웃오브샘플)했죠.
- 평균회귀 속도는 시간당 18.51(95% 신뢰구간 10.89~37.55)로 추정 — 꽤 빠른 회귀 성질.
- 손절 레벨 −1.96(변동성 척도 기준)에서 허용 최대 거래비용은 Σ의 0.76배인데, 실제 체결 스프레드로 잰 거래비용은 평균 Σ의 9.33%로 한도 안에 있습니다.
- 손절 때문에 매매 밴드는 고무줄 이론의 대칭 밴드에서 벗어나 비대칭이 됩니다.
- 레버리지 1로도 인샘플 장기 로그 수익률 0.145, 검증 구간에서 0.410을 기록했습니다. 레버리지 10이면 각각 1.175, 4.340. 수식으로 뽑힌 '최적 레버리지'는 무려 28.54배였지만(신뢰구간 15.08~41.97), 저자들 스스로 "실전에는 쓸 수 없는 수준"이라고 못 박습니다. 그래도 레버리지가 비최적어도 전략이 살아남는다는 것이 검증 구간에서 확인됐습니다.
솔직하게 본 한계
검증 구간은 단 3개월, 그것도 단일 페어입니다. 검증 구간 수익이 인샘플을 크게 웃도는 것(0.410 대 0.145)은 표본 변동일 가능성을 함께 봐야 합니다. 평균회귀 자체가 깨지는 구조 변화 앞에서는 이 공식도 손절 없이는 무용지물입니다. 또한 저자 중 한 명이 J.P. Morgan 소속이며 논문에 면책 문구가 붙어 있습니다.
같은 달에 일시적 시장 충격 아래의 최적 청산 궤적을 수학적으로 푼 연구(1706.04844), 충격 함수가 S자 모양일 때의 최적 실행 속도를 다룬 연구(1706.09224), 알파 신호의 재료인 산업 분류를 오픈소스로 공개한 연구(1706.04210)도 같은 실무 정신을 공유합니다.
이 테마의 공통 인사이트
이론의 최적해는 손절·거래비용·자금 조달이 모형 안에 있을 때만 실전의 답이 됩니다. "손절은 성과를 깎는 보험"이라는 상식 대신, 손절 레벨별로 허용되는 거래비용을 공식으로 계산해 손절-비용-수익의 삼각 관계를 정량화하는 것 — 이게 이 달의 실행 연구들이 남기는 실무적 교훈입니다.
월 전체 Big Picture
2017년 6월의 금융 연구를 한 문장으로: "예측하지 말고 결정하되, 계산과 리스크 관리를 정직하게 하라."
강화학습이 가격 예측을 넘어 포트폴리오 비중 결정을 학습하기 시작했고(1편), 그 결정이 기대는 계산 인프라가 한 단계 정직해졌습니다 — 시뮬레이션 오차가 수학적으로 보장되고(2편), 100차원 방정식이 10분 안에 풀리기 시작했습니다(3편). 시장의 실물 동학에서는 가격 충격이 선형이 아니라 보편적 비선형 곡선이라는 발견이 매매 비용의 상식을 다시 썼고(4편), 이론의 최적해가 손절과 레버리지를 품을 때 비로소 실전의 답이 된다는 교훈이 마지막을 잡았습니다(5편).
인공지능이 트레이딩을 점령했다기보다는, "결정"과 "계산"이라는 오래된 병목에 새로운 도구가 들어온 달 — 2017년 6월의 정체성입니다.
더 알아보기
이 글에서 깊게 다룬 논문들의 원문입니다.
- 강화학습 포트폴리오: A Deep Reinforcement Learning Framework for the Financial Portfolio Management Problem (1706.10059)
- 시뮬레이션 오차 증명: Strong convergence rates for Euler approximations to a class of stochastic path-dependent volatility models (1706.07375)
- 딥 BSDE: Deep learning-based numerical methods for high-dimensional parabolic PDEs and BSDEs (1706.04702)
- 가격 충격: Universal scaling and nonlinearity of aggregate price impact in financial markets (1706.04163)
- 손절·레버리지 차익거래: Stop-loss and Leverage in optimal Statistical Arbitrage with an application to Energy market (1706.07021)
가볍게 소개한 논문들: 성장 최적 포트폴리오 (1706.06832) · 분수 변동성 최적 배분 (1706.03139) · 심리 필터링 포트폴리오 (1706.03567) · 희소 동적 포트폴리오 (1706.10180) · 헤스톤 파라미터 추정 (1706.04566) · 푸리에 가격법 비교 (1706.05935) · 힐베르트 변환 옵션 가격 (1706.09755) · 아시안 옵션 근사 (1706.02408) · 특이 푸리에-파데 전개 (1706.06709) · 금리 모델 빠른 보정 (1706.00263) · 무작위 만기 최적 정지 (1706.03724) · 적응형 강건 제어 (1706.02227) · 온라인 내재변동성 학습 (1706.01833) · 최적 배당 정책 (1706.01813) · 호가장 분기 비율 추정 (1706.03411) · 고빈도 복소 상관 (1706.06355) · 전이 엔트로피 정보 흐름 (1706.05543) · 거래량 copula 분석 (1706.09240) · S자 충격 최적 실행 (1706.09224) · 최적 청산 궤적 (1706.04844) · 오픈소스 산업 분류 (1706.04210) · 루블화 폭락 여진 (1706.03246) · 뉴스 센티먼트 위험 지표 (1706.05812) · 그룹 대출 인과 추론 (1706.02795) · 기호역학과 주가 (1706.06007)
📚 이 글에서 다룬 논문 (30편)
- AA Deep Reinforcement Learning Framework for the Financial Portfolio Management Problem
Zhengyao Jiang, Dixing Xu, Jinjun Liang
- A
- BMarket Efficiency and Growth Optimal Portfolio
Eckhard Platen, Renata Rendek
- BOptimal Portfolio under Fast Mean-reverting Fractional Stochastic Environment
Jean-Pierre Fouque, Ruimeng Hu
- BPortfolio optimization for a large investor controlling market sentiment under partial information
Sühan Altay, Katia Colaneri, Zehra Eksi
- BRegret-based Selection for Sparse Dynamic Portfolios
David Puelz, P. Richard Hahn, Carlos Carvalho
- BRealized volatility and parametric estimation of Heston SDEs
Robert Azencott, Peng Ren, Ilya Timofeyev
- BHilbert transform, spectral filters and option pricing
Carolyn E. Phelan, Daniele Marazzina, Gianluca Fusai 외 1명
- BMost-likely-path in Asian option pricing under local volatility models
Louis-Pierre Arguin, Nien-Lin Liu, Tai-Ho Wang
- BFast calibration of the Libor Market Model with Stochastic Volatility and Displaced Diffusion
Laurent Devineau, Pierre-Edouard Arrouy, Paul Bonnefoy 외 1명
- BBeating the Omega Clock: An Optimal Stopping Problem with Random Time-horizon under Spectrally Negative Lévy Models
Neofytos Rodosthenous, Hongzhong Zhang
- BAdaptive Robust Control Under Model Uncertainty
Tomasz R. Bielecki, Tao Chen, Igor Cialenco 외 2명
- BOptimal dividend policies with random profitability
Max Reppen, Jean-Charles Rochet, H. Mete Soner
- BUniversal scaling and nonlinearity of aggregate price impact in financial markets
Felix Patzelt, Jean-Philippe Bouchaud
- BAnalysis of order book flows using a nonparametric estimation of the branching ratio matrix
Massil Achab, Emmanuel Bacry, Jean-François Muzy 외 1명
- BComplex Correlation Approach for High Frequency Financial Data
Mateusz Wilinski, Yuichi Ikeda, Hideaki Aoyama
- BTransfer entropy between communities in complex networks
Jan Korbel, Xiongfei Jiang, Bo Zheng
- BStop-loss and Leverage in optimal Statistical Arbitrage with an application to Energy market
Roberto Baviera, Tommaso Santagostino Baldi
- BOn the minimizers of energy forms with completely monotone kernel
Alexander Schied, Elias Strehle
- B
- BAftershocks following crash of currency exchange rate: The case of RUB/USD in 2014
Vasilya Usmanova, Yury V. Lysogorskiy, Sumiyoshi Abe
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2017-08 월간A
2017년 8월 금융 AI 논문: 가격 충격, 거친 변동성, 딥러닝 편미분방정식
2017년 8월 arXiv 금융 연구를 5개 테마로 정리했습니다. 가격을 움직이는 주문 흐름의 물리학, 밀리초 단위 선행 후행 관계, 거친 변동성 옵션 가격 계산의 20배 가속, 딥러닝으로 푸는 200차원 편미분방정식, 알파 콤보 없는 포트폴리오까지 — 측정과 계산이 함께 정교해진 달입니다.
 📊 2025-09 월간
월간 종합 블로그: 2025년 9월 — RL 포트폴리오의 이론적 한계와 새로운 수학적 도구의 등장
2025년 9월 arXiv에 공개된 AI 금융 연구를 5가지 테마로 정리합니다. 강화학습 포트폴리오의 이론적 한계, GFlowNet 기반 알파 마이닝, SABR 메타러닝 IVS 복원, 확산모델 포트폴리오 최적화, LLM 트레이딩 에이전트까지 — 전통 수리금융과 생성 AI가 결합하는 새로운 흐름을 살펴봅니다.
 📊 2024-11 월간
Optimal Execution under Incomplete Information
2024년 11월 arXiv에서 주목할 만한 시스템 트레이딩 논문 2편을 깊이 분석합니다. 미러 디센트로 리스크 버짓팅을 푸는 새로운 방법과, 숨은 유동성을 추정하면서 최적 실행 전략을 세우는 프레임워크를 소개합니다.