전략의 손익 그래프가 고점에서 15% 아래로 처졌다. 병원에 갈까, 기다릴까? 2017년 7월의 논문들은 이런 "언제 멈추고, 언제 팔고, 언제 걱정해야 하는가"의 질문들에 놀랍도록 실용적인 수학적 답을 내놓았습니다. 딥러닝과 AI가 트레이딩의 주인공이 되기 전, 수학 금융이 가장 정교하던 시기의 명작들을 만나 보죠.
들어가며: 2017년 7월에는 무슨 연구가 나왔나
이번 달에 arXiv에 올라온 금융 관련 논문은 81편, 우리 기준으로 관련 논문은 58편입니다. 흥미로운 점은 이 달의 논문들에서 인공지능을 거의 찾을 수 없다는 것입니다. 딥러닝 가격 예측은 1편, 강화학습 포트폴리오는 1편뿐이고, 나머지는 최적 정지, 시장 미시구조, 파생상품 가격결정 같은 전통적인 수학 금융 주제입니다.
2017년은 AI 트레이딩이 폭발하기 전의 시기예요. 2020년에 강화학습 트레이딩 프레임워크(FinRL)가 등장하고, 2023년 이후에는 LLM 에이전트가 화제가 되지만, 이때는 아직 "좋은 질문에 맞는 수학"을 만드는 일이 핵심이었습니다. 그런데 놀라운 것은, 9년이 지난 지금 읽어도 실무에 바로 쓸 수 있는 결과가 이 달에 여럿 나왔다는 점이에요. 어떤 질문들이었는지 하나씩 살펴보겠습니다.
테마 1: 전략이 무너진 걸까, 운이 나쁜 걸까 — 드로다운의 확률
왜 흥미로운가
트레이딩 전략을 운용하는 사람에게 가장 고통스러운 순간은 손실이 날 때가 아니라, "이게 정상인지 알 수 없을 때"입니다. 좋은 전략도 운이 나쁘면 몇 년씩 기다려야 할 수 있어요. 반대로 전략이 진짜 망가졌는데도 "곧 회복될 거야"라며 기다리면 시간과 돈을 날립니다. 그렇다면, 지금 이 드로다운이 '정상적인 불운'의 범위를 벗어났는지 어떻게 알 수 있을까요?
대표 논문: You are in a drawdown — 언제부터 걱정해야 하는가
퀀트 운용사 캐피탈 펀드 매니지먼트(CFM)의 이 짧고 강력한 논문(A등급, 65.4)은 이 질문에 확률 분포로 정확한 답을 줍니다.
방법은 단순합니다. 전략의 손익을 "꾸준히 우상향하지만 중간에 흔들리는" 수학적 모형(드리프트가 있는 브라운 운동)으로 보고, 두 가지를 계산해요.
- 드로다운의 길이: 고점 찍고 얼마나 오래 회복 못 했는가
- 드로다운의 깊이: 고점 대비 얼마나 내려왔는가 (연간 변동성 금액으로 나눠 표준화)
그리고 핵심 질문을 던집니다: "내 전략의 샤프 비율이 정말 1.0이라면, 이 정도로 길고 깊은 드로다운이 나올 확률은?" 여기서 확률이 5% 미만이면 경보등이 켜지는 거예요.
무엇을 발견했나
10년 기간으로 계산한 실용적인 근사식이 나옵니다:
- 드로다운 길이의 5% 한계 ≈ 2.14 ÷ (샤프²) — 샤프가 낮을수록 '정상' 드로다운은 기하급수적으로 길어집니다.
- 드로다운 깊이의 5% 한계 ≈ 1.50 ÷ 샤프 — 깊이는 샤프에 반비례합니다.
감각을 잡아 주는 예가 논문에 나와요: 샤프가 0.5인 전략이라도, 10년 운영 중에 드로다운이 7년 이상 이어질 확률이 5%나 됩니다. "느리지만 꾸준한" 전략의 무수익 기간이 이렇게나 길 수 있다는 뜻이죠. 반대로 샤프 1.6인 전략에서 표준화 깊이 약 0.95의 깊은 드로다운이 터졌다면? 논문에 따르면 그런 드로다운은 약 2개월보다 짧게 끝날 가능성이 매우 낮습니다. 깊은 드로다운은 대개 길게 간다는, 직관과 일치하는 결론이 수학으로 확인된 셈이에요.
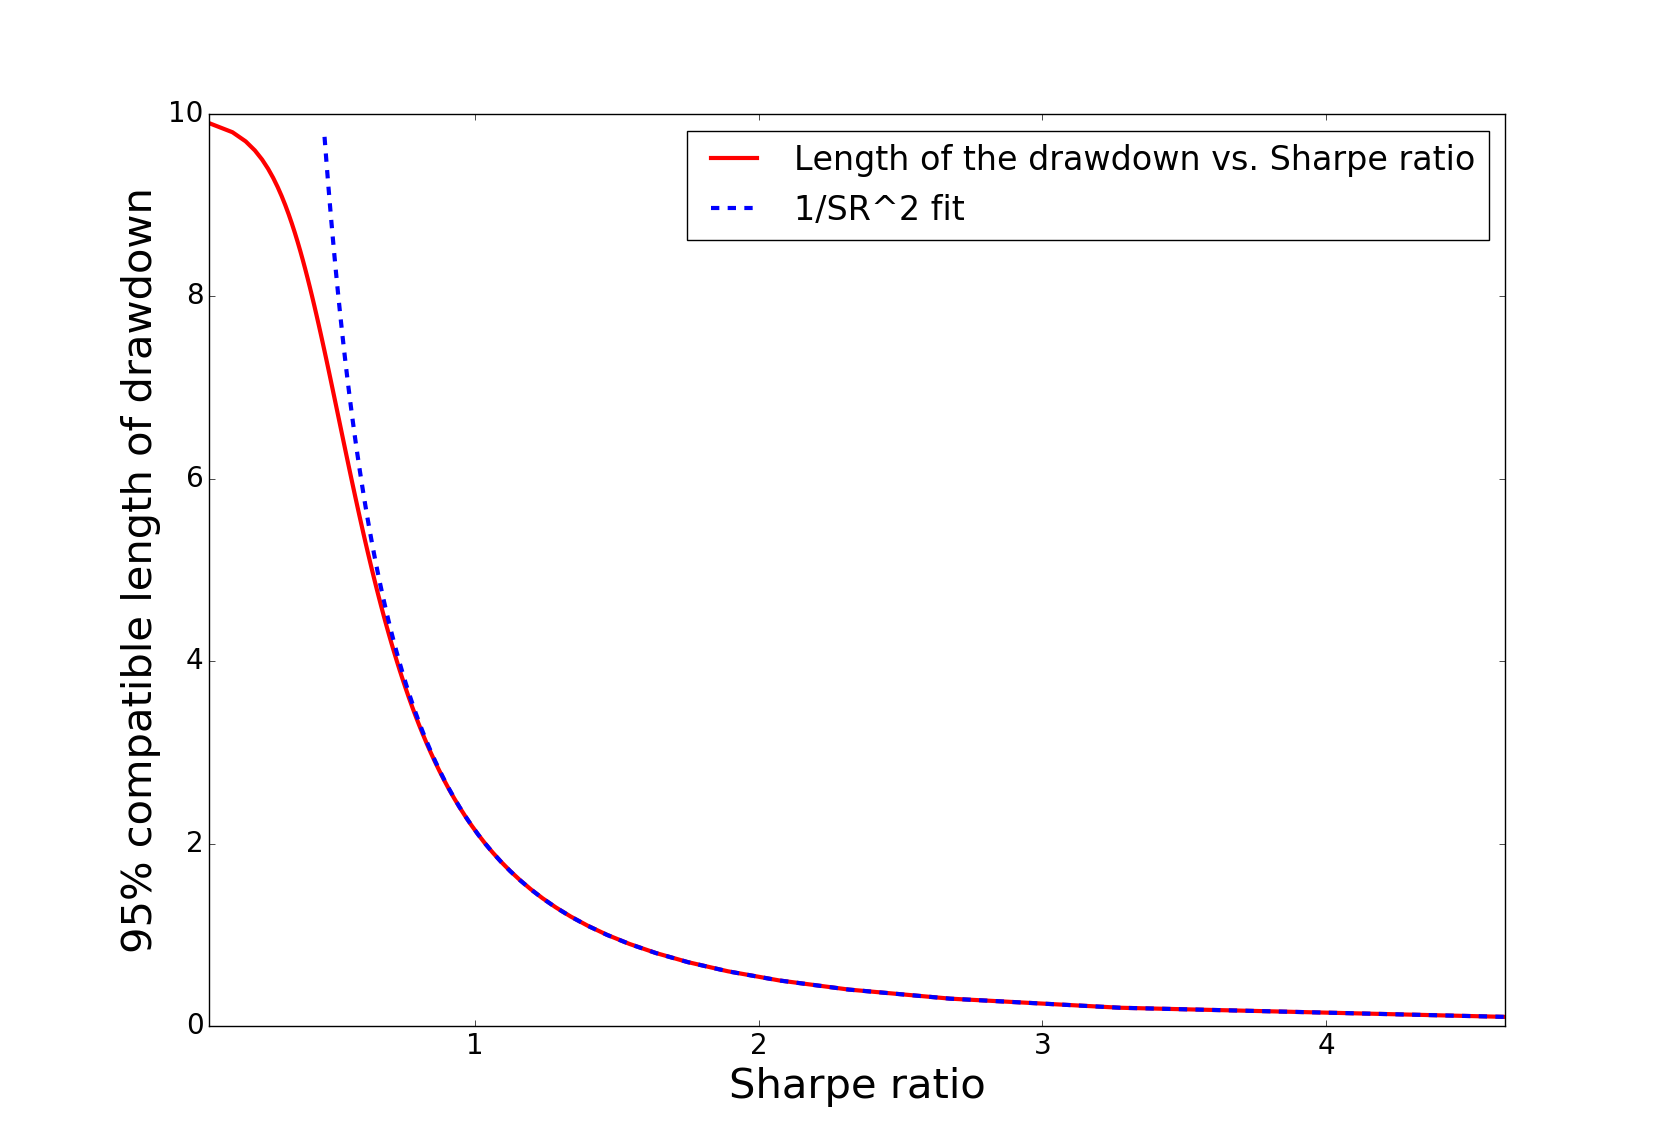
경보등이 켜졌을 때 가능한 해석은 세 가지입니다: ① 진짜 5%짜리 불운, ② 내 샤프 가정이 낙관적이었다, ③ 모형 자체가 실제 드로다운을 과소평가한다(실제 수익률은 정규분포보다 꼬리가 두껍고 변동성이 군집하므로, 실제 드로다운은 모형보다 길고 깊게 나옵니다). 저자들은 솔직하게 말합니다 — 이 검정은 ①과 ②를 구별하지 못한다. 그래서 이건 판결이 아니라 예방적 경보로 쓰는 게 맞아요. 대신 관측된 깊이로 샤프를 보수적으로 낮춰 다시 계산하는 방법을 함께 제시합니다.
또 하나 재미있는 관찰: 매니저와 투자자 모두 '정상적인' 드로다운의 길이와 깊이를 과소평가한다고 저자들은 지적합니다. 즉 인간의 직관은 "정상 범위"를 실제보다 좁게 잡는다는 거예요. 이 논문의 표는 그 직관을 교정해 줍니다.
이 테마의 공통 인사이트
이 테마의 논문들이 함께 말하는 것은 "위험을 재는 숫자를 믿기 전에, 그 숫자가 무엇을 놓치는지 확인하라"는 것입니다. 드로다운 규칙이 샤프 가정을 검증하듯이, 규제에 쓰이는 위험 측정 지표(VaR)의 형식이 사실상 유일하다는 공리적 증명(1707.05596), 상관계수를 조금만 낮게 잡아도 포트폴리오 위험이 체계적으로 과소평가된다는 지적(1707.09037), 재무비율보다 계좌 거래 흐름이 기업 부도를 더 잘 예측한다는 실증(1707.00757)도 모두 같은 주제의 변주입니다.
함께 등장한 연구들
Surplus-Invariant, Law-Invariant, and Conic Acceptance Sets (1707.05596): "은행이 파산하지 않도록 하려면 자본이 얼마 있어야 하는가"를 판단하는 규제 테스트가 공평하려면 어떤 성질을 가져야 하는지 수학적으로 따진 연구입니다. 회사 주주의 사정에 영향받지 않고(잉여불변성), 수익률 분포의 '모양'만 보고(법칙불변성), 딱 한 가지 기준으로 판단해야 한다면(원뿔성) — 답은 VaR 형태밖에 없다는 놀라운 결론입니다. 엄밀성 점수 89로 이 달에서 가장 견고한 증명 중 하나예요.
Checking account activity and credit default risk (1707.00757): 프랑스 대형 은행의 기업 계좌 데이터를 분석해, 매출·부채 같은 재무비율보다 돈이 실제로 들어오고 나가는 흐름이 부도 예측에 더 유용하다고 보여줍니다. 두 정보를 합치면 예측력이 더 올라가고요. "재무제표는 과거의 사진, 계좌 흐름은 현재의 영상"이라는 비유가 어울리는 연구입니다.
테마 2: 큰 주문은 어떻게 팔아야 하는가 — 하락장의 청산 수학
왜 흥미로운가
큰 주식 포지션을 정리해야 할 때가 있습니다. 한 번에 팔면 가격이 밀려요(시장 충격). 천천히 나눠 팔면 충격은 줄지만, 그 사이에 가격이 더 떨어질 수 있습니다. 이 균형을 다루는 고전적 이론은 "기한 안에 다 팔아라"를 전제로 합니다. 그런데 생각해 보세요 — 가격이 떨어지고 있는 시장에서, 팔 기한을 늘리는 게 정말 항상 좋을까요?
대표 논문: Optimal Trade Execution Under Endogenous Pressure to Liquidate
이 논문(A등급, 66.8)은 이 질문에서 출발합니다. 기존 연구에는 흥미로운 결과가 하나 있었어요. 가격이 평균적으로 떨어지는 시장(하락장)에서도 최적 청산 전략은 오히려 이익을 낼 수 있다는 겁니다. 하지만 그 이익의 정체는 공매도 — 먼저 빌려서 팔고 나중에 싸게 되사는 — 였습니다. 현실의 많은 기관 투자자는 공매도가 불가능하거나 금지되어 있죠.
저자들은 단순한 변경을 가합니다: 가격이 떨어지는 압력을 넣되, 공매도는 금지한다. 포지션이 0이 되면 거래가 끝나는 거예요. 이 작은 변경이 문제를 완전히 바꿉니다:
- "언제 팔기를 멈출까"가 전략의 일부가 됩니다. 기한을 미리 정해 두는 게 아니라, 시장 상황에 따라 최적의 종료 시점이 결정됩니다. 마치 "요리가 끝나는 시각"을 미리 정하지 않고 상태를 보고 판단하는 것과 같아요.
- 가격이 빠르게 떨어질수록 팔고 싶은 압력이 커지는데, 공매도가 안 되니 남은 재고를 어떻게 나눠 팔지가 핵심 문제가 됩니다.
- 계산이 어려워집니다. 문제를 푸는 방정식(HJB 방정식)이 극도로 특이해져서 저자들은 새로운 수치 기법까지 개발해야 했습니다.
그리고 흥미로운 결론이 나옵니다. 개별 주문의 충격은 "주문량에 비례"하는 단순한 형태인데, 이를 최적으로 조합한 결과 전체 주문에 대한 평균 충격은 주문량의 제곱근에 비례합니다 — 실증 연구가 오래전부터 발견한 '제곱근 법칙'을 이론이 스스로 재현해 낸 것이죠.
무엇을 발견했나
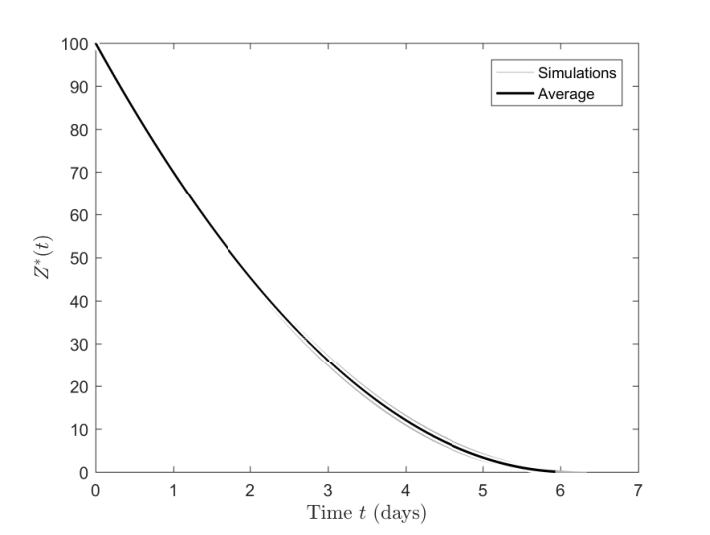
실제 데이터로 추정한 값으로 시뮬레이션했습니다. 연구진은 "5분 동안 1,000주를 팔면 가격이 약 0.18% 밀린다"는 실증 추정으로 모형을 보정하고, 10만 주짜리 블록 주문을 1만 번 시뮬레이션했어요.
- 평균 청산 소요 시간은 시장 상황에 따라 4.36일에서 13.80일까지 벌어졌습니다. 가격 하락 압력이 큰 시나리오일수록 오래 걸렸어요.
- "일정한 속도로 팔면 며칠이면 끝난다"는 단순 계산은 실제 평균의 약 절반에 불과했습니다. 실제 매도 속도는 남은 재고에 따라 달라지거든요.
- 결정적인 결론: 공매도가 금지된 하락장에서는 청산이 항상 비용(구현 손실)을 낳고, 시간을 아무리 늘려도 그 비용이 사라지지 않습니다. "시간이 약"이라는 고전적 결론이 뒤집히는 지점이에요.
한계와 주의점
영구적 가격 충격(거래가 끝난 뒤에도 남는 가격 변화)과 위험 회피 성향은 의도적으로 뺐고, 실증 검증이 아니라 이론 + 시뮬레이션 연구입니다. 실전에 쓰려면 자신의 거래 비용 데이터로 매개변수를 다시 잡아야 합니다.
이 테마의 공통 인사이트
"얼마나 빨리 팔아야 하는가"는 고정된 답이 아니라 시장의 반응에 달려 있다는 것이 이 테마의 공통 메시지입니다. 평균회귀 전략에서 진입과 청산에 서로 다른 마감 시한이 붙을 때의 최적 경계(1707.03498), 호가장에서 직전 주문의 유형이 다음 주문의 도착 확률까지 바꾼다는 실증(1707.01167), 주문 불균형의 극단값이 종목마다 다른 '두꺼운 꼬리'를 가진다는 발견(1707.05550)도 모두 "시장의 반응 구조를 읽어야 실행이 산다"는 이야기입니다.
함께 등장한 연구들
Mean Reversion Trading with Sequential Deadlines (1707.03498): 가격이 원래 자리로 돌아간다고 믿는(평균회귀) 전략에서, 사는 시점과 파는 시점에 각각 다른 마감 시한이 있고 거래비용까지 있다면 어디서 사고 어디서 팔아야 하는지의 경계를 수학으로 그립니다.
Power-law tails in the distribution of order imbalance (1707.05550): 중국 선전거래소 43개 종목의 주문 흐름을 분석해, 사려는 주문과 팔려는 주문의 불균형이 종목마다 완전히 다른 꼬리 두께를 가진다는 걸 보여줍니다. "평균적인 주문 균형"만 보던 시각이 얼마나 위험한지를 알려 주는 실증이에요.
테마 3: 위기에서 살아남는 옵션 헤지 — 시장의 국면을 읽다
왜 흥미로운가
비 오는 날 우산을 준비하는 것과, 날씨가 변하는 걸 감지해 우산을 꺼내는 것은 다릅니다. 옵션 헤지도 마찬가지예요. 블랙–숄즈라는 고전적인 옵션 가격 공식은 "변동성이 일정하다"고 가정하는데, 현실은 변동성이 시장 상황(국면)에 따라 달라집니다. 게다가 최근 수익률이 다음 수익률에 영향을 주는 '관성'도 있고요. 이 두 가지를 모두 반영하면 헤지가 얼마나 좋아질까요?
대표 논문: AR-HMM 옵션 가격결정과 헤징
이 논문(복합점수 64.6)은 시장의 "국면"(조용한 시장, 불안한 시장, 폭락 시장 같은 상태)을 자동으로 추정하는 모형에 수익률의 관성을 더한 AR-HMM(자기회귀 숨은 마르코프 모형)으로 옵션을 가격하고 헤지하는 방법을 제시합니다. 그리고 이것이 고전적 방법보다 실제로 얼마나 나은지 S&P 500 옵션으로 검증했어요.
비교 대상은 네 가지입니다. 시장의 내재변동성을 넣은 블랙–숄즈, 고전적 델타 헤지, 국면을 모르는 단순 가정하의 최적 헤지, 그리고 AR-HMM 최적 헤지. 헤지 오차는 "만기 때 실제 챙긴 돈과 옵션 값의 차이"로 측정합니다.
무엇을 발견했나
2008–2009 금융위기 구간(옵션 90개, 500일 추정 창)에서의 결과가 압권입니다:
- 콜 옵션 헤지 오차(연환산 RMSE)는 ARHMM 0.61 대, 블랙–숄즈 5.27, 시장 내재변동성 버전 3.87.
- 풋 옵션은 더 극적입니다. ARHMM 0.98 대 블랙–숄즈 42.52, 시장 버전 39.95. 40배 가까운 차이예요.
- 왜 그런가 하면, 폭락 구간에서 변동성이 치솟고 가격이 추락하면 풋 옵션의 가치가 급등하는데, 국면을 모르는 모형은 이 변화에 제때 대응하지 못해 큰 손실을 냈습니다. AR-HMM은 "지금 시장이 폭락 국면"이라는 사실을 추정에 반영한 덕분이죠.
- 이론 가격과 시장 가격의 괴리를 이용한 매수/매도 전략으로도 ARHMM이 콜·풋 모두 가장 좋은 누적 손익을 냈습니다.
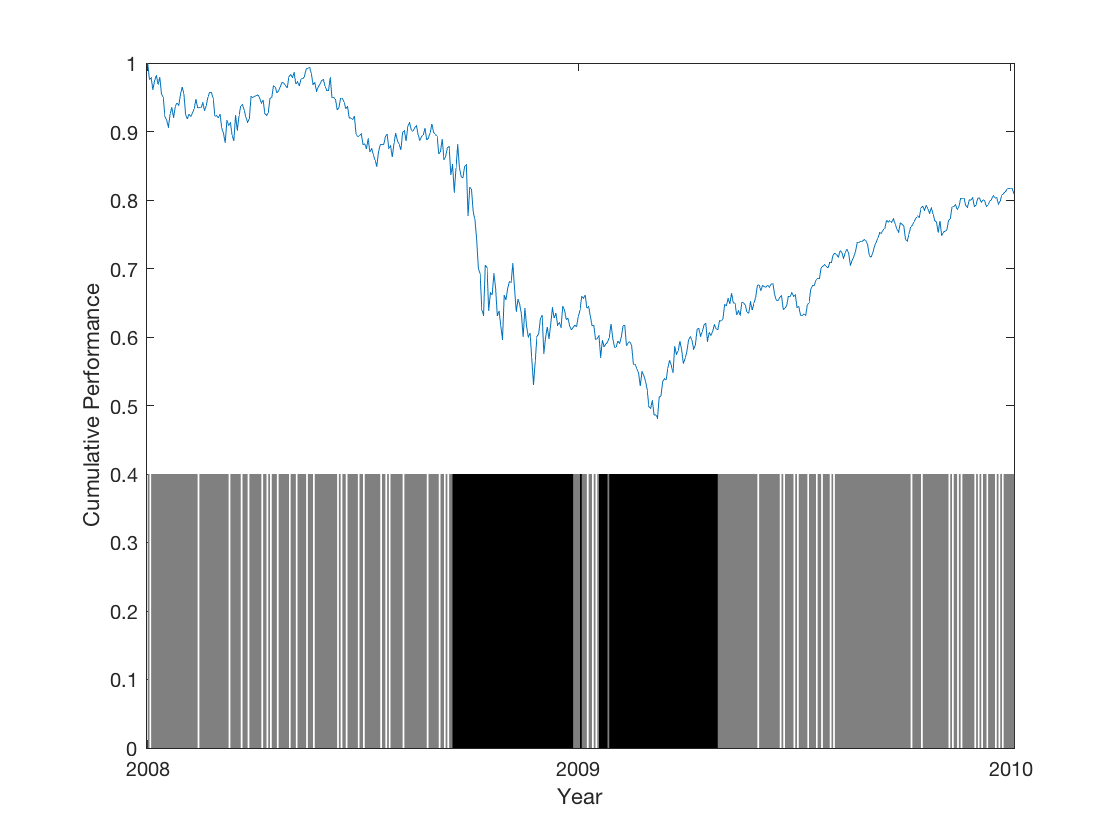
솔직한 제약도 함께 보고됐습니다. 2013–2015년처럼 조용한 강세장에서는 이야기가 달라져요. 풋은 여전히 ARHMM이 압도적이지만(0.99 대 18.12), 콜에서는 단순 최적 헤지(0.84)와 ARHMM(0.99)이 사실상 비슷했습니다. 즉 AR-HMM의 진가는 평상시가 아니라 위기에서 발휘된다는 것이죠. 오히려 위기가 포함된 긴 추정 구간에서는 국면 추정이 흔들려 저자들이 "이건 ARHMM에게 가장 불리한 환경"이라고 솔직하게 밝힐 정도입니다.
이 테마의 공통 인사이트
파생상품 연구들이 공통적으로 묻는 것은 "블랙–숄즈의 가정을 하나씩 걷어내면 무엇이 달라지는가"입니다. 여러 만기 옵션의 '최악의 경우 가격'이 하나로 정리되는 대칭성 발견(1707.08545), 시장 정보가 늦게 도착하면 옵션 가격이 달라진다는 분석(1707.01600), 변동성이 옵션 자체의 곡률에 의존하는 비선형 문제로의 확장(1707.00356, 1707.00358)이 이 달의 옵션 연구를 채웁니다.
함께 등장한 연구들
Robust Pricing and Hedging around the Globe (1707.08545): 모형을 완전히 믿지 않고 "가격의 상한과 하한만 안다"는 보수적 전제에서 출발해, 여러 만기 옵션의 강건 가격들이 놀랍도록 같은 값이 될 수 있음을 보입니다. 모델 리스크에 대비하는 헤지 설계의 이론적 기반입니다.
Option Pricing with Delayed Information (1707.01600): 우리가 보는 가격 정보가 조금 늦게 도착한다면(정보 지연), 옵션 가격과 복제 전략은 어떻게 달라질까요? 이항 모형에서 볼록한 청구권의 가격 공식까지 도출합니다. 초고빈도 거래가 아닌 일반 투자자에게도 "데이터가 실시간이 아닐 때의 비용"을 생각하게 하는 연구입니다.
테마 4: 미국형 옵션을 0.004초에 — 모멘트를 지키는 근사의 수학
왜 흥미로운가
미국형 옵션은 만기 전 아무 때나 행사할 수 있는 옵션입니다. "언제 행사할까"를 계산해야 해서 유럽형(만기에만 행사)보다 훨씬 계산이 무거워요. 몬테카를로 시뮬레이션을 돌리자니 느리고, 트리를 만들자니 상태가 늘어날 때마다 비용이 폭증합니다. 여기서 재치 있는 질문이 나옵니다 — 복잡한 연속 가격 모형을, 핵심 성질만 지키는 '간단한 상태 몇 개'로 바꿔 계산하면 어떨까요?
대표 논문: Markov cubature rules for polynomial processes
이 논문(A등급, 67.9, 이후 저널에 정식 게재)은 바로 그 일을 합니다. 저자는 다항식 확산(polynomial process)이라 불리는, 금리·변동성·신용 모형에 널리 쓰이는 확률 모형을 다룹니다. 이 모형의 특징은 "다항식의 평균을 구하면 다시 다항식이 나온다"는 것 — 그래서 평균과 분산 같은 모멘트를 정확하게 계산할 수 있어요.
논문의 아이디어는 "모멘트를 똑같이 맞추는 유한 개의 상태 + 상태 사이를 오가는 확률"로 원래 모형을 근사한다는 것입니다. 상태 몇 개와 전이확률 행렬만 있으면, 몬테카를로 시뮬레이션 없이 행렬 계산만으로 가격을 구할 수 있죠. 적분을 대표점 몇 개로 대체하는 '구적법(cubature)'을 시간축에 적용한 것이라 마르코프 구적법칙이라 이름 붙였습니다.
무엇을 발견했나
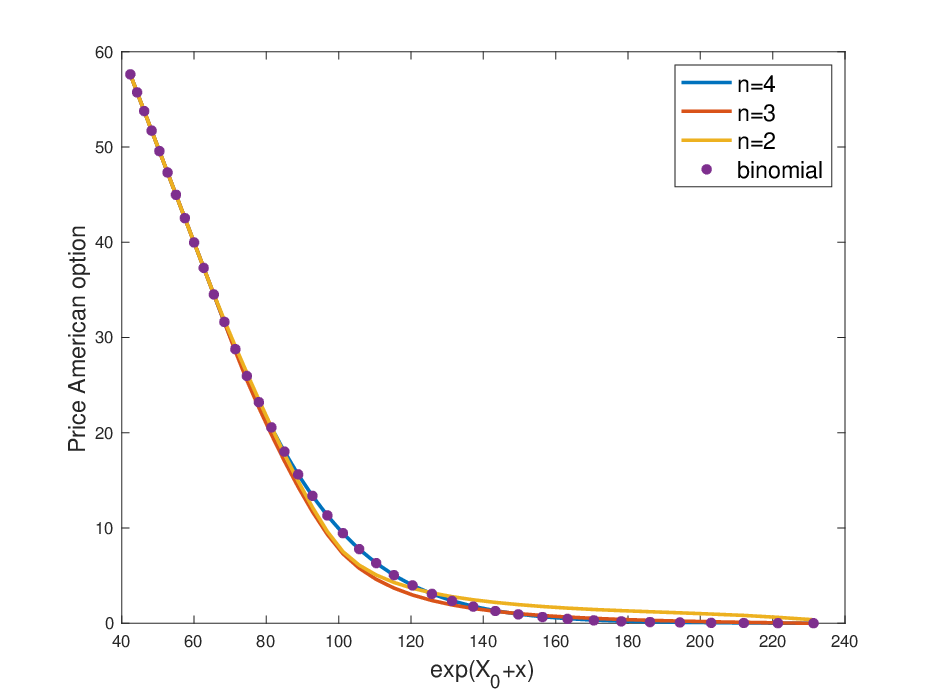
전형적인 블랙–숄즈 모형에서 미국형 풋 옵션으로 성능을 시험했습니다(이자율 6%, 변동성 40%, 현재가 = 행사가 100, 만기 6개월):
- 상태 40개, 4차 모멘트, 1,000 시간 스텝만으로 1,000 스텝 이항트리(업계 표준)와 비교해 평균 가격 차이가 약 0.01% 수준(10⁻⁴)이었습니다.
- 계산 속도가 핵심인데, 근사용 행렬을 한 번 구하는 데 약 0.75초가 걸리고, 그 행렬이 있으면 모든 초기 가격과 행사가에 대한 옵션 가격을 0.004초 만에 한꺼번에 계산했습니다. 가격표 전체를 뽑아야 하는 실무에서 매력적인 성능이에요.
- 환율처럼 구간 안에서 움직이는(자코비 확산) 더 복잡한 모형에서도, 시뮬레이션 기반의 유명한 알고리즘(Longstaff–Schwartz)보다 빠르게 비슷한 정확도를 냈습니다.
한계와 주의점
논문 자체가 "계산 비용·정확도·수렴의 체계적 분석은 이 논문의 범위 밖"이라고 못 박습니다. 근사이므로 보장된 오차 상한이 주어지지 않고, 공식 코드도 공개되지 않았어요. 실무에서는 이항트리나 몬테카를로와 교차 검증을 붙이는 것이 안전합니다.
이 테마의 공통 인사이트
이 달의 계산 연구들은 "언제 멈출까" 같은 경로 의존 문제를, 상태 몇 개 + 행렬 연산으로 환원하면 빠르고 정확하게 풀린다는 공통 교훈을 줍니다. 마르코프 가정을 완전히 버린 최적 정지 문제를 학습 이론으로 풀어 수렴을 보장하는 연구(1707.05250, 1707.05234), 조건부 평균 계산에 자동 미분을 붙여 그리스(민감도) 계산을 단순화한 연구(1707.04942)도 같은 계보입니다. "언제 연금을 살까"(1707.09494)조차 결국 '언제 멈출까' 문제라는 점이 이 테마의 폭을 보여 주죠.
함께 등장한 연구들
Discrete-type approximations for non-Markovian optimal stopping (1707.05250, 1707.05234): 가격이 '기억'을 가질 수 있는(비마르코프) 상황 — 예를 들어 과거 전체 경로가 변동성에 영향을 주는 모델 — 에서도 "언제 멈출까"를 계산하는 알고리즘을 수학적으로 보장합니다. 최신 연구들이 '시그니처' 같은 도구로 이 계보를 잇고 있어요.
On the free boundary of an annuity purchase (1707.09494): 은퇴 자금을 연금으로 바꾸는 '최적 시점'을 다룹니다. 내가 기대하는 수명(주관적)과 보험사가 가격에 쓰는 수명(객관적)이 다를 때, 언제 연금에 가입하는 게 유리한지의 경계를 수학으로 계산합니다. 투자와 보험이 만나는 지점의 흥미로운 문제예요.
테마 5: 거래비용은 수익률을 어떻게 바꾸는가 — 시장의 성격까지 바꾸는 마찰
왜 흥미로운가
거래비용은 흔히 '수수료'처럼 여기서 빼고 저기서 빼는 부수적인 것으로 여겨집니다. 하지만 생각해 보세요 — 모든 사람이 매매할 때 비용을 물면, 사람들은 덜 움직입니다. 덜 움직이면 가격이 원래 자리로 천천히 돌아오고요. 거래비용이 '개인의 비용'이 아니라 '수익률의 성격'을 바꾸는 힘이 된다면?
대표 논문: Equilibrium Returns with Transaction Costs
이 논문(A등급, 65.3)은 파리 도피네, 오사카, 워릭, 카네기 멜론의 수학 금융 연구진이 함께 쓴 이론 연구입니다. 위험 선호가 서로 다른 투자자들이 매매할 때 이차(이차항) 거래비용을 물고, 그 세계에서 시장이 청산되는 균형 수익률이 어떻게 되는지 처음부터 끝까지 풀어냅니다.
계산이 가능한 설정(평균–분산 선호 + 이차 비용)을 택했지만, 이 설정에서도 놀라운 결론들이 나옵니다:
- 거래비용이 있어도 가격은 안 바뀔 수 있습니다. 투자자들의 위험 선호가 같고 시장에 나오는 주식 양이 일정하면, 거래비용은 각자의 매매 패턴만 바꾸고 균형 가격은 마찰 없는 세계와 똑같습니다.
- 하지만 시장에 주식이 계속 풀리면(신규 상장, 유상증자), 이야기가 달라집니다. 새로 나온 주식을 사려면 거래비용을 물어야 하니, 그 보상으로 유동성 프리미엄 — 유동성이 낮은 자산이 더 높은 기대수익을 주는 현상 — 이 자동으로 생깁니다.
- 위험 선호가 다르면 프리미엄의 부호가 결정됩니다. 더 위험을 싫어하는 투자자들이 순매도자일 때 유동성 프리미엄이 양(+)이 됩니다. 이들이 매도할 동기가 더 강하므로, 시장이 청산되려면 사는 쪽에 더 나은 조건을 줘야 하기 때문이에요.
- 가장 흥미로운 결과: 거래비용은 수익률을 평균회귀하게 만듭니다. 펀더멘털이 아무리 제멋대로여도! 포트폴리오가 목표에 바로 도달하지 못하고 느릿느릿 조정되는 '둔탁함'만으로 수익률에 '원래 자리로 돌아오는 힘'이 생깁니다.
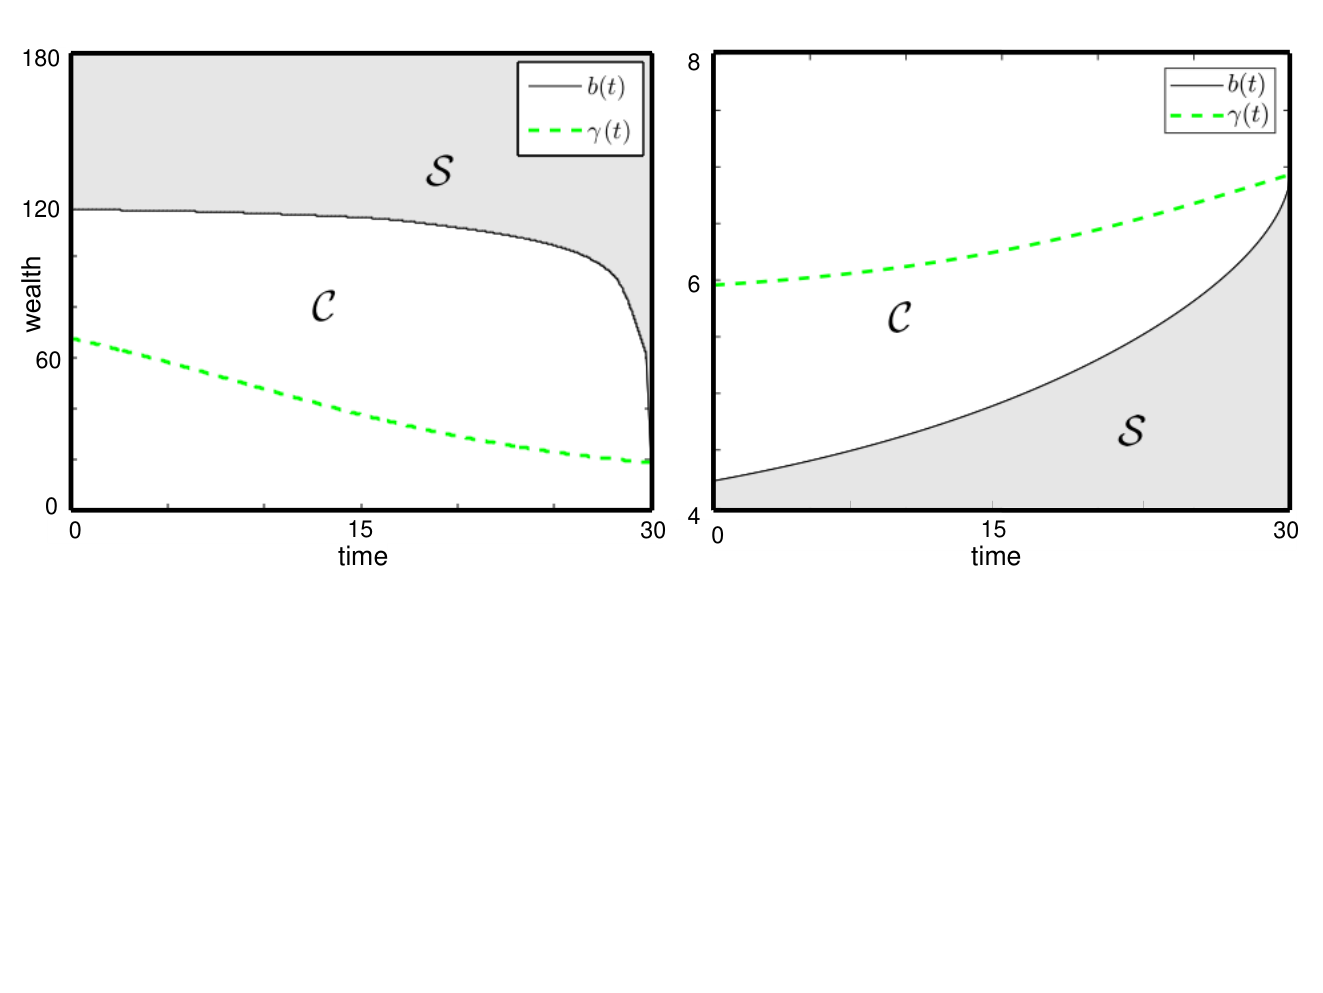
(대표 논문인 Equilibrium Returns with Transaction Costs는 수식 중심의 이론 논문이라 그림이 없어, 같은 테마의 1707.09494 논문 그림으로 대체했습니다.)
한계와 주의점
이차 거래비용(매매 속도에 비례하는 비용)이라는 '계산 가능한' 가정에 의존하고, 고정 수수료나 비선형 시장충격은 다루지 않습니다. 실증 검증이 목적이 아닌 순수 이론 연구이므로, 수치를 그대로 시장에 적용하기보다 방향과 메커니즘을 이해하는 도구로 쓰는 게 맞습니다.
이 테마의 공통 인사이트
이 테마의 논문들은 마찰이 시장의 성격 자체를 바꾼다는 관점을 공유합니다. 제약이 있는 시장에서의 투자자 최적화를 다루는 수학적 틀(1707.00199), 중국 주식에서 모멘텀과 역추세 수익이 시대에 따라 왔다 갔다 한다는 실증(1707.05552), 금리 곡선 모형들 사이의 정합성 분석(1707.02496)도 — 각자의 방식으로 "시간과 제약이 만드는 최적화"를 다룹니다.
함께 등장한 연구들
Utility maximization in constrained and unbounded financial markets (1707.00199): 거래 제한이 있고 수익이 무제한으로 커질 수 있는 현실적인 시장에서 "어떻게 투자하고 소비해야 최선인가"를 푸는 수학 프레임워크를 정리한 대형 연구입니다. 위 테마의 균형 이론이 딛고 있는 기반에 해당합니다.
Wax and wane of momentum and contrarian effects in China (1707.05552): 중국 주식시장에서 "오른 종목이 더 오른다"(모멘텀)와 "오른 종목은 다시 내린다"(역추세) 현상이 시기와 시장 여건에 따라 번갈아 나타남을 보여줍니다. 어떤 팩터도 영원하지 않다는, 팩터 투자자에게는 씁쓸하지만 중요한 실증이에요.
월 전체 Big Picture
2017년 7월의 금융 연구를 관통하는 메시지는 "언제 멈출까, 얼마나 빨리 팔까, 언제 걱정할까 — 이런 질문에 맞는 수학은 이미 존재하며, 단순할수록 실용적이다"입니다.
드로다운 논문은 샤프 0.5 전략의 7년 드로다운이 '정상'임을 보여 주는 몇 줄의 공식만으로 투자자의 수년짜리 고민에 답했습니다. 청산 논문은 '공매도 금지'라는 현실적 제약 하나만으로 '시간이 약'이라는 결론을 뒤집었고, 옵션 헤징 논문은 복잡한 국면 모형이 위기에서 40배의 차이를 만든다는 걸 보여줬습니다. 미국형 옵션 계산 논문은 상태 40개로 표준을 대체했고, 균형 이론은 거래비용이 수익률의 성격까지 바꾼다는 메커니즘을 밝혔죠.
흥미로운 점은 가장 실용적인 결과가 가장 단순한 형태를 띤다는 것입니다. 복잡한 모형이 이긴 게 아니라, 질문에 맞는 수학이 이겼습니다. 그리고 이 논문들이 다룬 질문들 — 드로다운 관리, 실행 비용, 헤지 모델 리스크, 유동성 프리미엄 — 은 9년이 지난 오늘의 AI 트레이딩 시대에도 여전히 같은 이름으로 남아 있습니다.
더 알아보기
이 글에서 다룬 논문들의 원문 링크입니다:
- You are in a drawdown. When should you start worrying? — A등급, 복합점수 65.4
- Optimal Trade Execution Under Endogenous Pressure to Liquidate — A등급, 복합점수 66.8
- Option Pricing and Hedging for Discrete Time ARHMM — B등급, 복합점수 64.6
- Markov cubature rules for polynomial processes — A등급, 복합점수 67.9
- Equilibrium Returns with Transaction Costs — A등급, 복합점수 65.3
- Surplus-Invariant, Law-Invariant, and Conic Acceptance Sets — A등급, 복합점수 67.0
- Discrete-type approximations for non-Markovian optimal stopping: Part II — A등급, 복합점수 66.1
- On the free boundary of an annuity purchase — A등급, 복합점수 66.8
참고하면 좋을 관련 연구: 드로다운 연구의 계보는 레비 모형으로의 확장(2011.06618), "좋은 해, 나쁜 샤프?"라는 질문으로의 발전(2302.08829)으로 이어지고, 미국형 옵션 계산 연구는 시그니처 기반 최적 정지(2312.03444) 같은 최신 흐름과 KB의 공유 엔티티로 연결되어 있습니다.
전체 S/A 논문 7편의 목록과 테마별 상세 분석은 백필 리포트 1707에서 확인할 수 있습니다.
📚 이 글에서 다룬 논문 (11편)
- AYou are in a drawdown. When should you start worrying?
Adam Rej, Philip Seager, Jean-Philippe Bouchaud
- AOptimal Trade Execution Under Endogenous Pressure to Liquidate: Theory and Numerical Solutions
Pavol Brunovský, Aleš Černý, Ján Komadel
- BOption Pricing and Hedging for Discrete Time Autoregressive Hidden Markov Model
Massimo Caccia, Bruno Rémillard
- AMarkov cubature rules for polynomial processes
Damir Filipović, Martin Larsson, Sergio Pulido
- AEquilibrium Returns with Transaction Costs
Bruno Bouchard, Masaaki Fukasawa, Martin Herdegen 외 1명
- ADiscrete-type approximations for non-Markovian optimal stopping problems: Part II
Sérgio C. Bezerra, Alberto Ohashi, Francesco Russo 외 1명
- AOn the free boundary of an annuity purchase
Tiziano De Angelis, Gabriele Stabile
- ASimulation of the drawdown and its duration in Lévy models via stick-breaking Gaussian approximation
Jorge González Cázares, Aleksandar Mijatović
- APrimal and dual optimal stopping with signatures
Christian Bayer, Luca Pelizzari, John Schoenmakers
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-10 월간S
2026년 10월 금융 AI 논문: 가짜 시장의 충격, 조용히 틀리는 트레이딩 코드, DeFi 금리의 덫
2026년 10월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 생성형 LOB 시뮬레이터의 시장 충격 검증 벤치마크(S등급), LLM이 작성한 트레이딩 코드의 침묵적 실패(MintEval), RL 포트폴리오 보상 정합성 인증, 캘린더 스프레드 옵션이 알려 주는 선물 간 의존구조, '더 예치하면 수익이 줄어드는' DeFi 금리 곡선까지.
 📊 2018-11 월간A
2018년 11월 금융 AI 논문: 800만 건의 주문이 밝힌 시장 충격의 법칙과 1/N 앞에 멈춘 포트폴리오 이론
2018년 11월 arXiv 금융 AI 연구를 5개 테마로 정리했습니다. 800만 건 기관 주문으로 확인된 시장 충격의 제곱근 법칙, 유럽 옵션 가격에서 변동성과 점프를 동시에 추출하는 보정, 아무것도 1/N을 이기지 못한 포트폴리오 전략 실증, 텔레그램 펌프앤덤프 412건 해부까지 담았습니다.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.