한 줄 요약: 인공지능이 금융을 점령하기 직전인 2017년 12월, 연구자들은 하나같이 같은 질문을 던지고 있었습니다 — "사람이 정해 놓은 가정 대신, 데이터가 말하는 대로 계산하면 어떨까?"
들어가며: 계산기 앞에서 일어난 작은 혁명들
주식 투자를 해 보면 매일 마주치는 고민이 있습니다. "내일 이 종목이 얼마나 흔들릴까?" 이 흔들림의 크기를 변동성이라고 부르고, 이 숫자 하나가 옵션 가격, 손실 한도, 포트폴리오 비중까지 좌우합니다. 그런데 이 중요한 숫자를 계산하는 공식은 1980년대에 정해진 틀(GARCH라는 방법)에 여전히 갇혀 있습니다.
2017년 12월에 arXiv에 올라온 금융 연구 72편을 살펴보면, 마치 약속이라도 한 듯 "그 틀을 벗어나 보자"는 시도들이 쏟아집니다. 신경망으로 변동성을 배우게 하거나(1편), 강화학습으로 옵션 가격을 배우게 하거나(1편), 심지어 확률 계산을 아예 포기하고도 성립하는 투자 이론을 세우거나(1편).
이 글은 그 달의 연구를 다섯 가지 흐름으로 나누어, 논문을 읽지 않은 분도 따라올 수 있게 풀어 씁니다. 수식은 최대한 빼고, 비유로 설명하되 숫자는 원문 그대로 옮깁니다.
테마 1: 변동성 — "흔들림의 크기"를 신경망이 배운다
일상의 비유로 시작해 볼까요
변동성 예측은 일기예보와 비슷합니다. 기상청은 "내일 강수 확률 60%"라는 하나의 숫자를 내지만, 실제 날씨는 습도·기압·바람이 얽힌 복잡한 시스템이죠. 금융의 변동성도 마찬가지입니다. 가격이 흔들리는 방식에는 제멋대로인 부분도 있지만, "어제가 조용하면 오늘도 조용한 편"이라거나 "시장이 떨어질 때 더 흔들린다"라는 패턴이 분명히 있습니다.
문제는 패턴의 모양을 사람이 미리 정해 놓는다는 점입니다. 대표적인 방법 GARCH는 "오늘의 변동성 = 어제 변동성의 잔재 + 어제 수익률의 충격" 같은 고정된 공식으로 이 패턴을 흉내 냅니다. 공식이 실제와 어긋나면? 예측은 틀립니다.
대표 논문: 신경망 확률적 변동성 모형 (NSVM)
이 달의 코호트에서 유일하게 가장 높은 평가를 받은 논문(A등급)이 바로 이 문제를 다룹니다: A Neural Stochastic Volatility Model (런던대·상하이교통대, 2017).
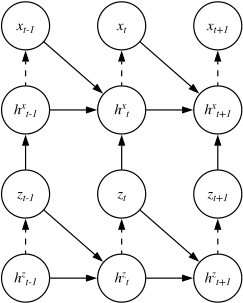
연구진은 두 개의 신경망을 짝으로 묶습니다. 하나는 "변동성이 어떻게 움직이는가"를 모형화하는 생성 네트워크, 다른 하나는 "관측된 가격만 보고 보이지 않는 진짜 변동성을 추정하는" 추론 네트워크입니다. 마치 요리사 한 명은 레시피를 만들고, 다른 한 명은 먹어 보고 간을 맞추는 셈이죠. 이 구조는 통계학의 "확률적 변동성 모형"이라는 고전적 틀을 신경망으로 다시 쓴 것이며, 가중치를 특정 값으로 고정하면 기존의 GARCH 계열까지 특수한 경우로 품습니다.
무엇을 알아냈나
실험은 중국 주식시장의 유동성 좋은 종목 162개, 약 7년치 일별 데이터로 진행했습니다(학습 2,000일, 테스트 570일). 성능은 "예측 분포가 실제를 얼마나 잘 설명했는가"(음의 로그우도, 낮을수록 좋음)로 측정합니다.
- 제안한 모형(NSVM)의 평균 점수 1.18354로, 모든 대조 모형 중 최우수였습니다.
- 업계 표준 GARCH(1,1)는 1.27051, 마르코프체인 몬테카를로 기반의 확률적 변동성 모형(stochvol)은 1.27098, 가우시안 프로세스 기반 모형은 1.34751이었습니다.
- 심지어 상호작용을 뺀 단순 버전만으로도 GARCH(1,1)를 162개 종목 중 142개에서 이겼습니다.
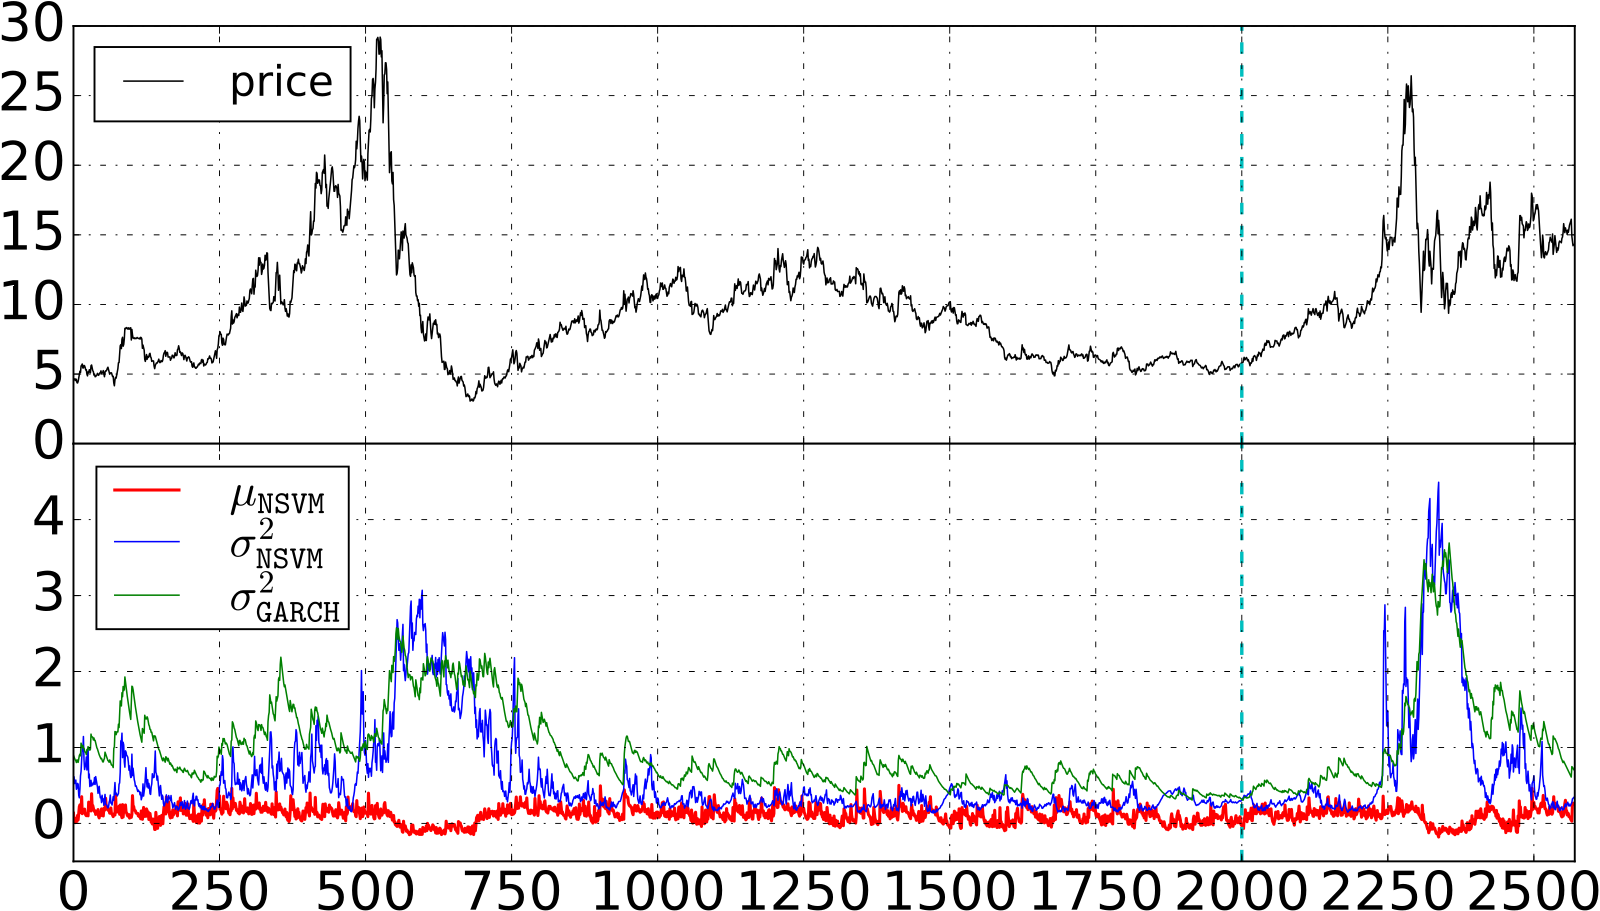
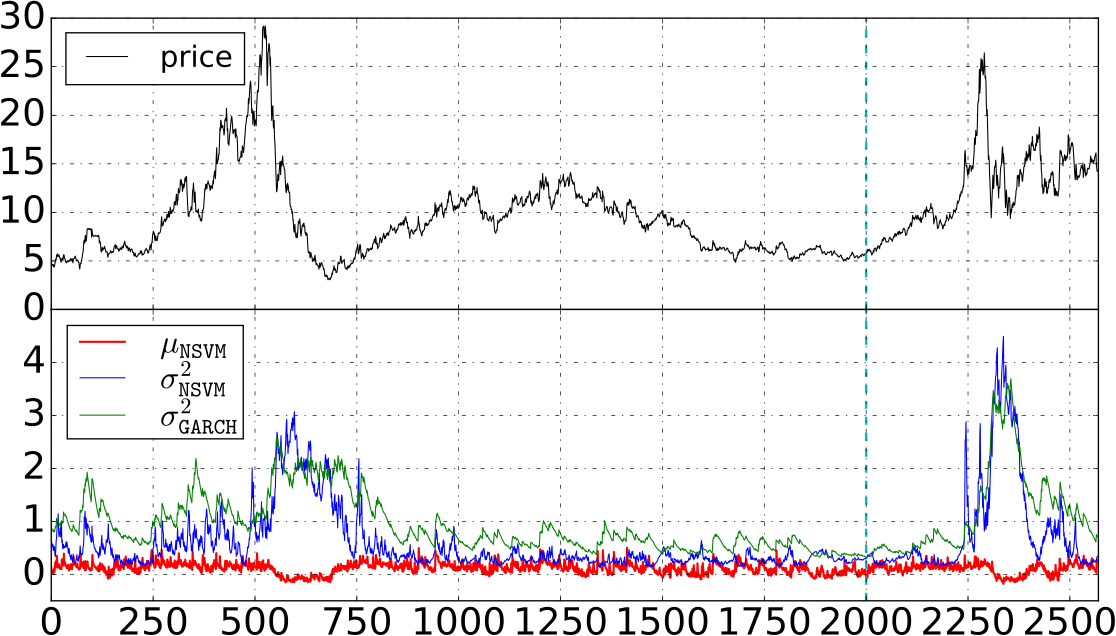
패턴도 흥미롭습니다. 시장이 잔잔할 때는 안정적으로, 급변할 때는 GARCH보다 더 빠르게 반응했습니다. GARCH는 "어제의 충격"에서 천천히 벗어나지만, 신경망 모형은 각 시점에서 현재의 흔들림 수준에 재빨리 적응합니다.
한계와 주의점
- 데이터가 중국 주식에 한정되어 있어 다른 시장에서의 재검증이 필요합니다.
- 학습 시간이 꽤 듭니다(당시 GPU로 약 2시간). 정확도가 좋아지는 대신 "공짜"는 아닙니다.
- 예측이 좋아졌다는 것이 곧 거래 수익이 좋아진다는 뜻은 아닙니다. 거래비용을 넣은 별도 검증이 필요합니다.
이 테마의 공통 인사이트
이 달의 변동성 논문들은 한목소리로 말합니다. 변동성에는 사람의 공식으로 다 못 담는 구조가 있다 — 신경망이든(1712.00504), 임계값 스위칭이든(1712.08329), 군집 분해든(1712.02138) 데이터에서 찾자는 것입니다. 심지어 "변동성이 오래 기억하는 것처럼 보이는 건 착각일 수 있다"는 반전 주장(1712.05121)까지 나오죠. 변동성을 둘러싼 기본 가정이 전부 다시 질문되고 있던 시기입니다.
테마 2: 옵션 가격 — 닫힌 공식이 없는 옵션을 12초 만에
일상의 비유로 시작해 볼까요
옵션은 "미래의 어느 시점에, 정한 가격으로 사거나 팔 수 있는 권리"입니다. 바닐라 옵션(그냥 사고팔 권리)은 1970년대의 유명한 공식(블랙-숄즈)으로 가격이 딱 나옵니다. 하지만 실제 시장에서 팔리는 옵션은 대개 까다롭습니다. "가격이 일정 선을 넘으면 무효가 되는" 배리어 옵션, "만기 전 아무 때나 행사할 수 있는" 미국형 옵션처럼요.
이런 옵션들은 공식이 없습니다. 대신 수치 계산으로 가격을 풀어야 하는데, 자산이 하나 늘어날 때마다 계산량이 폭증합니다. 2017년 12월 코호트에서 가장 두꺼운 논문 무리가 바로 이 "계산 문제"를 각자의 무기로 공략합니다.
대표 논문: 미국형 옵션을 몬테카를로로 풀기 (1712.07383)
Monte-Carlo methods for the pricing of American options (파리-도피느대 외 3개 기관, 2017)는 미국형 옵션의 핵심 난제 — "지금 행사할까, 기다릴까" — 를 다룹니다.
미국형 옵션의 가격에는 최적 정지 문제(언제 멈출 것인가)가 들어 있고, 전통적으로는 편미분방정식으로 풉니다. 문제는 자산이 여러 개면 방정식 풀이가 감당 못 할 정도로 무거워진다는 것. 몬테카를로 시뮬레이션은 자산 수에 덜 민감한 대신 "행사 경계"를 다루기 어렵습니다.
연구진은 이 문제를 "반응-확산 방정식"이라는 새로운 형태로 옮겨 담고, 몬테카를로 두 가지 방법을 시험합니다. 결과가 극명합니다.
- 나눗셈으로 매끄럽게 근사하는 방법: 기대와 달리 불안정하고 부정확했습니다. 근사 이론의 전제(함수가 매끄러워야 함)가 계단 모양의 행사 조건에서 완전히 깨지기 때문입니다.
- 무작위로 흐리는 방법: 행사 조건에 작은 무작위성을 섞어 부드럽게 만드는 발상인데, 놀랍도록 정밀했습니다.
실험에서 풋 옵션 가격 곡선 전체(주가 축 전체)를 5만 개 시뮬레이션 경로로 추정하는 데 걸린 시간은 12초였습니다(2014년 노트북 4코어 기준, 분산 감소 기법 없이). 정답(방정식 풀이)과 겹치는 추정치가 나옵니다.
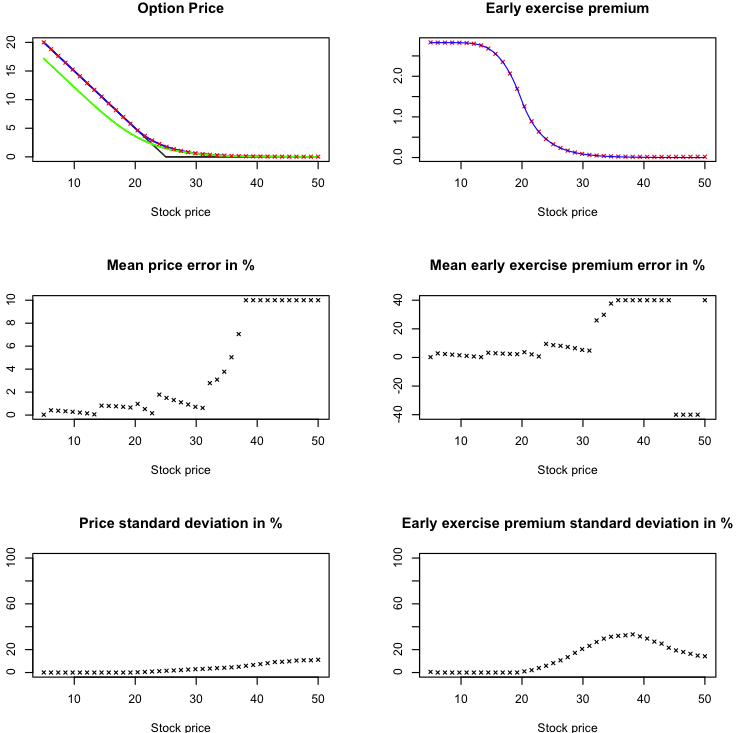
같은 달의 다른 논문들도 각자의 길로 같은 목표를 향합니다. Quantum Bounds for Option Prices는 모형을 아예 가정하지 않고 "관측된 시장 가격과 모순되지 않는 옵션 가격의 상한"을 양자역학의 수학으로 계산하고, 이중 배리어 옵션 급수 전개는 구조화 상품에서 흔한 낙인 옵션을 특수 함수의 급수로 빠르게 풉니다.
한계와 주의점
- 실험이 1차원(자산 하나)의 간단한 옵션에 머물러 있어, 논문의 자랑인 "다차원 확장"은 이론으로만 남아 있습니다.
- 시장의 현실(변동성 스마일, 거래비용)은 반영하지 않은 순수 계산 연구입니다.
이 테마의 공통 인사이트
"공식이 없는 옵션"을 푸는 비결은 직접 풀지 않는 것입니다. 급수로 바꾸거나(1712.08247), 트리의 꼬리를 잘라내거나(1712.08137), 조건을 무작위로 흐리거나(1712.07383). 계산 가능한 형태로 "환원"하면 실용적 속도가 열린다는, 수치 금융의 오래된 지혜가 이 달에도 확인됩니다.
테마 3: 인공지능, 금융에 발을 들이다 — 강화학습·어텐션·뉴스 읽기
일상의 비유로 시작해 볼까요
2017년은 인공지능이 바둑과 게임을 정복한 직후였습니다. 당시 연구자들은 "게임에서 쓰던 학습 기법을 주식과 옵션에도 써 볼 수 있지 않을까?"라는 자연스러운 질문을 품기 시작했죠. 이 달의 네 편은 그 첫 발자국들입니다. 규모는 작지만, 이후 8년간 금융 인공지능 연구가 실제로 걸어간 방향과 정확히 일치합니다.
대표 논문: QLBS — 옵션 가격과 헤지를 한 번에 배우기 (1712.04609)
QLBS: Q-Learner in the Black-Scholes(-Merton) Worlds (뉴욕대 공대, 2017)는 제목부터 재밌습니다. "블랙-숄즈 세계 속의 Q-학습자."
옵션 거래에서 딜러가 하는 일은 두 가지입니다. 적정 가격을 매기기와 위험을 헤지하기(주식과 현금으로 대응 포트폴리오를 짜기). 보통은 이 두 일을 각각 다른 공식으로 처리합니다. 이 논문의 발상은 한 줄입니다: 가격과 헤지를 하나의 "가치 함수(Q-함수)"에서 같이 꺼내자.
강화학습의 Q-학습은 "행동의 가치"를 데이터에서 배우는 방법입니다. 연구진은 "헤지 포트폴리오의 미래 위험"을 비용으로 넣은 상태에서 Q-학습을 돌리면, 그 함수의 값이 곧 옵션 가격이 되고 두 번째 인자가 곧 헤지 비율이 되도록 정식화했습니다. 이론적으로 시간 간격이 0으로 갈 때 유명한 블랙-숄즈 공식으로 정확히 수렴함을 보입니다.
또 하나의 보석: 이 모형은 마르코비치 포트폴리오 이론(현대 포트폴리오 이론의 출발점)의 확장이 블랙-숄즈 이론으로 수렴한다는 사실을 밝힙니다. 서로 다른 고전적 이론 두 개가 하나로 이어지는 지점을 포착한 셈입니다.
계산도 상냥합니다. 선형대수와 몬테카를로만 씁니다. 덕분에 저자는 이 환경을 "금융판 막대 세우기"(인공지능 학습의 고전적 교과서 문제)라 부르며, 여러 강화학습 알고리즘을 공정하게 비교하는 시험대로 제안합니다.
나머지 논문들: 씨앗들
- Temporal Attention Bilinear Network: 시계열에서 "언제가 중요한가"를 어텐션으로, "변수들이 어떻게 얽히는가"를 쌍선형 투영으로 동시에 학습하는 신경망 레이어. 고빈도 거래의 빠른 예측을 목표로 합니다.
- Listening to Chaotic Whispers: 뉴스 텍스트에서 주가 추세 신호를 뽑는 딥러닝 프레임워크. "말이 많은 날"의 불규칙한 정보를 정리해 보려는 시도입니다.
- Constant Space Bandits: 기록할 메모리가 거의 없을 때도 "새 상품을 시험해 볼까, 익숙한 걸 고를까"의 균형을 잡는 알고리즘 연구.
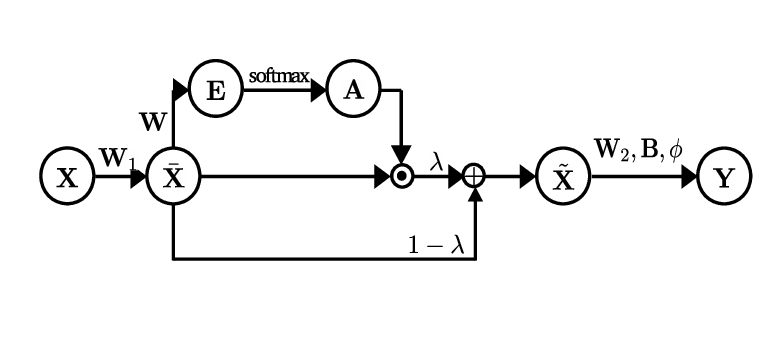
(위 그림은 이 테마의 대표 논문 QLBS(1712.04609)의 그림이 원문 추출에서 설명 없이 나와, 같은 테마의 1712.00975 그림으로 대체한 것입니다.)
한계와 주의점
- QLBS는 수리 프레임워크 논문입니다. 저자도 구체적 실험은 후속 과제로 남깁니다. "검증 완료"가 아니라 "검증할 수 있는 틀"을 제시한 글로 읽어야 합니다.
- 나머지 논문들도 거래비용과 체계적 백테스트 검증이 부족합니다. 2017년의 기술로는 당연한 한계입니다.
이 테마의 공통 인사이트
이 달의 연구자들은 정확히 올바른 순서로 접근합니다: 게임의 규칙을 단순하게 정하고(QLBS), 시간의 중요도를 학습하고(TABL), 비정형 정보를 다루고(뉴스), 탐색의 비용을 절약하고(밴딧). 아직 시장에 진입하지 못한 씨앗들이지만, 싹의 모양은 오늘날의 금융 AI와 똑같습니다.
테마 4: 포트폴리오 이론 다시 세우기 — "확률" 없이도 될까?
일상의 비유로 시작해 볼까요
투자 자문은 대개 이렇게 말합니다. "이 포트폴리오는 미래 수익 분포를 기준으로 최적화했습니다." 그런데 그 "미래 분포"는 아무도 실제로 본 적이 없습니다. 예측 모형이 틀리면 최적화 결과도 틀립니다. 요리로 치면, 레시피가 아니라 "맛있을 확률 계산"에만 의존하는 셈이죠.
2017년 12월의 포트폴리오 논문들은 이 의존성을 서로 다른 방향에서 공격합니다.
대표 논문: 확률 없이 세우는 포트폴리오 이론 (1712.09108)
Non-stochastic portfolio theory (런던대 로열홀러웨이, 2017)는 가장 급진적인 시도입니다. 제목 그대로 확률을 아예 쓰지 않습니다.
배경에는 유명한 이론이 있습니다. 펀홀츠의 "확률적 포트폴리오 이론"은 시장 전체 비중의 구조를 분석해, 단순한 롱온리 전략으로 시장가중 지수를 이기는 것이 가능함을 보여 줍니다(가중치를 아주 약간만 조정한 전략이죠). 다만 이 결론은 주가가 특정 확률 과정을 따른다는 가정 위에 있었습니다.
이 논문의 저자 블라디미르 보프크는 같은 결론을 경로 하나하나 단위에서 다시 증명합니다. "주가가 어떻게 흔들렸는지"라는 기록만으로 성장률을 정의하고, 확률 대신 "거의 모든 경로에서"라는 논리로 증명합니다. 결과는 상당히 강력합니다:
- 시장의 다양성이 유지되는 한, 엔트로피 가중 포트폴리오(시가총액 비중을 부드럽게 조정하는 전략)가 시장을 앞섭니다.
- 심지어 "종목당 시장 비중의 3배를 넘지 않는, 아주 점잖은 롱온리 전략"만으로도 성립합니다.
- 가장 근사한 해석은 이겁니다: "시장의 흔들림이 영원히 죽지 않는 한, 시장을 이길 길이 열려 있다." 시장이 완전히 효율적이라면 오히려 흔들림이 소멸해야 한다는, 통념을 뒤집는 이분법입니다.
같은 달의 다른 논문들도 한 방향입니다. 강건 효용 최대화는 "모형 자체가 틀릴 수 있다"를 전제로 최적 전략의 존재를 측도론적으로 확립하고(엄밀성 87점의 이론 연구), 부도 전염과 국면 전환을 넣은 포트폴리오 연구나 위기 시 비선형 상관을 반영한 연구들은 "의존 구조를 정확히 담자"고 말합니다.
한계와 주의점
- 배당, 거래비용, 유동성이 빠진 이상화된 모형의 이론 연구입니다. 실용성 점수는 48점으로 낮습니다 — 아름다운 증명이지 전략 공개가 아닙니다.
- "시장을 이긴다"의 조건(다양성 유지, 비퇴화)이 현실에서 어느 정도로 성립하는지는 실증이 필요합니다.
이 테마의 공통 인사이트
좋은 포트폴리오는 분포를 얼마나 잘 아느냐가 아니라, 분포 가정이 틀릴 때 얼마나 버티느냐에 달려 있습니다. 확률을 버리면(1712.09108) 경로가 답해주고, 불확실성을 넓게 잡으면(1712.07699) 해가 살아남고, 상관의 진짜 모양을 알면(1712.02661) 위기를 피할 수 있습니다.
테마 5: 위험 측정 — "얼마나 잃을까"를 데이터에서 읽기
일상의 비유로 시작해 볼까요
은행은 하루에 "최악의 경우 이 정도는 잃을 수 있다"라는 숫자(VaR)를 정해 두고, 그 선을 넘지 않도록 포트폴리오를 관리합니다. 그런데 이 숫자를 계산하는 업계 표준 방식은 1990년대 이후 거의 변하지 않았고, "수익률이 정규분포를 따른다"는 알 만큼 어긋난 가정을 씁니다. 2008년 금융위기가 그 약점을 여실히 보여 주었죠.
대표 논문: 코퓰라로 읽는 조건부 손실 (1712.05527)
A nonparametric copula approach to conditional Value-at-Risk (시드니 뉴사우스웨일스대, 2017)은 손실 한도를 "분포를 가정해 대입"하는 대신 데이터에서 직접 읽어내는 방법을 제안합니다.
핵심 도구는 코퓰라라는 개념입니다. 쉽게 말하면, 각 자산의 개별적인 성격은 놔둔 채 "어제와 오늘의 짝꿍 관계"만 따로 떼어 분석하는 렌즈입니다. 이 렌즈로 지난 수익률의 의존 구조를 비모수적으로(모양을 정해 두지 않고) 추정하면, "어제가 좋았으면 오늘의 분포 형태가 어떻게 달라지는지"가 그대로 드러납니다.
결과는 실용적입니다.
- S&P 500 실증(2011~2015년, 1,000거래일): 어제의 손익 상태에 따라 오늘의 손실 한도(95% 기준)가 0.01192에서 0.01543 사이로 움직입니다(무조건부 기준 0.01278). 어제가 흔들렸으면 오늘도 더 조심해야 한다는 것을 데이터가 말해 줍니다.
- 시뮬레이션 비교: 1,484개의 하루 앞 손실 예측에서 제안 방법이 대부분의 경우 기존 방법들(GARCH 계열, 가스 모형 등)보다 오차가 작았습니다. 다만 일부 경우엔 GJR-GARCH가 더 나아, "만능"은 아닙니다.
- 실전 백테스트(IBM 주식, 2011~2017년, 1,736거래일): 은행 규제 방식의 검정 3종에서 17개 방법 중 단 2개만 전 항목 통과 — 이 비모수 방법과 iGARCH-t뿐이었습니다. 모수 가정 없이 최고의 모수 모형에 필적한 결과입니다.
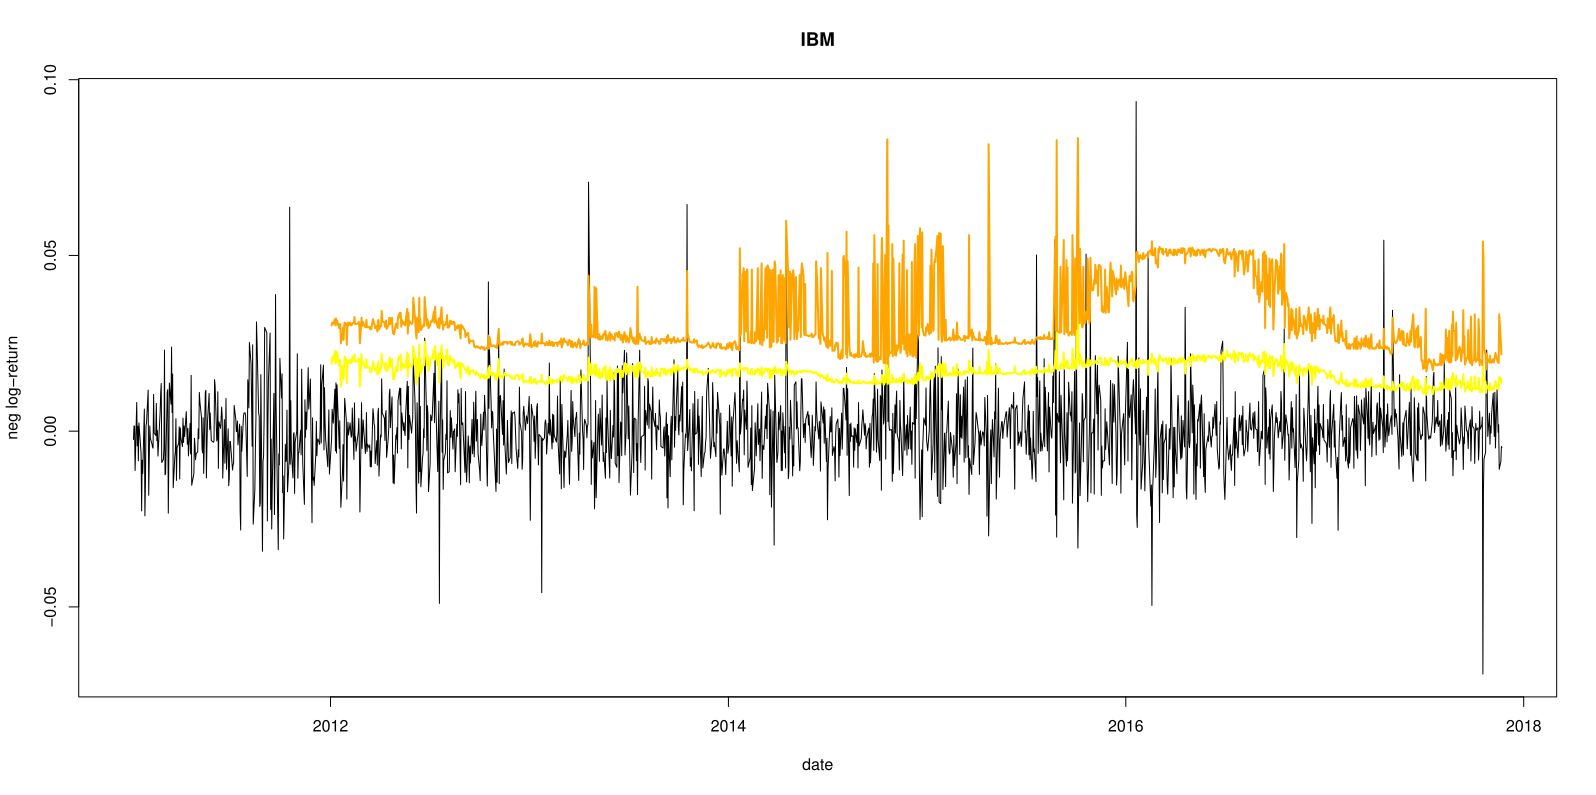
같은 달의 고빈도 데이터의 미시구조 소음 연구, 리드-래그와 차익거래의 경계 연구도 같은 문제 의식을 공유합니다: 시장 데이터의 진짜 구조를 소음과 섞지 않고 읽어내는 것이 리스크 관리의 출발점이라는 것을요.
한계와 주의점
- 데이터 양에 민감한 비모수 방법입니다. 분석 창(약 1년)을 어떻게 잡느냐에 결과가 달라질 수 있습니다.
- 이번 연구는 자산 하나씩입니다. 여러 자산을 동시에 보는 확장은 별개 과제입니다.
이 테마의 공통 인사이트
리스크 측정의 진보는 더 나은 공식이 아니라 더 적은 가정에서 나옵니다. 분포를 가정하지 않고(1712.05527), 소음을 벗기고(1712.01479), 선행-후행을 반영하면(1712.09854) 백테스트가 통과하는 예측이 됩니다.
이 달의 큰 그림: "정답을 가정하지 않는 계산"
다섯 가지 흐름을 관통하는 메시지는 하나입니다. 가정을 데이터로 바꾸자 모든 것이 나아졌다는 것.
- 변동성의 공식을 신경망에 맡기자 GARCH를 이겼고,
- 옵션의 까다로운 조건을 무작위로 흐리자 12초 만에 가격이 나왔고,
- 가격과 헤지를 하나의 학습 문제에 담자 모형이 필요 없어졌고,
- 확률 가정을 버리자 "시장을 이기는 포트폴리오"의 조건이 경로에서 드러났고,
- 손실 분포를 가정하지 않고 읽자 백테스트가 통과했습니다.
흥미로운 점은 이 달이 딥러닝이 금융을 점령하기 직전이라는 사실입니다. 코호트 72편 중 대부분은 여전히 수학의 완결판을 다듬는 연구들이었고, 인공지능 관련은 손에 꼽을 정도였죠. 하지만 그 몇 편의 방향이 이후 8년의 흐름을 정확히 예고했습니다. 이론의 엄밀함과 데이터 기반 학습이 어디서 만나게 될지 — 2017년 12월의 계산기 앞에서 이미 답이 쓰이고 있었습니다.
더 알아보기
원문 링크
이 글에서 깊게 다룬 논문들:
- A Neural Stochastic Volatility Model (1712.00504) — 신경망 확률적 변동성 모형 (A등급, 복합점수 65.7)
- Monte-Carlo methods for the pricing of American options (1712.07383) — 미국형 옵션의 몬테카를로 가격 산출 (복합점수 62.5)
- QLBS: Q-Learner in the Black-Scholes(-Merton) Worlds (1712.04609) — 강화학습 옵션 가격결정 (복합점수 64.3)
- Non-stochastic portfolio theory (1712.09108) — 비확률 포트폴리오 이론 (복합점수 63.6)
- A nonparametric copula approach to conditional Value-at-Risk (1712.05527) — 코퓰라 기반 조건부 VaR (복합점수 63.8)
가볍게 다룬 논문들: Quantum Bounds for Option Prices (1712.01385), 이중 배리어 옵션 (1712.08247), 점프-확산 옵션 트리 (1712.08137), 장벽 돌파 확률 (1712.00077), 이산 배리어 옵션 (1712.01060), 분수확산 옵션 (1712.04990), 이항·삼항 트리 개량 (1712.03566), 시간불일치 정지 문제 (1712.07806), Temporal Attention Bilinear Network (1712.00975), 뉴스 기반 주가 추세 예측 (1712.02136), 상수 공간 밴딧 (1712.09007), 강건 효용 최대화 (1712.07699), 부도 전염 포트폴리오 (1712.05676), 환율 개입의 최적 제어 (1712.02164), 비선형 상관과 포트폴리오 (1712.02661), 시간 네트워크로서의 주식시장 (1712.04863), 임계값 변동성 모형 (1712.08329), 군집 로그변동성 요인 (1712.02138), 가성 장기기억 (1712.05121), FARIMA 대안 (1712.03044), 고빈도 미시구조 소음 (1712.01479), 리드-래그와 무차익 (1712.09854), 다중 통화 리스크 리저빙 (1712.01319), 군집행동 입자 모형 (1712.01085), 터키 전력시장 청산 규칙 (1712.00235).
참고: 대표 논문들의 5차원 점수
| 논문 | 참신성 | 실용성 | 엄밀성 | 재현성 | 통찰 |
|---|---|---|---|---|---|
| 1712.00504 (신경망 변동성) | 74 | 68 | 67 | 43 | 72 |
| 1712.04609 (QLBS) | 73 | 66 | 58 | 43 | 72 |
| 1712.05527 (코퓰라 VaR) | 67 | 75 | 65 | 42 | 62 |
| 1712.09108 (비확률 포트폴리오) | 72 | 48 | 79 | 42 | 74 |
| 1712.07383 (미국형 옵션 MC) | 64 | 61 | 76 | 40 | 63 |
함께 보면 좋은 논문 (지식베이스 기준)
신경망 변동성 모형과 이어지는 후속 연구들:
- Neural Generalised AutoRegressive Conditional Heteroskedasticity (2202.11285) — GARCH를 신경망으로 일반화한 연구
- Deep Stochastic Volatility Model (2102.12658) — 깊은 확률적 변동성 모형
- Variational Heteroscedastic Volatility Model (2204.05806) — 변분추론 기반 변동성 모형
이 글은 arXiv 2017년 12월 코호트(게시 논문 72편, 관련 47편)를 OHSE AI Lab의 지식베이스 평가 기준으로 재구성한 월간 리뷰입니다. 모든 수치는 원문에서 그대로 옮겼으며, 평가 점수는 자체 기준임을 밝힙니다.
📚 이 글에서 다룬 논문 (33편)
- AA Neural Stochastic Volatility Model
Rui Luo, Weinan Zhang, Xiaojun Xu 외 1명
- BMonte-Carlo methods for the pricing of American options: a semilinear BSDE point of view
Bruno Bouchard, Ki Chau, Arij Manai 외 1명
- BA nonparametric copula approach to conditional Value-at-Risk
Gery Geenens, Richard Dunn
- BTemporal Attention augmented Bilinear Network for Financial Time-Series Data Analysis
Dat Thanh Tran, Alexandros Iosifidis, Juho Kanniainen 외 1명
- BListening to Chaotic Whispers: A Deep Learning Framework for News-oriented Stock Trend Prediction
Ziniu Hu, Weiqing Liu, Jiang Bian 외 2명
- BPricing double barrier options on homogeneous diffusions: a Neumann series of Bessel functions representation
Igor V. Kravchenko, Vladislav V. Kravchenko, Sergii M. Torba 외 1명
- Stochastic Multi-armed Bandits in Constant Space
David Liau, Eric Price, Zhao Song 외 1명
- BRobust expected utility maximization with medial limits
Daniel Bartl, Patrick Cheridito, Michael Kupper
- BRisk Sensitive Portfolio Optimization with Default Contagion and Regime-Switching
Lijun Bo, Huafu Liao, Xiang Yu
- BLinear and nonlinear market correlations: characterizing financial crises and portfolio optimization
Alexander Haluszczynski, Ingo Laut, Heike Modest 외 1명
- BEstimation for high-frequency data under parametric market microstructure noise
Simon Clinet, Yoann Potiron
- B
- BEfficient European and American option pricing under a jump-diffusion process
Marcellino Gaudenzi, Alice Spangaro, Patrizia Stucchi
- BFluctuation identities with continuous monitoring and their application to price barrier options
Carolyn E. Phelan, Daniele Marazzina, Gianluca Fusai 외 1명
- BA Numerical Method for Pricing Discrete Double Barrier Option by Lagrange Interpolation on Jacobi Node
Amirhossein Sobhani, Mariyan Milev
- BSeries representation of the pricing formula for the European option driven by space-time fractional diffusion
Jean-Philippe Aguilar, Cyril Coste, Jan Korbel
- BEnhancing Binomial and Trinomial Equity Option Pricing Models
Yong Shin Kim, Stoyan Stoyanov, Svetlozar Rachev 외 1명
- BOn the Singular Control of Exchange Rates
Giorgio Ferrari, Tiziano Vargiolu
- BStock market as temporal network
Longfeng Zhao, Gang-Jin Wang, Mingang Wang 외 3명
- BA cluster driven log-volatility factor model: a deepening on the source of the volatility clustering
Anshul Verma, Riccardo Junior Buonocore, Tiziana di Matteo
- BThe consentaneous model of the financial markets exhibiting spurious nature of long-range memory
Vygintas Gontis, Aleksejus Kononovicius
- B
- BMulti-currency reserving for coherent risk measures
Saul Jacka, Seb Armstrong, Abdel Berkaoui
- BA particle model for the herding phenomena induced by dynamic market signals
Hyeong-Ohk Bae, Seung-yeon Cho, Sang-hyeok Lee 외 1명
- BEmpirical comparison of three models for determining market clearing prices in Turkish day-ahead electricity market
Gökhan Ceyhan, Nermin Elif Kurt, H. Bahadir Sahin 외 1명
- BNeural Generalised AutoRegressive Conditional Heteroskedasticity
Zexuan Yin, Paolo Barucca
- B
- B
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2025-04 월간
AI가 정말 주식을 살 수 있을까? — 2025년 4월 금융 AI 연구 리뷰
2025년 4월 금융 AI 논문 321편을 분석한 월간 종합. LLM 에이전트의 실제 시장 실험, 레버리지 ETF의 숨겨진 복리 구조, 확산모형으로 수익률 시나리오 만들기, 퀀트 벤치마크 표준화, 고차원 포트폴리오 최적화까지 — AI가 진정으로 투자에 쓰이려면 무엇이 필요한지 5가지 테마로 살펴봅니다.
 🗓️ 월간 리뷰
포트폴리오의 '합리성'을 되찾다 — 2025년 3월 금융 AI 연구 리뷰
2025년 3월 금융 AI 논문 138편을 분석한 월간 종합. 포트폴리오 최적화의 비합리적 결함을 바로잡는 MMV 효용, 사모자산 배분의 5가지 현실 제약을 하나로 푸는 DKGP 모형, 헤지와 내부화 사이의 최적 균형, 시장 시뮬레이터의 진화, 그리고 이산에서 연속으로 연결되는 변동성 모델까지 — 포트폴리오의 '합리성'을 되찾기 위한 5가지 연구를 살펴봅니다.
 📊 2024-03 월간
주식 시장의 숨겨진 규칙을 찾다 — 2024년 3월 AI 퀀트 연구 하이라이트
2024년 3월에 나온 AI 퀀트 연구 중 가장 주목할 논문들을 살펴봅니다. 주식을 사고팔 때 일어나는 미세한 가격 움직임부터, 변동성의 비밀, 인공지능이 주가를 예측하는 방법까지 — 복잡해 보이는 연구를 일상의 비유로 풀어 설명합니다.