매달 arXiv에 쏟아지는 금융 연구 논문 중에서 가장 의미 있는 연구를 골라 정리합니다. 이번 글은 2017년 11월에 공개된 논문들을 지금의 눈으로 다시 읽은 회고 리뷰입니다.
한 줄 요약: "교과서의 공식은 깨끗한데 현실은 지저분하다" — 2017년 11월의 연구자들은 거래비용, 모형 오류, 계산 한계, 희귀 사건이라는 '지저분한 현실'을 수학에 끌어들이는 방법들을 내놓았고, 그 결과물들은 오늘날에도 그대로 쓸 수 있습니다.
들어가며: AI가 트레이딩을 점령하기 직전의 연구들
2017년 11월을 기억하시나요? 주식시장에서 '인공지능 트레이딩'은 아직 신문 기사에나 나오던 단어였고, arXiv의 금융 논문들은 대부분 연필과 종이로 증명하는 수학, 그리고 그 수학을 컴퓨터로 풀어내는 계산 기법에 대한 이야기였습니다.
흥미로운 점은, 이 '구식' 논문들이 다루는 질문들이 2026년의 우리에게도 똑같이 중요하다는 사실입니다. AI가 아무리 예측을 잘해도, 결국 거래비용과 유동성을 무시한 전략은 실제 돈을 잃고, 데이터가 조금만 달라져서 흔들리는 모델은 믿을 수 없으며, 백 년에 한 번 일어나는 위험에는 대비해야 하니까요.
이번 달 코호트는 논문 82편(우리 기준 관련 논문 44편)으로, A등급 6편을 중심으로 다섯 개 테마로 정리했습니다. 한마디로 "우아한 이론이 현실의 마찰 앞에서 어디까지 살아남는가"를 묻는 달이었습니다.
테마 1: 전기요금 헤징 — 우산 대여점의 딜레마
전기를 파는 회사를 상상해 보세요. 고객에게 "올겨울 당신이 쓸 전력량만큼 전기를 미리 사두겠다"는 계약을 팔았습니다. 그런데 고객이 실제로 쓸 전력량은 날씨에 달려 있죠. 한파가 오면 난방이 폭증하고, 온화하면 훨씬 덜 씁니다. 이 불확실성은 선물로 없앨 수 없습니다(전기는 고객이 쓴 만큼만 수요가 생기니까요). 마치 우산 대여점이 "올 여름 비가 얼마나 올지"를 미리 사고팔 수 없는 것과 같습니다.
문제는 여기서 끝이 아닙니다. 실제 시장에서는 (1) 한 번에 대량 주문을 넣으면 가격이 밀리고(시장 깊이 제한), (2) 거래비용이 들고, (3) 모형이 틀릴까 봐 실제로는 주 1회 정도만 헤지를 조정합니다. 교과서의 "연속적이고 공짜인 헤징"과는 완전히 다른 세계죠.
대표 논문: Variance optimal hedging with application to Electricity markets (1711.03733)
전력회사 연구소(EDF) 출신 저자가 이 모든 제약을 한꺼번에 넣은 최적 헤지 알고리즘을 처음으로 실용 형태로 내놓았습니다. 평균-분산 헤징(남은 위험의 분산을 최소화하는 헤지)에 동적계획법과 최소제곱 몬테카를로를 결합해, "제약이 있는 현실"에서 최적 전략을 계산합니다.
결과가 재미있습니다.
- 헤지가 없으면 포트폴리오의 잔여 분산이 1.114e+15(지수 표기: 1.114에 0이 15개)인데, 이상적인 연속 헤지를 하면 7.8628e+14로 약 30% 줄어듭니다.
- 그런데 2주에 한 번(총 8회)만 헤지를 조정해도 수치 최적 전략이 7.853e+14를 기록해, 연속 헤징에 거의 근접합니다. 이론의 연속 가정이 실제로는 그다지 아깝지 않다는 뜻이죠.
- 하지만 시장 깊이가 제한되면 상황이 달라집니다. 한 번에 처리할 수 있는 물량이 정해져 있으면 8회 헤지의 분산이 8.84e+14로 다시 나빠지고, 13회까지 늘려야 8.35e+14로 회복됩니다. 더 결정적인 건 전략의 모양이 바뀐다는 점입니다 — 제약이 걸리면 최적 전략은 "가능한 한 최대치를 팔아라"가 되어, 제약을 모른 채 공식을 쓰고 나중에 잘라낸(clipping) 전략과 완전히 갈라섭니다.
공통 인사이트: 헤징의 질을 결정하는 것은 예측 정확도만이 아니라 거래비용·유동성·조정 빈도라는 마찰입니다. 마찰을 무시한 최적 전략은 "약간 부정확한" 정도가 아니라 아예 다른 전략입니다.
같은 테마에서, 모형을 아예 가정하지 않고 "가격 경로가 어떤 범위 안에 있다"는 정보만으로 초헤징 가격을 정의한 이론 연구(1711.02764)와, 비례 거래비용 아래에서의 투자-소비 문제를 풀어낸 수치 연구(1711.01017)도 함께 읽어볼 만합니다.
테마 2: '적당히 강건하게' — 요리사의 간 보기 과학
정량 투자에서 가장 흔한 실패는 예측이 틀리는 게 아니라, 예측이 틀릴 수 있다는 사실을 레시피에 반영하지 못하는 것입니다. 과거 데이터만 보고 최적 포트폴리오를 짜면(요리사가 계량만 믿고 간을 안 보는 것과 같습니다), 데이터가 조금만 달라져도 해가 요동칩니다.
"그럼 아예 최악의 경우를 가정해서 보수적으로 가자"가 분포강건 최적화(DRO)라는 접근입니다. 그런데 여기서 고민이 생깁니다. "얼마나 보수적으로?" — 이 '강건성의 정도'를 나타내는 파라미터를 어떻게 정해야 할까요? 지금도 많은 모델이 "신뢰수준 95%" 같은 관성적인 값을 그냥 쓰고 있습니다.
대표 논문: Calibration of Distributionally Robust Empirical Optimization Models (1711.06565)
이 논문(주오대·브리티시컬럼비아대·싱가포르국립대 공동 연구)은 강건 최적화의 본질을 새롭게 읽습니다. 핵심 증명 하나: "최악의 경우에 대한 기대수익의 민감도가 보상의 분산과 같다"는 것입니다. 쉽게 말하면, 강건 최적화는 "수익을 크게"와 "모델이 틀려도 안 흔들림"이라는 두 목표를 동시에 다루는 문제라는 뜻입니다.
그리고 놀라운 결론이 따라옵니다. 강건성을 조금만 적용하면(파라미터 δ를 작게), 표본외(처음 보는 데이터)에서의 수익 변동성이 크게 줄어드는 반면, 기대수익에 미치는 손해는 거의 한 자릿수 더 작다는 것입니다. 즉 "적당히 강건하게"가 거의 공짜에 가까운 보험입니다.
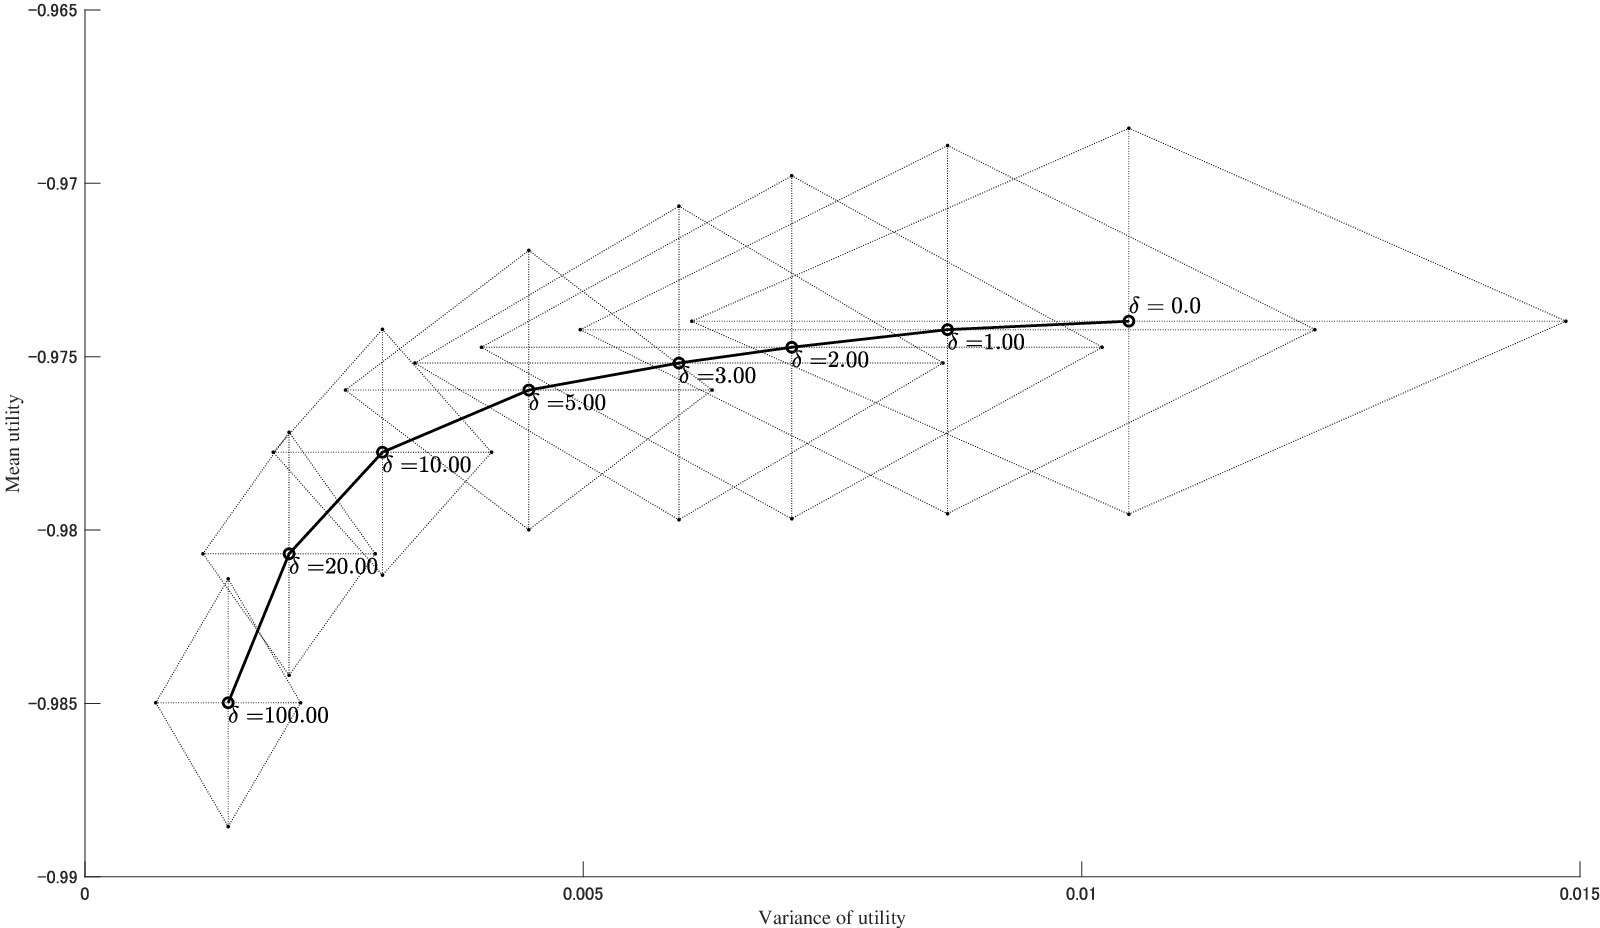
어떻게 δ를 정하냐고요? 논문은 데이터를 리샘플링(여러 번 다시 뽑아보기)해서 "표본외 평균-분산 프론티어"를 그려보고, 그 위에서 적당한 지점을 고르라고 제안합니다. 그렇게 구한 δ는 문헌의 표준 신뢰수준(90~95%)이 암시하는 값보다 훨씬 작고, 수익만 극대화하는 δ보다는 큰 — "무조건 보수적"도 "무조건 공격적"도 아닌 지점입니다.
공통 인사이트: 모형 불확실성에 대한 대응은 "얼마나 보수적이냐"의 감 문제가 아니라, 표본외 변동성을 데이터로 측정해 정하는 계량 문제입니다. 이 논문들은 이론적으로나 명시적으로나 "강건성의 정도"를 정량화해야 한다고 말합니다.
같은 테마의 논문들: 차입금리가 대출금리와 다르고 투자에 제약이 있을 때의 강건 최적 투자-소비 전략을 명시적으로 푼 연구(1711.02939), 확률조차 모를 때(나이트의언 불확실성)의 이산 전략 최적화(1711.03875), 그리고 샤프 비율 대신 시간 지평에 무관한 '파노 비율'로 장기 포트폴리오를 짜자는 교육적 노트(1711.10640)가 있습니다.
테마 3: 옵션 가격의 계산기 — 더 넓어진 울타리
옵션 가격을 계산하는 일은 보험료를 산정하는 일과 비슷합니다. 미래의 불확실한 사건(주가가 어디까지 움직일까)에 대한 확률 모형을 세우고, 그 모형에서 기대손해액을 계산해야 하죠. 문제는 현실적인 모형일수록 계산이 어려워진다는 것입니다. 주가가 가끔 폭락(점프)하고, 변동성 자체도 변하고(확률 변동성), 이런 걸 다 넣으면 계산이 폭발합니다.
지금까지 계산이 편한 모형들의 울타리는 '아핀 점프확산'이라는 수학 구조였습니다. 2017년 11월, 이 울타리가 '다항 점프확산'으로 넓어졌습니다.
대표 논문: Polynomial Jump-Diffusion Models (1711.08043)
이 논문은 "다항식의 평균은 다시 다항식으로 정리된다"는 성질을 가진 모형들의 통합 프레임워크를 세웁니다. 이 성질만 있으면 모멘트(평균, 분산 등)가 닫힌 형태로 계산되고, 그 모멘트들로 옵션 가격을 급수 전개할 수 있습니다. 아핀 모형은 이 넓은 세계의 일부분일 뿐이고, 점프·비선형 변환·시간 변경(레비 시간 변경)을 허용하면서도 계산 가능성은 유지됩니다. 엄밀성 점수 91점은 이 코호트에서 가장 높은 이론적 완성도입니다.
함께 보면 좋은 A등급: Option Pricing with Orthogonal Polynomial Expansions (1711.09193)
같은 달에 나온 이 논문은 '다항 모형'의 계산을 실무 수준으로 끌어올립니다. 야코비, 헤스톤, 스타인-스타인, 홀-화이트 등 이름난 확률변동성 모형들의 옵션 가격과 그리스(델타, 감마 같은 민감도)를 직교다항식 급수로 계산하는 방법을 유도했는데, 수치 실험에서 기존의 푸리에 변환 기반 방법과 대등한 속도와 정확도를 냅니다. 게다가 가격의 변수별 기울기(그라디언트)까지 한 번에 나오므로, 캘리브레이션처럼 계산을 반복해야 하는 작업에 특히 유용합니다.
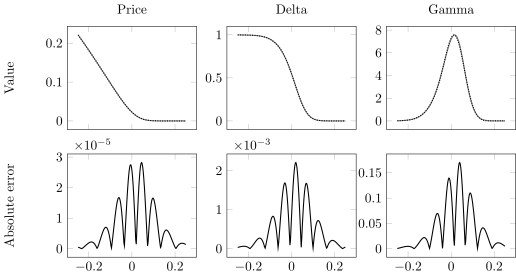
공통 인사이트: 계산이 가능한 모형의 범위가 넓어질수록, "현실적인 특성(점프, 변동성의 변동성)"과 "실시간 계산"이 양립할 수 있습니다. 모형을 고를 때 계산 가능성까지 설계 조건으로 넣으라는 메시지입니다.
이 테마의 보석 같은 논문들: 유럽형 풋 가격만으로 아메리칸 풋의 '모형 무관 상한'을 구하는 연구(1711.06466), 국소-확률 변동성 모형의 캘리브레이션을 역문제로 정식화한 연구(1711.03023), 레짐 전환 모형의 옵션 가격을 직접 푸는 방법(1711.08883)이 있습니다.
테마 4: 일기 예보의 교훈 — "내일 오를까"가 아니라 "확률이 어떻게 될까"
"내일 주가가 오를까요?"라는 질문에 "오른다/내린다"로 답하면 정보의 대부분을 버리는 셈입니다. 일기 예보가 "내일 기온 23도" 하나만 말하는 대신 "비 올 확률 30%, 기온 20~26도"라고 말하는 것과 비교해 보세요. 분포 전체를 예측해야 리스크 관리와 트레이딩에 쓸모가 있습니다.
대표 논문: Forecasting dynamic return distributions based on ordered binary choice (1711.05681)
이 논문은 단순한 아이디어로 분포 예측의 안정성을 높였습니다. 수익률의 분위수별로 "오를까 내릴까"를 예측하되(이항 선택 모형), 분위수를 잇는 계수를 하나의 매끄러운 함수로 연결해서 파라미터 수를 크게 줄인 것입니다. 예측변수도 과거 지표와 과거 변동성 프록시라는 단순한 두 가지뿐입니다.
미국 유동성 상위 주식 29개로 검증한 결과가 인상적입니다. 예측 품질 점수(Brier, CRPS)는 GARCH 같은 기존 모형들과 대등했고, 진짜 성과는 트레이딩에서 드러났습니다. 주식 보유와 무위험자산 사이를 오가는 단순 타이밍 전략에서:
| 전략 | 평균 수익 | 변동성 |
|---|---|---|
| 매수 후 보유 (벤치마크) | 0.806 | 0.244 |
| 개별 로짓 모형 | 1.088 | 더 낮음 |
| 제안 모형(순서형 로짓) | 1.296 | 개별 로짓과 비슷하게 낮음 |
(논문 표 3 기준 수치이며, 단위는 원문 그대로입니다.)
위험 대비 수익인 샤프 비율은 29개 종목 전반에서 제안 모형이 가장 높았고, 누적 수익 곡선도 시간에 걸쳐 꾸준하면서 낙폭이 가장 작았습니다. 심지어 전 기간 우상향이던 엑슨모빌처럼 "매수 후 보유를 이기기 어려운" 종목에서도 마찬가지였습니다.
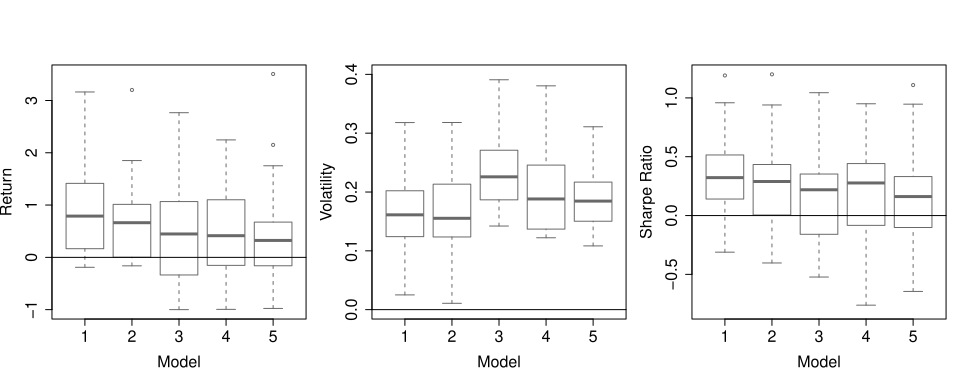
공통 인사이트: 시장의 움직임을 하나의 예측값이 아니라 확률 분포로 다루면, 리스크 관리와 트레이딩 신호가 모두 좋아집니다. "얼마나 오를까"보다 "오를 확률과 내릴 확률의 균형이 어디로 이동했을까"가 더 유용한 질문입니다.
같은 테마의 연구들: 시장이 중기에는 추세를 따르고 장기에는 평균회귀한다는 실증 — 가격이 가치에서 2배 이상 벗어나지 않는다는 '블랙의 직관'을 뒷받침하는 연구(1711.04717), 기업 재무제표를 예측해 팩터 투자를 개선하는 연구(1711.04837), 거래에 대한 시장 전체의 반응을 특이값 분해로 분석한 연구(1711.07630), 그리고 변동성의 '거칠기'를 허스트 지수 0의 극한으로 다룬 수리 연구(1711.00427)가 있습니다.
테마 5: 백 년에 한 번의 홍수 — 댐을 설계하는 확률의 기술
댐을 설계할 때 "백 년에 한 번 오는 홍수"에 견디게 만듭니다. 그런데 이 "백 년에 한 번"의 확률을, 정말 100년을 지켜보며 측정할 수는 없습니다. 금융에서도 같은 문제가 있습니다. 대형 포트폴리오의 동시 부도 확률처럼 거의 일어나지 않지만 일어나면 치명적인 사건은, 그냥 시뮬레이션을 돌려서는 구할 수 없습니다. 천만 번 돌려도 한 번도 안 일어나니까요.
대표 논문: Efficient Exponential Tilting for Portfolio Credit Risk (1711.03744)
이 논문(푸단대·중화학술원)은 우아한 해법을 제시합니다. "일어나지 않는 사건을 자주 일어나게 만든 뒤, 결과를 다시 보정"하는 중요도표본추출이라는 기법입니다. 비유하자면, 홍수 시뮬레이션에서 물을 자주 터뜨려 놓고 나중에 "이건 실제보다 과장된 상황"이라는 가중치를 붙이는 것입니다. 구체적으로는 다요인 정규 혼합 코퓰라로 채무자 간 비대칭 의존(꼬리에서 함께 무너지는 구조)을 모형화하고, 충분통계량 기반의 지수 틸팅으로 샘플링 분포를 바꿉니다.
효율이 상상 이상입니다.
- 채무자 250명 기준, 손실 확률이 4.38e-8(약 천만 분의 0.4)인 극단 사건에서 제안 방법의 분산 감소 요인이 최대 1.61e7배(1,610만 배)에 달했습니다. 사건이 드물수록 이점이 더 커집니다.
- 기존의 지수 측도 변경, 조건부 몬테카를로, 크로스엔트로피 결합 방법들과 견주어 전반적으로 우수하거나 대등했습니다.
- 손실분포를 계산하는 고속 푸리에 변환(FFT) 근사는 해석적 정답과 비교해 오차가 1e-15 수준 — 사실상 정확합니다.
공통 인사이트: 희귀 사건의 확률은 "더 많이 시뮬레이션"이 아니라 "더 똑똑하게 시뮬레이션"으로 해결합니다. 극단 리스크를 다루는 모든 실무(신용 VaR, 스트레스 테스트)에 적용되는 원리입니다.
같은 테마에서, 금리·환율의 부도 시점 점프가 콴토 CDS 가격에 미치는 영향을 편미분방정식으로 푸는 연구(1711.07133)도 읽어볼 만합니다.
한계와 주의점
2017년 11월 연구들에도 분명한 한계가 있습니다.
- 검증 범위의 제한: 수익률 분포 예측 연구는 미국 대형 유동주 29개, 신용위험 연구는 채무자 250명이라는 설정에서의 검증입니다. 다른 시장, 다른 규모에서 그대로 통한다고 장담할 수 없습니다.
- 가정의 무게: 강건 최적화 연구는 매끄러운 목적함수라는 가정 위의 점근적 이론이고, 헤징 연구의 핵심 실험은 거래비용이 0인 설정에서 이뤄졌습니다. 현실의 거래비용은 실제로 전략을 바꾸는 변수라서, 이 '0 가정'은 실무 적용 시 반드시 다시 채워야 할 부분입니다.
- 재현성 점수: A등급 논문들의 재현성 점수가 42~58로 대체로 낮습니다(분포 예측 연구만 72). 수학이 뛰어나다는 뜻이지, 코드와 데이터가 공개되어 있다는 뜻은 아닙니다. 실무에 옮기려면 구현 재작업이 필요합니다.
- 시대의 한계: 이 코호트에는 강화학습·LLM 기반 트레이딩 연구가 없습니다. 예측 기법은 통계 모형 중심이라, 이후 딥러닝 계열이 제공한 표현력에는 미치지 못합니다. 다만 그 딥러닝 연구들조차 결국 여기서 다룬 문제(거래비용, 불확실성, 극단값)를 피해 갈 수는 없었습니다.
그래서 투자/실무엔?
- 전략을 짤 때 거래비용과 유동성을 '나중에'가 아니라 '처음부터' 넣으세요. 2017년의 헤징 연구가 보여주듯, 제약은 전략을 약간 나쁘게 만드는 게 아니라 전략 자체를 바꿉니다.
- 모델의 하이퍼파라미터를 감으로 정하지 마세요. '적당히 강건하게'의 논리처럼, 리샘플링으로 표본외 변동성을 측정해 정하면 거의 공짜로 안정성을 얻습니다.
- 예측은 분포로 하세요. "오를까" 대신 "오를 확률"을 추정하면, 리스크 관리와 타이밍 전략이 모두 좋아진다는 것이 29개 종목의 실험 결과였습니다.
- 극단 리스크는 샘플링을 바꿔서 계산하세요. 천만 배 효율의 사례처럼, 드문 사건은 '더 많이'가 아니라 '더 똑똑하게' 시뮬레이션해야 합니다.
더 알아보기
이 글에서 다룬 A등급 논문 6편의 arXiv 링크와 5차원 평가 점수입니다(참신성 / 실용성 / 엄밀성 / 재현성 / 통찰, 복합점수 기준 내림차순).
| 논문 | 복합점수 | 5차원 점수 |
|---|---|---|
| Variance optimal hedging with application to Electricity markets (1711.03733) | 72.1 | 70 / 76 / 78 / 58 / 72 |
| Polynomial Jump-Diffusion Models (1711.08043) | 71.7 | 78 / 63 / 91 / 42 / 76 |
| Calibration of Distributionally Robust Empirical Optimization Models (1711.06565) | 71.2 | 70 / 72 / 83 / 42 / 78 |
| Option Pricing with Orthogonal Polynomial Expansions (1711.09193) | 68.8 | 72 / 70 / 82 / 43 / 68 |
| Efficient Exponential Tilting for Portfolio Credit Risk (1711.03744) | 68.6 | 73 / 74 / 77 / 42 / 68 |
| Forecasting dynamic return distributions based on ordered binary choice (1711.05681) | 67.8 | 67 / 68 / 68 / 72 / 65 |
이 외에도 테마별 보석 같은 논문들(경로별 초헤징, 파노 비율, 아메리칸 풋 상한, 블랙의 직관 등)은 각 테마 섹션의 링크에서 확인하세요.
📚 이 글에서 다룬 논문 (19편)
- A
- ACalibration of Distributionally Robust Empirical Optimization Models
Jun-Ya Gotoh, Michael Jong Kim, Andrew E. B. Lim
- AOption Pricing with Orthogonal Polynomial Expansions
Damien Ackerer, Damir Filipovic
- AEfficient Exponential Tilting for Portfolio Credit Risk
Cheng-Der Fuh, Chuan-Ju Wang
- AForecasting dynamic return distributions based on ordered binary choice
Stanislav Anatolyev, Jozef Barunik
- BPathwise superhedging on prediction sets
Daniel Bartl, Michael Kupper, Ariel Neufeld
- BConstrained portfolio-consumption strategies with uncertain parameters and borrowing costs
Zhou Yang, Gechun Liang, Chao Zhou
- BNotes on Fano Ratio and Portfolio Optimization
Zura Kakushadze, Willie Yu
- B
- BThe Calibration of Stochastic-Local Volatility Models - An Inverse Problem Perspective
Yuri F. Saporito, Xu Yang, Jorge P. Zubelli
- BA Direct Solution Method for Pricing Options in Regime-switching Models
Masahiko Egami, Rusudan Kevkhishvili
- BBlack was right: Price is within a factor 2 of Value
J. P. Bouchaud, S. Ciliberti, Y. Lempérière 외 3명
- BImproving Factor-Based Quantitative Investing by Forecasting Company Fundamentals
John Alberg, Zachary C. Lipton
- BStatistical properties of market collective responses
Shanshan Wang, Sebastian Neusüß, Thomas Guhr
- BFractional Brownian motion with zero Hurst parameter: a rough volatility viewpoint
Eyal Neuman, Mathieu Rosenbaum
- BInfluence of jump-at-default in IR and FX on Quanto CDS prices
A. Itkin, V. Shcherbakov, A. Veygman
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2025-12 월간
크립토 백테스트가 거짓말하는 이유, 그리고 2025년 12월 퀀트 연구의 다섯 가지 흐름
2025년 12월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 만한 다섯 가지 흐름을 살펴봅니다. 크립토 백테스트의 과대평가 문제부터 팩터 알파의 수명까지, 실전에 가까워지는 퀀트 연구의 최신 동향을 쉽게 풀어 설명합니다.
 📊 2024-12 월간
2024년 12월 AI 퀀트 연구 종합: 포트폴리오의 현실 적응기
2024년 12월 arXiv에 올라온 AI 퀀트 연구를 5가지 테마로 정리합니다. 포트폴리오 최적화의 강건성, 연속시간 강화학습, 금융 정보 신경망, 미시구조의 확산모델, LLM 감성분석까지 — 이론이 현실의 불확실성과 마주한 이야기.
 📊 2023-12 월간A
2023년 12월의 금융 AI 연구: 모형을 덜 믿고, 데이터를 더 믿는 다섯 가지 이야기
2023년 12월 arXiv의 금융 연구를 5개 테마로 정리했습니다. 경로를 기억하는 옵션 가격결정(시그니처), 최악의 시나리오를 계산하는 리스크 측도(약한 최적수송), 모형 없이 포트폴리오를 배우는 강화학습, 1밀리초 만에 독성 주문을 탐지하는 온라인 베이지안 신경망, 시간이 지나도 약속을 지키는 균형 전략까지 — 2023년 말 금융공학의 흐름을 쉽게 풀어 설명합니다.