"이론이 예쁜 가정을 버리고, 계산이 마찰·꼬리·사람의 행동을 담기 시작한 달." 2018년 2월에 나온 금융 연구들을 한 문장으로 요약하면 이렇다 — 거래비용과 시장충격까지 넣어서 헤지 전략을 신경망으로 직접 짜자는 제안, 아무리 빨리 계산해도 오차가 얼마나 남는지 정직하게 밝힌 아시안 옵션 가격식, 유럽 주식시장에서 실제로 쪼개 팔린 큰 주문 150만여 건이 남긴 흔적의 측정, "대형 사고가 날 확률"을 계산하는 비용을 크게 줄인 시뮬레이션 기법, 그리고 "사람들은 언제 추세를 쫓다가 언제 기본가치로 돌아가는가"를 데이터에서 구조적으로 추정한 연구. 2018년 초, 지금 우리가 쓰는 많은 실무 도구들이 여기서 갈라져 나갔다.
들어가며: 완벽한 공식 대신, 현실의 마찰
금융을 배우면 처음 만나는 공식이 있다. 옵션 가격을 매기는 블랙숄레스 공식, 포트폴리오를 짜는 마코위츠 최적화 같은 것들이다. 이 공식들은 아름답지만 하나의 전제 위에 있다 — 거래에 비용이 없고, 시장이 완벽하게 매끄럽다는 가정이다.
현실은 다르다. 주식을 사고팔면 수수료와 세금이 나가고, 큰 주문을 한꺼번에 내면 가격이 밀린다. 게다가 시장은 "정상적인 평온"만 있는 것도 아니다 — 가끔은 2008년 같은 위기가 오고, 2017년 말 폭등했던 비트코인은 2018년 초에 폭락했다. 이 달의 논문들은 공통적으로 이렇게 묻는다. "가정을 조금씩 풀어 버리면, 계산은 어떻게 달라지는가?"
흥미로운 점은, 이 달의 상위 논문들이 "다음 달에 오를 종목"을 거의 묻지 않는다는 사실이다. 대신 헤지의 비용, 옵션 가격의 계산 속도, 큰 주문이 시장을 움직이는 방식, 위험 확률을 계산하는 효율, 투자자의 심리 변화 같은 "계산의 인프라" 문제가 상위권을 채웠다. 다섯 갈래로 풀어 보자.
테마 1: 헤지의 세대 교체 — "수수료까지 넣고 계산하는 헤지"
은행의 헤지 데스크에서 벌어지는 일
파생상품을 파는 은행은 고객에게 받은 위험을 없애기 위해(헤지) 주식·옵션을 사고판다. 교과서대로라면 "델타"라는 숫자만 계산해서 그 비중만큼 사고팔면 끝이다. 그런데 실제 트레이더는 여기에다 "오늘 수수료가 비싸니 조금만 조정하자", "이 종목은 물량이 적어 큰 주문을 못 받는다" 같은 판단을 얹는다. 즉 교과서의 헤지 위에 사람의 수정 사항이 덧붙여지는 셈인데, 이 수정이 얼마나 값을 깎아 먹는지, 어떻게 하면 최적인지에 대한 계산은 오랫동안 비어 있었다.
Deep Hedging (1802.03042): 헤지 전략을 신경망으로 짜다
2018년 2월, JP 모건과 ETH 취리히의 연구진(Hans Bühler, Lukas Gonon, Josef Teichmann, Ben Wood)이 발표한 Deep Hedging은 이 빈칸을 정면으로 파고들었다. (이 논문은 JP 모건이 참여한 연구로, 논문 말미에 "저자들의 견해이며 JP 모건의 공식 입장이 아니다"는 면책 고지가 있다 — 산업계 연구라는 점을 미리 밝혀 둔다.)
핵심 아이디어는 놀랍도록 단순하다. "어떤 주식을 얼마나 들고 있을지"를 결정하는 함수 자체를 신경망으로 만들고, 그 신경망을 거래비용·시장충격·유동성 제약이 들어간 환경에서 직접 학습시키자.
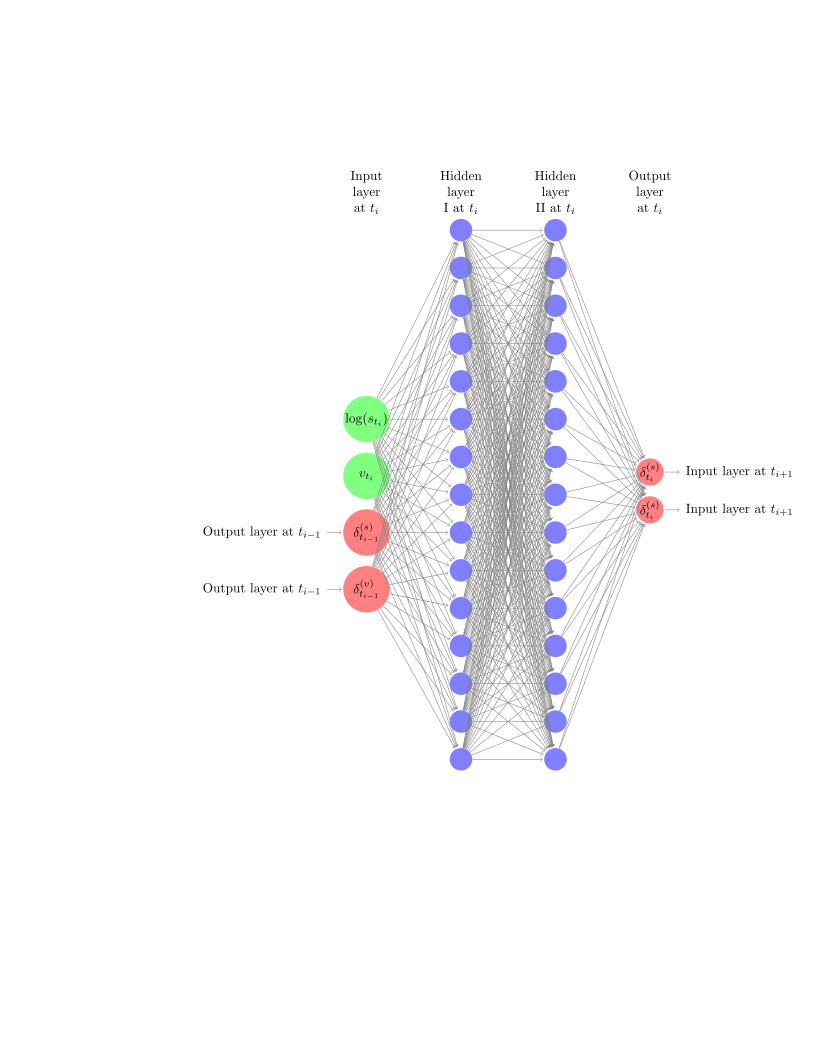
자세히 보면 이렇다.
- 입력이 가격만이 아니다. 신경망은 주가·변동성뿐 아니라 트레이딩 시그널, 뉴스 분석, 직전 헤지 결정까지 입력으로 받을 수 있다 — 사람이 트레이더가 참고하는 정량 정보를 그대로 넣는다.
- 목표 함수를 "위험"으로 정한다. 기대수익을 최대화하는 대신, CVaR 같은 '나쁜 상황에서 얼마나 잃는가'를 측정하는 위험 척도(볼록 위험측도)를 최소화한다. 위험을 얼마나 싫어하느냐(위험회피 정도)에 따라 전략이 달라진다.
- 시장 모델에 의존하지 않는다. 기존 방식은 시장이 어떻게 움직이는지에 대한 모델(예: 블랙숄레스)이 있어야 계산이 됐다. Deep Hedging은 미래 가격 경로 표본만 있으면 된다. 덕분에 '델타'나 '리스크중립 가격' 같은 중간 계산이 통째로 사라진다(논문은 "greek-free"라고 표현한다).
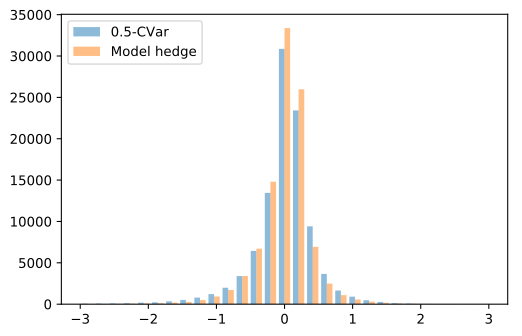
무엇을 알아냈을까? 논문은 합성 시장(헤스톤 변동성 모형)에서 실험했다.
- 거래비용이 없을 때, 신경망 헤지는 교과서식 모델 헤지와 사실상 같은 성적을 냈다 — 신경망이 '정답'을 제대로 학습했다는 뜻이다. 이때 옵션의 위험중립 가격은 1.69인데, 위험을 중간 정도(50% CVaR) 싫어하는 투자자 기준의 '무차등 가격'은 1.94로 올라간다. 위험을 극단적으로(99% CVaR) 싫어하면 3.49까지 올라가고, 헤지 전략의 모양도 확연히 달라진다.
- 거래비용이 1%만 있어도 상황이 달라진다. 이론적으로는 "거래비용이 작을 때 가격 인상분은 비용의 3분의 2 거듭제곱에 비례한다"는 알려진 결과가 있는데, 신경망이 계산한 값이 이 이론과 잘 맞았다(수치로 관측한 수렴 속도가 블랙숄레스에서 0.67, 헤스톤에서 0.71 — 이론값 약 0.67).
- 문제를 키워도 안 무너진다. 독립적인 헤스톤 모형 5개(총 10차원)를 합친 대형 문제에서 학습 시간이 단일 모형의 약 2.7배(2.1시간 대 5.75시간)에 그쳤고, 헤지 품질도 유지됐다. 계산 비용이 포트폴리오 크기가 아니라 헤지 수단의 수에 주로 달려 있다는 점을 보여 준다.
한계도 분명하다. 실험은 실제 시장이 아니라 합성 데이터 기반이고, 코드 공개도 확인되지 않는다(재현성 48점). 실제 거래비용 모델로 다시 검증해야 실무에 쓸 수 있다. 그래도 이 논문 이후 "딥러닝 헤징"이라는 분야가 본격적으로 열렸고, 로버스트(불확실성 견딜 수 있는) 헤징, 강화학습 헤징 등 후속 연구가 쏟아졌다.
이 테마의 공통 인사이트
이 테마의 다른 논문들도 같은 방향을 가리킨다. 최적수송(optimal transport)이라는 수학 도구로 '의존 구조를 모르는 최악의 상황'까지 계산하는 헤징(1802.08539)은, 거래비용 앞에서 '마찰 없는 전략을 그대로 따르면 얼마를 잃는지'를 상계로 잡아 준다(1802.06120). 한 문장으로: 헤지의 질은 모형이 얼마나 아름다운가가 아니라, 마찰을 어디까지 정직하게 계산에 넣는가에서 갈린다.
테마 2: 옵션 가격결정의 수학 — "밀리초 만에 답을 내는 근사"
아시안 옵션, 계산하기 까다로운 이유
옵션에는 특이한 종류가 있다. 아시안 옵션 — 기초자산 가격의 '기간 평균'에 지급이 걸린 옵션. 원자재 거래처럼 여러 달에 걸쳐 나눠 사는 실무에서 유용하다. 문제는 계산이다. 주가 평균의 분포를 공식으로 쓸 수가 없어서, 몬테카를로 시뮬레이션(수만 번 랜덤 시뮬레이션)으로 때우거나 복잡한 수치 적분을 써야 했다.
Asian Option Pricing with Orthogonal Polynomials (1802.01307)
EPFL의 Sander Willems은 이 문제에 아주 깔끔한 답을 냈다. 주가 분포에 '직교하는' 다항식들로 가격을 급수 전개하면, 모든 항을 명시적으로(적분 없이, 특수함수 없이) 계산할 수 있다는 것이다.
쉽게 말하면, "평균 가격의 분포를 다항식 여러 개의 합으로 근사"하는 건데, 기존의 비슷한 시도들과 달리 두 가지가 다르다. 첫째, 계산이 밀리초 단위로 끝난다 — 항마다 복잡한 계산이 필요 없기 때문이다. 둘째, 오차를 정직하게 밝힌다.
오차 이야기가 이 논문의 진짜 묘미다. 통계학에서 '로그정규 분포'는 모멘트(평균, 분산 등)가 분포를 완전히 결정하지 않는 특이한 성질이 있다. 그래서 이 급수가 '참 가격'에 수렴한다는 보장이 원래는 없다. 저자는 이 편향이 (변동성)² × (만기)라는 단순한 값이 클수록 커진다는 것을 밝히고, "그 값이 0.5 이하일 때 이 방법을 써라"는 실무 규칙을 제시했다.
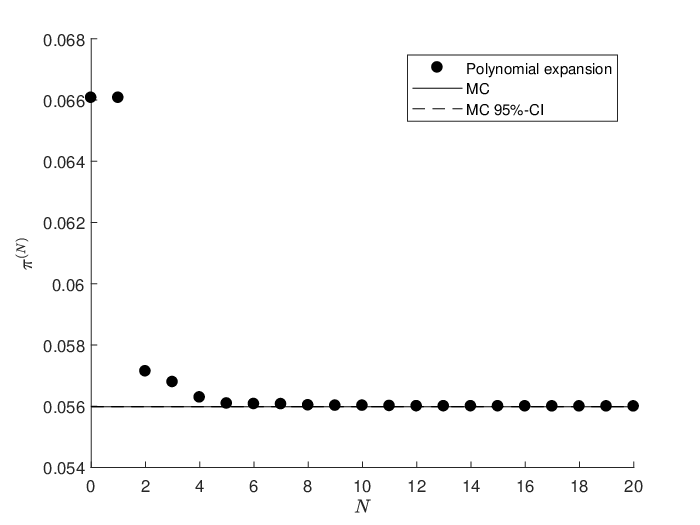
결과는 인상적이다. 문헌의 표준 테스트 케이스 7개에서, 변동성이 극단적으로 낮아 다른 방법들이 우왕좌왕인 첫 번째 케이스에서조차 20개 남짓의 항만으로 기존 최고 정밀 방법의 400개 항과 소수점 8자리까지 일치했다. 속도는 밀리초 대 수 초의 차이. 물론 한계도 있다. 변동성이 크고 만기가 길면(위에서 말한 값이 0.5를 넘으면) 편향이 눈에 띄게 커지고, 무엇보다 이건 블랙숄레스 세계 안의 이야기다.
이 테마의 공통 인사이트
이 달의 옵션 가격결정 논문들은 각자 다른 도구로 같은 문제를 공략한다. 변동성 곡선의 '웃는 모양'을 Local Variance Gamma 모형으로 순차 보정하는 방법(1802.09611), 확산을 조금 더럽게(분수 차원으로) 만들어 두꺼운 꼬리를 표현하는 급수(1802.09864), 신경망의 유연함과 Lévy 모형의 구조적 안전장치를 합친 하이브리드(1802.06520). 공통 메시지: "더 복잡한 모형"이 아니라 "계산 병목과 근사 오차를 정직하게 관리하는 방법"이 파생 가격결정의 진보다.
테마 3: 주문서의 물리학 — "큰 주문은 시장에 어떤 흔적을 남기는가"
눈에 보이지 않는 큰 손
기관 투자자는 주식을 한 번에 사지 않는다. 수십만 주를 하루에 나눠, 때로는 며칠에 걸쳐 조금씩 사고팔아야 한다(이렇게 쪼갠 큰 주문의 묶음을 메타오더라고 한다). 그러면 자연스러운 질문이 생긴다. "이 큰 주문이 시장을 얼마나 밀어 올리는가?" — 이걸 알아야 거래 비용을 예측하고, 가장 덜 밀리면서 집행하는 알고리즘을 짤 수 있다.
그런데 이 질문에 답하려면 "어떤 주문들이 한 사람의 큰 주문이었는지"를 아는 데이터가 필요한데, 이게 공개 데이터에는 없다. 그래서 오랫동안 시장가 주문 중심의 간접 연구가 대부분이었다.
Market Impact: A Systematic Study of Limit Orders (1802.08502)
프랑스 연구진(Emilio Said, Ahmed Bel Hadj Ayed, Alexandre Husson, Frédéric Abergel)은 유럽 주식시장의 자체 데이터베이스에서 2016년 1월부터 2017년 12월까지의 주문을 알고리즘으로 다시 묶어, 지정가 주문으로 집행된 메타오더만 따로 떼어 분석했다. 학술 연구로는 지정가 주문의 시장충격을 처음으로 체계적으로 다룬 작업이다.
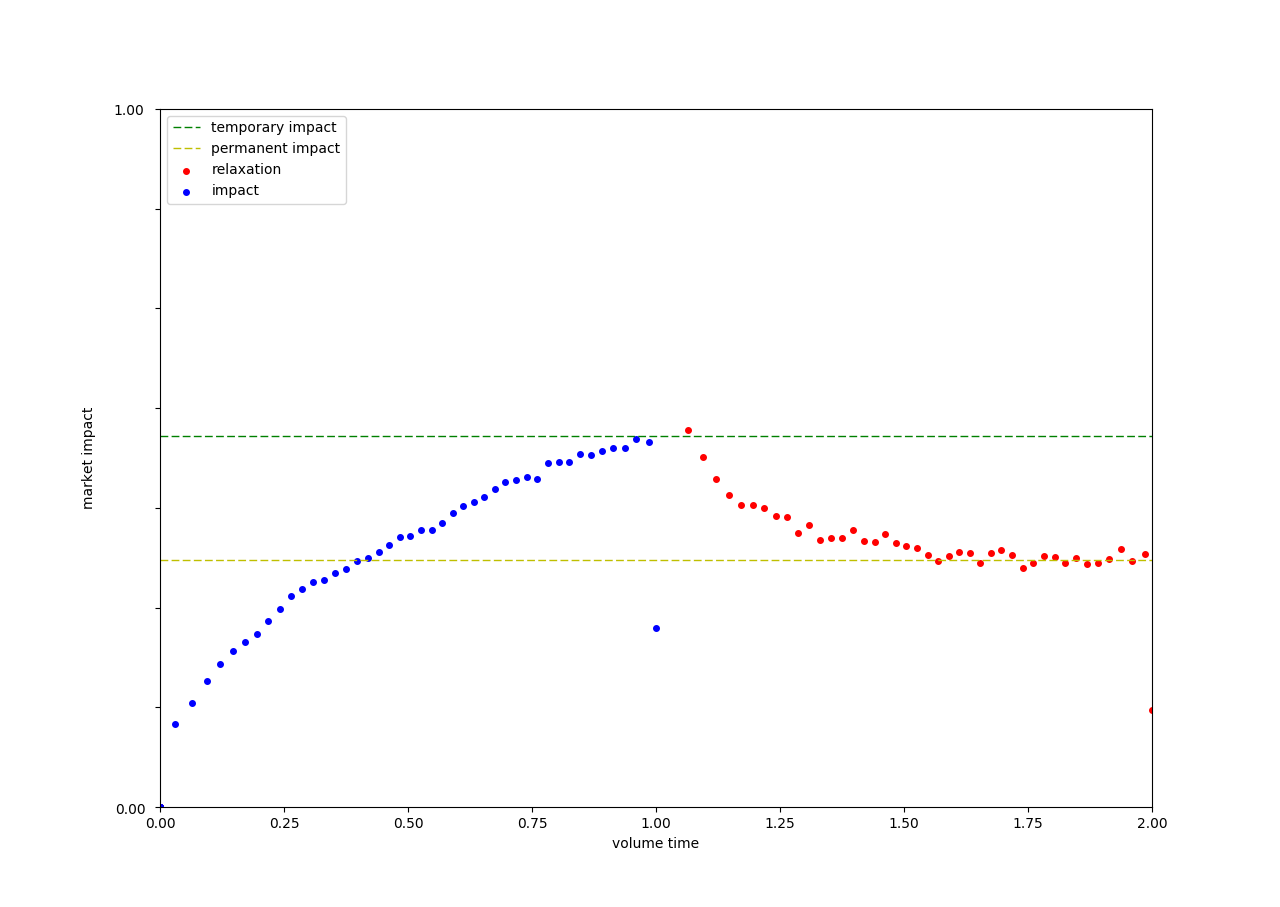
핵심 발견들을 쉽게 풀면 이렇다.
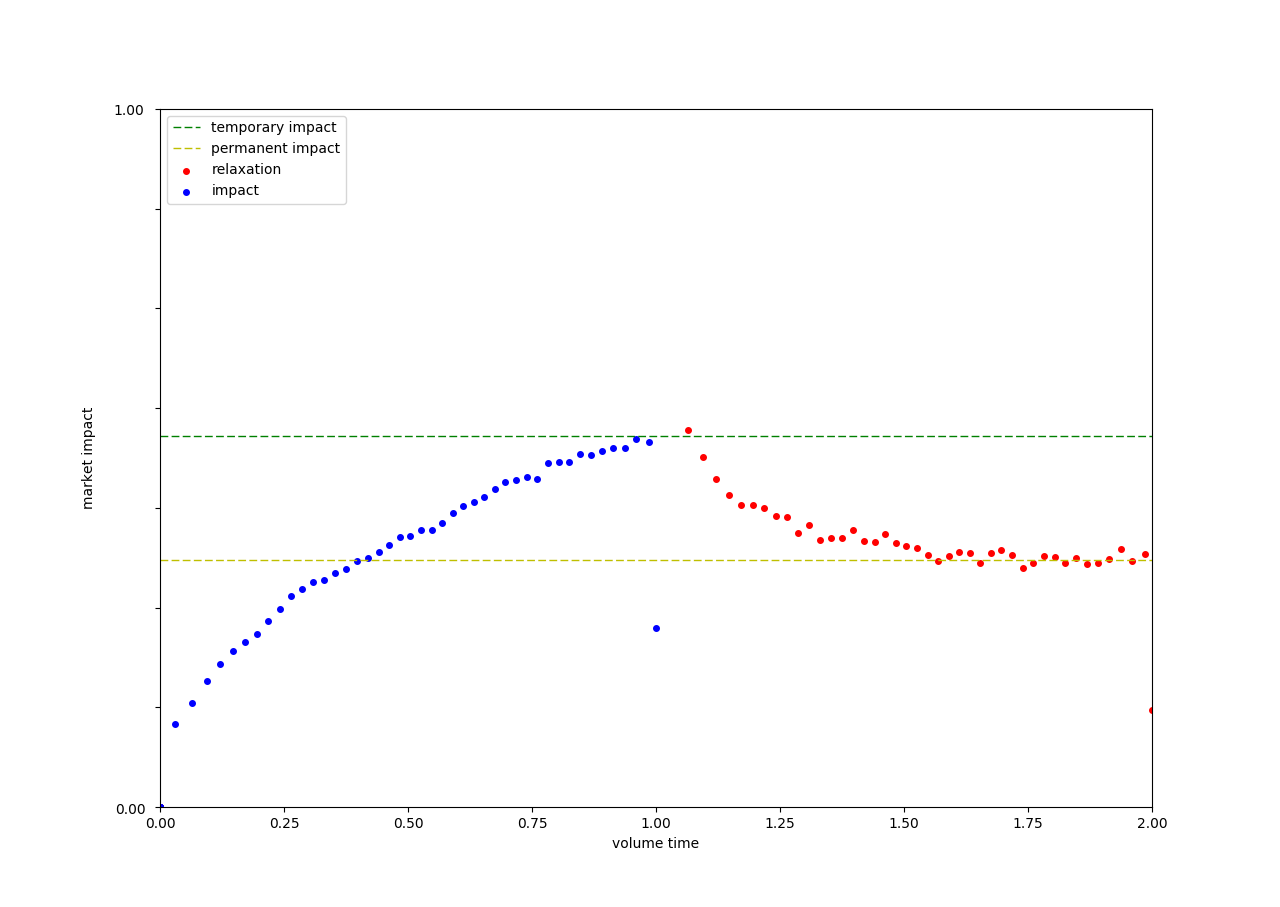
- 충격은 '오목한' 곡선을 그린다. 주문이 커질수록 가격은 밀리지만, 점점 덜 밀린다(멱법칙). 공격적으로(스프레드를 넘어) 집행한 메타오더 1,561,505건에서는 충격 곡선의 지수가 약 0.45~0.53이 나왔다. 반대로 말하면 처음에 조금만 팔아도 충격이 금방 쌓이고, 나중엔 거의 안 밀린다.
- 수동 주문을 섞으면 충격이 작다. 실제 실행 전략(수동 지정가 65% + 공격 30% + 기타 5%)으로 집행한 메타오더 74,552건은 참여율이 더 높고 오래 걸리는데도 충격이 더 작았다(지수 약 0.60~0.62, 크기별 차이도 거의 없음). 느긋하게 기다리는 주문이 시장을 덜 흔든다는, 실행 알고리즘의 기본 교훈을 150만 건 데이터가 확인해 준 셈이다.
- 충격의 3분의 2는 남는다. 집행이 끝나면 가격은 일부 되돌아오지만(이완), 최대 충격의 약 3분의 2 지점에서 멈춘다(공격적 메타오더 기준: 최대 0.53 대비 잔존 0.35). 이 '2분의 3 규칙'은 이론 모형이 예측한 값과 정확히 일치하며, 이 연구 덕분에 실증 사실로 굳었다.
- 제곱근 법칙과 공정 가격. 충격은 대략 변동성 × √(참여율)로 정리되고, 주문이 오래 걸렸는지와는 별개로 결정된다. 그리고 메타오더의 평균 체결 가격(VWAP)은 모든 일이 끝난 뒤의 가격과 대체로 맞아떨어진다 — 시장이 "이 주문의 공정한 값"을 결국 인정했다는 뜻이다.
한계: 데이터가 자체 사내 자료라 재현이 불가능하고(재현성 22점), 유럽 주식 2년으로 한정된다. 수동 주문은 체결되지 않을 수도 있어 '충격' 측정 자체에 주의가 필요하다는 점도 저자들이 솔직하게 밝힌다.
이 테마의 공통 인사이트
주문서를 직접 들여다보는 연구들은 한목소리로 말한다. 시장에 남는 흔적(멱법칙 충격, 되돌아오는 이완, 매수·매도 불균형)을 알면 체결 전략의 목표와 제약이 저절로 정해진다. 시장조성자·초단타·기관이 함께 노는 주문장 모형(1802.08135), 개장·종가 경매의 불균형 회귀(1802.01921), 큰 주문이 '시장의 기억'을 지운다는 잠재 주문장 모형(1802.06101), 주문자 정보 없이 심리를 추적하는 매수·매도 불균형 지표(1802.01143)가 모두 같은 지도의 다른 조각들이다.
테마 4: 위험의 꼬리를 계산하는 기술 — "정해진 계산 시간 안에서"
흔하지 않은 대형 사고의 확률을 계산한다는 것
리스크 관리의 핵심 질문은 "평소가 아니라, 큰일 날 때 얼마나 잃는가"다. 그런데 드문 대형 손실의 확률은 계산하기가 악명 높다. "포트폴리오의 손실이 한계를 넘을 확률" 같은 수치는 '조건부 기대값 안에 또 기대값이 들어가는' 구조 — 쉽게 말하면 시뮬레이션 안에 시뮬레이션이 또 들어가는 이중 구조라서, 정확도를 높이려면 계산량이 폭발적으로 늘어난다.
Multilevel nested simulation for efficient risk estimation (1802.05016)
옥스퍼드 대학의 Michael Giles와 Abdul-Lateef Haji-Ali는 이 계산 비용을 줄이는 기발한 방법을 냈다. 두 가지 아이디어를 겹친 것이다.
- 안쪽 시뮬레이션의 횟수를 '상황에 따라' 다르게 한다. 손실 추정치가 '한계선'에서 한참 멀면, 표본을 많이 뽑을 필요가 없다(아무리 계산해도 결론이 안 바뀌므로). 한계선 근처에 있을 때만 표본을 총동원한다. 우체국 창구가 한산할 때는 직원 한 명, 줄이 길 때만 전 직원이 투입되는 것과 비슷하다.
- 여러 정밀도의 시뮬레이션을 '차분'으로 겹친다(다중레벨 몬테카를로, MLMC). 거친 계산과 정밀한 계산의 차이만 표본으로 추정하면, 정밀 계산을 몇 번 안 해도 전체 정밀도를 얻을 수 있다.
결과적으로 RMS 오차 ε를 맞추는 데 드는 총 계산량이 기존 방법의 O(ε⁻³)~O(ε⁻⁵ᐟ²)에서 O(ε⁻²|log ε|²) 로 줄었다. 쉽게 말하면 "오차를 절반으로 줄이려면 계산을 몇 배로 늘려야 하는가"라는 지표가 크게 개선된 것이다. VaR(손실의 임계값)과 CVaR(그 임계값을 넘었을 때의 평균 손실)까지 같은 아이디어로 계산할 수 있고, CVaR은 최적인 O(ε⁻²) 복잡도를 달성했다. 수치 실험(C++ + GPU 병렬화)이 이론 복잡도를 그대로 재현했다.
한계는 실증 검증이 단순한 모형 문제에 머문다는 점, 코드 미공개(재현성 48점)다. 그래도 '리스크 계산 예산'이 정해진 실무 환경(예: 야간 리스크 배치)에서 바로 쓸 수 있는 알고리즘 설계다.
이 테마의 공통 인사이트
이 테마의 논문들은 "계산 예산과 데이터를 어떻게 쓰느냐가 리스크 추정의 정확도를 결정한다"고 말한다. 데이터가 부족하면 그럴듯한 가상의 시장을 만들어 쓰기도 한다 — 330종목 실증 데이터로 '자산 구성과 길이가 자유로운' 합성 시나리오를 생성하는 연구(1802.01861)가 그 예다. 참고로 이 글의 그림 중 이 테마의 대표 논문(1802.05016)은 추출 가능한 그림이 없어, 같은 테마의 1802.01861 그림으로 대체했다.
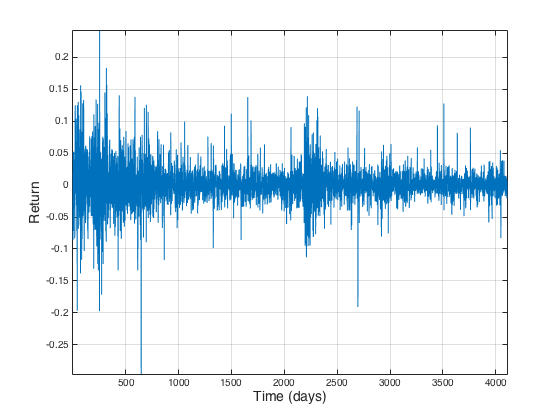
여기에 "데이터가 얼마나 있어야 두꺼운 꼬리를 신뢰할 수 있는가"를 실무 척도로 만든 연구(1802.05495), 고빈도 수익률의 변동성 군집을 마르코프 구조로 잡는 연구(1802.01540)가 합쳐진다.
테마 5: 사람과 시스템이 만드는 위험 — "언제 추세를 쫓고 언제 돌아오는가"
전략도 패션이다
투자 전략에도 유행이 있다. 시장이 쭉 오르면 "오르는 게 오른다"며 추세추종(차티스트)이 득세하고, 거품이 꺾이면 "결국 기본가치로 돌아간다"며 펀더멘털이 득세한다. 교과서는 이를 '마르코프 전환'이라는 단순 스위치로 처리하곤 했지만, 왜 어떤 투자자가 전환하고 어떤 투자자는 안 하는지는 설명하지 못했다.
Structural Estimation of Behavioral Heterogeneity (1802.03735)
홍콩중문대의 Zhentao Shi와 싱가포르국립대의 Huanhuan Zheng은 이 전환을 '심리'가 아니라 정보의 구조에서 설명했다. 모형은 이렇다. 모든 투자자는 기본가치에 대한 '노이즈 섞인 사적 신호'를 받는다. 같은 추세 전략이라도 신호가 다르면 평가가 달라지고, 각자는 자기 기준으로 기대이익이 가장 큰 전략을 고른다. 투자자들의 선택이 가격을 움직이고, 움직인 가격이 다시 다음 선택을 바꾼다 — 전략 전환이 밖에서 주어지는 게 아니라 시장 안에서 태어난다.
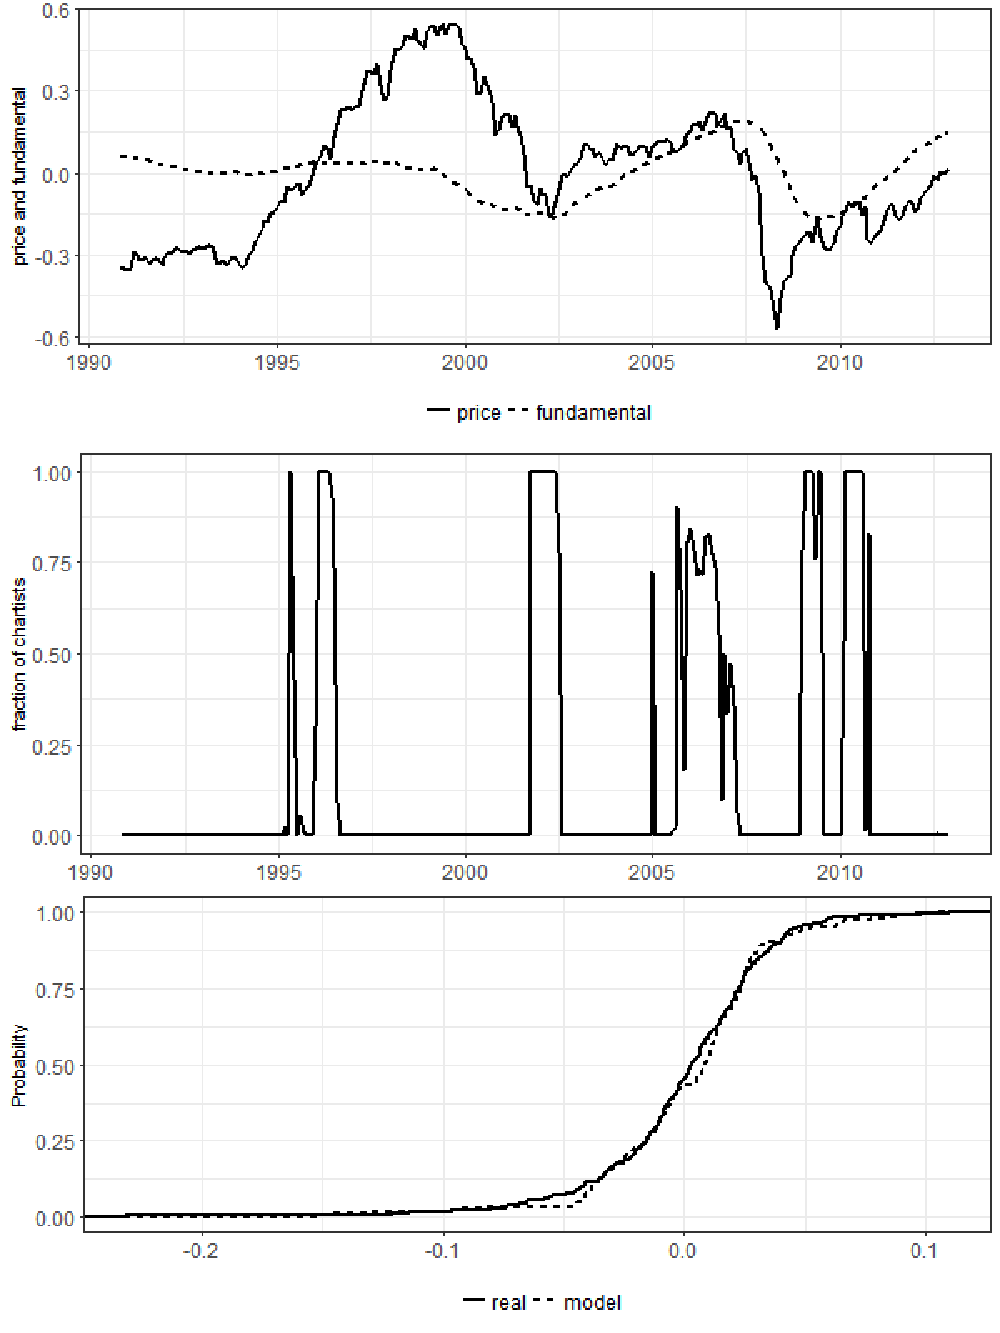
S&P 500으로 1991~2013년을 추정한 결과가 재미있다.
- 추세추종이 약 6배 민감하다. 펀더멘털 전략의 기대수익이 1% 오르면 투자 흐름은 0.10% 늘지만, 차티스트 전략의 기대수익이 1% 오르면 흐름이 0.61% 늘어난다. 추세가 있을 때 자금이 훨씬 빨리 몰린다는 뜻이다.
- 모형이 실제 수익의 '모양'을 재현한다. 실제 월 수익의 왜도(치우침) −1.38, 첨도(극단값의 두께) 9.28인데, 모형은 각각 −0.92, 6.55를 냈다. 평균과 변동성만 맞히는 게 아니라 꼬리까지 대체로 따라간다. (전략 하나만 쓰면 첨도가 2.5 수준으로 완전히 무너진다 — 전략 전환 자체가 두꺼운 꼬리를 만든다는 방증이다.)
- 2008년 금융위기의 내막이 드러난다. 2005
2007년 상승장에서 차티스트가 시장을 지배하다가, 2007년 말 추세가 꺾이자 급감하고 20082009년에는 펀더멘털리스트가 시장을 장악 — 자산이 심하게 과소평가된 국면에서 매수 압력이 가격을 기본가치 쪽으로 밀어 올린다. 다만 정보가 흐릿해서 가격은 바로 수렴하지 않고 관성이 남는다. 흥미롭게도 닷컴 버블 때는 같은 패턴이 안 나왔다 — 노이즈가 많은 환경에서 펀더멘털리스트도 잘못 읽고(과대평가된 것을 과소평가로) 버블이 더 커진 사례다.
한계: 이것은 '해석' 모형이지 투자 신호가 아니다(적용성 51점). 실제 수익률을 내는 전략으로 검증하려면 추가 작업이 필요하고, 기본가치의 측정 방식에도 의존한다.
이 테마의 공통 인사이트
이 달에는 시스템이 만드는 위험도 함께 다뤄졌다. 위기 때 모두가 한꺼번에 팔면(화재 매각) 가격이 무너지고 남은 자산도 휘청거린다 — 여기에 차입 선택까지 넣어 균형을 분석한 연구(1802.04232), 담보를 되파는(재사용) 네트워크가 어떻게 위험을 집중시키는지 본 연구(1802.02127)가 있다. 심지어 양도소득세가 "무차익"이라는 수학금융의 기본 명제 자체를 깨뜨린다는 정식화(1802.06386)도 있다. 한 문장으로: 행동의 이질성과 제도의 구조를 빼고 계산한 리스크는, 붐과 위기에서 틀린다.
2018년 2월 전체에서 읽어 내려갈 한 줄
이 달의 다섯 갈래는 사실 하나의 흐름이다. "가격을 매기는 수학"에서 "거래의 마찰·위험의 꼬리·사람의 행동까지 계산에 넣는 수학"으로의 이사. 거래비용 없는 헤지를 버리고(테마 1), 근사 오차를 솔직하게 적어 가며(테마 2), 시장에 실제 남는 흔적을 150만 건으로 재고(테마 3), 대형 손실 확률을 계산하는 비용을 줄이며(테마 4), 투자자의 전략 전환과 시스템 구조를 정량화한(테마 5) 한 달.
또 하나 눈에 띄는 것은 산업과 학문의 경계가 허물어지던 조짐이다. JP 모건이 참여한 Deep Hedging이 학술 논문으로 나왔고, 사내 데이터의 메타오더 실증이 학문의 표준 사실을 굳혔다. 8년 뒤 오늘날 딥러닝 헤징과 실행 알고리즘의 많은 부분이 이 달의 질문들 위에 서 있다. 요컨대 2018년 2월은, "현실의 불완전함을 계산이 어디까지 담을 수 있는가"를 여러 전선에서 동시에 묻기 시작한 달이었다.
더 알아보기
이 글에서 깊게 다룬 다섯 논문의 원문과 평가 점수, 그리고 이어 읽을 만한 논문들이다. 점수는 오셀랩 KB의 5차원 평가(새로움·적용성·엄밀성·재현성·통찰, 각 100점 만점)로, 참고용이다.
1. Deep Hedging (Bühler, Gonon, Teichmann & Wood, 2018)
- 원문: https://arxiv.org/abs/1802.03042
- KB 점수: 새로움 82 · 적용성 78 · 엄밀성 77 · 재현성 48 · 통찰 82 (복합 74.7, A등급)
- 이어 읽기: Deep Hedging of Derivatives Using Reinforcement Learning, Deep Hedging to Manage Tail Risk, Realistic Market Impact Modeling for Reinforcement Learning Trading Environments — 딥러닝 헤징을 강화학습·꼬리 위험·현실적 시장충격으로 넓힌 후속 연구들
2. Asian Option Pricing with Orthogonal Polynomials (Willems, 2018)
- 원문: https://arxiv.org/abs/1802.01307
- KB 점수: 새로움 68 · 적용성 62 · 엄밀성 83 · 재현성 43 · 통찰 66 (복합 66.1, A등급)
- 이어 읽기: No arbitrage SVI, Robust deep hedging, Fast and explicit European option pricing under tempered stable processes — 빠르고 일관된 옵션 가격 계산을 이어 가는 연구들
3. Market Impact: A Systematic Study of Limit Orders (Said, Bel Hadj Ayed, Husson & Abergel, 2018)
- 원문: https://arxiv.org/abs/1802.08502
- KB 점수: 새로움 68 · 적용성 78 · 엄밀성 65 · 재현성 22 · 통찰 76 (복합 61.2, B등급)
- 이어 읽기: Slow decay of impact in equity markets: insights from the ANcerno database, Crossover from linear to square-root market impact, Market Impact of Small Orders — 메타오더 시장충격 실증의 계보
4. Multilevel nested simulation for efficient risk estimation (Giles & Haji-Ali, 2018)
- 원문: https://arxiv.org/abs/1802.05016
- KB 점수: 새로움 72 · 적용성 75 · 엄밀성 83 · 재현성 48 · 통찰 72 (복합 71.9, A등급)
- 이어 읽기: Sub-sampling and other considerations for efficient risk estimation in large portfolios, Nested Multilevel Monte Carlo with Biased and Antithetic Sampling, Adaptive Multilevel Monte Carlo for Probabilities — 중첩 시뮬레이션 효율화의 후속 연구들
5. Structural Estimation of Behavioral Heterogeneity (Shi & Zheng, 2018)
- 원문: https://arxiv.org/abs/1802.03735
- KB 점수: 새로움 74 · 적용성 51 · 엄밀성 78 · 재현성 57 · 통찰 69 (복합 65.7, A등급)
- 이어 읽기: Probability Weighting Meets Heavy Tails: An Econometric Framework for Behavioral Asset Pricing — 행동 자산가격 모형을 계량적으로 다루는 최근 연구
이 글은 2018년 2월 arXiv 코호트(총 95편, 관련 45편)를 오셀랩 KB의 재평가 기준으로 정리한 월간 종합이다. 논문별 상세 평가와 그 밖의 주목 논문 23편의 요약은 백필 리포트(analysis/reports/backfill/1802.md)에 있다.
📚 이 글에서 다룬 논문 (34편)
- A
- AComputation of optimal transport and related hedging problems via penalization and neural networks
Stephan Eckstein, Michael Kupper
- AMultilevel nested simulation for efficient risk estimation
Michael B. Giles, Abdul-Lateef Haji-Ali
- ADynamics of observables in rank-based models and performance of functionally generated portfolios
Sergio A. Almada Monter, Mykhaylo Shkolnikov, Jiacheng Zhang
- AStructural Estimation of Behavioral Heterogeneity
Zhentao Shi, Huanhuan Zheng
- AGenerating virtual scenarios of multivariate financial data for quantitative trading applications
Javier Franco-Pedroso, Joaquin Gonzalez-Rodriguez, Jorge Cubero 외 3명
- BOptimal inventory management and order book modeling
Nicolas Baradel, Bruno Bouchard, David Evangelista 외 1명
- BDynamical regularities of US equities opening and closing auctions
Damien Challet, Nikita Gourianov
- BMarket Impact: A Systematic Study of Limit Orders
Emilio Said, Ahmed Bel Hadj Ayed, Alexandre Husson 외 1명
- B
- BThe Power of Trading Polarity: Evidence from China Stock Market Crash
Shan Lu, Jichang Zhao, Huiwen Wang
- BSimple Bounds for Utility Maximization with Small Transaction Costs
Bruno Bouchard, Johannes Muhle-Karbe
- B
- B
- BIndexed Markov Chains for financial data: testing for the number of states of the index process
Guglielmo D'Amico, Ada Lika, Filippo Petroni
- BOptimization of Fire Sales and Borrowing in Systemic Risk
Maxim Bichuch, Zachary Feinstein
- BCollateral Unchained: Rehypothecation networks, concentration and systemic effects
Duc Thi Luu, Mauro Napoletano, Paolo Barucca 외 1명
- ADeep Hedging of Derivatives Using Reinforcement Learning
Jay Cao, Jacky Chen, John Hull 외 1명
- ARealistic Market Impact Modeling for Reinforcement Learning Trading Environments
Lucas Riera Abbade, Anna Helena Reali Costa
- A
- A
- AFast and explicit European option pricing under tempered stable processes
Gaetano Agazzotti, Jean-Philippe Aguilar
- ASlow decay of impact in equity markets: insights from the ANcerno database
Frédéric Bucci, Michael Benzaquen, Fabrizio Lillo 외 1명
- ACrossover from linear to square-Root market impact
Frédéric Bucci, Michael Benzaquen, Fabrizio Lillo 외 1명
- ASub-sampling and other considerations for efficient risk estimation in large portfolios
Michael B. Giles, Abdul-Lateef Haji-Ali
- BNested Multilevel Monte Carlo with Biased and Antithetic Sampling
Abdul-Lateef Haji-Ali, Jonathan Spence
- BAdaptive Multilevel Monte Carlo for Probabilities
Abdul-Lateef Haji-Ali, Jonathan Spence, Aretha Teckentrup
- AProbability Weighting Meets Heavy Tails: An Econometric Framework for Behavioral Asset Pricing
Akash Deep, Svetlozar T. Rachev, Frank J. Fabozzi
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2018-05 월간A
2018년 5월 금융 AI 논문: 분포강건 포트폴리오, 온라인 매매, 마켓메이커 수수료
2018년 5월 금융 연구 5개 테마 정리. 자산이 표본보다 많아도 안 흔들리는 공분산 추정, 27년 만에 나온 온라인 포트폴리오 새 알고리즘, 잡음 섞인 틱 데이터에서 변동성 읽기, 거래소 수수료와 마켓메이커의 계약, 아시안 옵션을 수십 배 빠르게 매기는 법.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.