"예측을 더 잘하기 전에, 우리가 쓰는 계산이 언제 깨지는지부터 확인하자." 2018년 5월에 나온 금융 연구들은 대체로 이런 자세였다. 이 달의 상위 논문들을 한 문장으로 요약하면 이렇다 — 자산이 표본보다 많은데도 안 흔들리는 위험 추정법, 27년 동안 유일했던 온라인 투자 알고리즘을 대체한 새 방법, 시장의 '소음'을 빼고 진짜 변동성을 읽는 법, 거래소가 마켓메이커에게 줄 보너스를 계산하는 법, 그리고 평균가 옵션을 수십 배 빠르게 매기는 법. 화려한 예측 대신 "무너지지 않는 계산"에 몰두한 한 달의 기록을 다섯 갈래로 풀어 본다.
들어가며: "더 잘 맞추기"보다 "안 깨지게 만들기"
2018년 5월의 시장은 어수선했다. 비트코인은 연초 고점의 3분의 1 수준으로 떨어진 뒤였고, 이탈리아 정치 불안이 채권 시장을 흔들고 있었다. 그런데 그 달의 금융 연구 흐름은 의외로 차분하다. "이번 달 대박 종목"을 예측하는 논문 대신, 이런 질문들이 상위권을 채웠다.
- 주식 100개의 위험을 계산하려면 표본이 100개보다 많은데, 표본이 적을 때 계산이 폭발하는 문제를 어떻게 없앨 수 있는가?
- 매일 갈아 타야 하는 투자에서, 어제의 데이터에 너무 흔들리지 않으면서도 최적에 가까워지는 법은 무엇인가?
- 초당 수천 번 찍히는 가격에는 시장의 '마찰음'이 섞여 있다. 그 소음을 빼면 진짜 변동성은 어떻게 보이는가?
- 거래소가 마켓메이커에게 돌려주는 수수료, 정말 얼마가 최적인가?
한마디로 "계산이 견디는 조건"을 점검하는 연구들이다. 비유하자면 자동차 경주 팀이 "엔진을 더 세게"가 아니라 "이 속도에서 차체가 부서지지 않는지"를 먼저 시험하는 여름 같았다. 이 글은 2018년 5월의 연구를 다섯 개 테마로 묶어, 논문을 안 읽은 분도 따라올 수 있게 풀어 본다.
테마 1. 포트폴리오 최적화 — "표본이 적어도 안 흔들리는" 위험 계산
비유부터: 레시피의 재료가 부족할 때
좋은 포트폴리오를 짤 때 꼭 필요한 재료가 '자산들 사이의 공분산', 쉽게 말해 "이 두 자산이 함께 움직이는 정도"다. 그런데 자산 100개의 공분산을 구하려면 최소한 몇 년치 데이터가 필요한데, 실제로는 자산 수보다 표본이 적은 경우가 허다하다. 이때 계산은 "재료가 부족한데 레시피대로 하라"는 꼴이 되고, 결과는 엉뚱하게 흔들린다. 수학적으로는 '공분산의 역행렬'이 폭발적으로 불안정해진다.
대표 논문 깊게 보기: 워서스타인 수축 추정기 (1805.07194)
이 논문은 이 "재료 부족" 문제에 대해, 지금까지와는 조금 다른 태도로 접근한다. EPFL과 TU Delft의 연구팀(Viet Anh Nguyen, Daniel Kuhn, Peyman Mohajerin Esfahani)이 쓴 이 논문의 핵심 아이디어는 이렇게 요약할 수 있다.
- "내 데이터가 암시하는 분포가 조금 달랐다면?"을 전부 따져 본다. 관측한 데이터에서 정해지는 분포에서, 약간 떨어진(그 거리를 워서스타인 거리로 측정) 모든 정규분포를 후보로 둔다.
- 그중에서 '가장 나쁜 경우의 오차'를 최소화하는 추정을 고른다. 오차 측도로는 정밀도 행렬 추정에서 표준인 스타인 손실(Stein's loss)을 쓴다. 쉽게 말하면 "데이터가 살짝 달라져도 크게 후회하지 않는 계산"을 고르는 것이다.
- 놀라운 점은, 이렇게 '최악의 경우'를 방어하도록 설계하면 바람직한 성질이 저절로 따라온다는 것이다. 자산 수가 표본 수보다 많아도 추정이 정의되고(가역적이고), 어떤 순서로 자산을 배치해도 결과가 회전에 대해 일관되며, 표본 고윳값의 순서까지 보존한다. 억지로 조건을 붙인 게 아니라 계산 원리에서 도출된 결과다.
성과는 실제 데이터로 확인됐다. 미국 팩터 데이터 라이브러리의 두 데이터셋(업종 포트폴리오 48개, 시가총액·장부가치비율 100개)으로 19962016년 월간 수익률을 쓰고, 19962005년을 학습, 2006~2016년을 표본 외로 평가했다. 최소분산 포트폴리오 기준 결과는 다음과 같다.
| 추정 방법 | 샤프 비율 (48종목) | 샤프 비율 (100종목) |
|---|---|---|
| 워서스타인 수축 | 0.223 | 0.307 |
| 선형 수축 | 0.218 | 0.277 |
| l1 정규화 우도 추정 | 0.217 | 0.295 |
흥미로운 점은, 표준편차(위험)만 보면 l1 정규화 방법이 조금 낫지만, 위험 대비 수익의 질을 나타내는 샤프 비율은 워서스타인 수축이 두 데이터셋 모두에서 가장 높았다는 것이다. 논문 저자들도 "maybe surprisingly"라고 적을 만큼, 위험 계산을 안정시키는 일이 수익의 질까지 끌어올린 결과다.
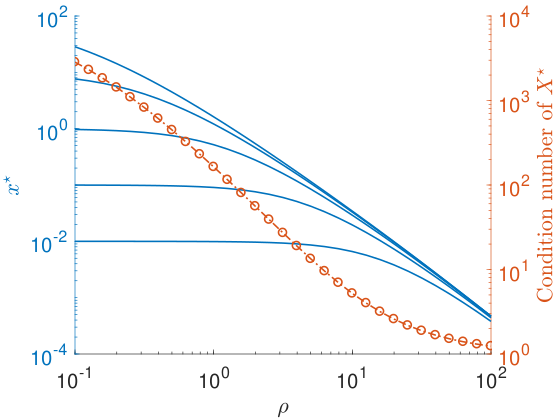
물론 한계도 분명하다. 공개 코드가 없어(재현성 점수 43) 직접 구현해야 하고, '얼마나 멀리 떨어진 분포까지 방어할지'를 정하는 반경 파라미터는 여전히 사람이 골라야 한다. 그래도 이 논문이 남긴 교훈 — "추정 오차를 방어하는 설계가 실전 성과로 이어진다" — 는 이후 분포강건 포트폴리오 연구의 출발점이 되었다.
가볍게: 함께 볼 논문들
- 1805.09068 — 보험사의 규제(VaR) 제약 아래 최적 투자를 명시적으로 푼 논문. "규제가 답답한 제약"이 아니라 "계약자를 보호할 수 있는 장치"로 작동할 수 있음을 보여 준다.
- 1805.05584 — 옵션 시장의 가격에서 미래 수익률 분포의 '비대칭과 꼬리'를 미리 읽어 와 포트폴리오에 반영. "내다보는" 포트폴리오 구성이라 할 만하다.
이 테마의 공통 인사이트
이 논문들은 한목소리로 말한다. 포트폴리오의 진짜 적은 시장이 아니라 '추정 오차'다. 수익률을 조금 더 잘 맞추려 애쓰기보다, 추정이 틀려도 무너지지 않는 계산을 만드는 편이 실전에서 유리하다.
테마 2. 온라인 포트폴리오와 강화학습 — "매일 다시 짜는" 투자의 이론
비유: 매일 갈아 타는 택시 요금 문제
온라인 포트폴리오는 "매일 자산 비중을 다시 배분하고, 시장이 움직인 뒤 채점받는" 게임이다. 좋은 알고리즘의 기준은 regret — '사후에 알게 된 최적의 고정 비중 배분' 대비 내가 잃은 만큼 — 이다. 이 regret을 가장 작게 만든 방법은 1991년 커버(Cover)의 '범용 포트폴리오'인데, 문제는 계산이 엄청나게 비싸다는 것. 27년 동안 "똑같이 좋으면서 빠른 방법"이 없었다.
대표 논문 깊게 보기: 로그 regret의 효율적 온라인 포트폴리오 (1805.07430)
USC와 베이징대 연구팀(Haipeng Luo, Chen-Yu Wei, Kai Zheng)은 이 오래된 문제에 처음으로 대안을 냈다.
- '로그 장벽'이라는 안전장치를 업데이트 규칙에 심는다. 어떤 자산의 비중이 0에 가까워지면 '벌점'이 무한히 커지는 장치다. 덕분에 한 번 소외된 자산도 나중에 다시 살아날 수 있다. 마치 투자 팀에서 "지금은 안 사지만 명단에서 아예 빼지는 않는" 규칙과 같다.
- 이렇게 하면 regret이 O(N²(ln T)⁴) — 완벽하게 최적인 O(N ln T)보다는 크지만 여전히 로그 수준 — 이 보장되고, 계산은 라운드당 다항식 시간에 끝난다.
- 게다가 가격 변동에 대한 별도의 하한 가정이 필요 없다. 기존 방법들은 "가장 작은 가격 비율의 역수" 같은, 시장이 움직이면 사실상 무한대가 될 수 있는 항에 의존했는데, 이 알고리즘은 그러한 항 없이 보장이 성립한다.
논문의 결론도 솔직하다. regret의 N²를 N으로 줄일 수 있을지, 계산을 더 빠르게 할 수 있을지가 열린 문제로 남고, "라운드당 O(N) 계산으로는 최적 regret이 불가능할 것"이라는 비관적 추측까지 함께 제시한다. 한계 — 실거래 데이터 실험이 없고, 거래비용·시장충격이 없는 순수 이론이라는 점 — 도 분명하다.
가볍게: 함께 볼 논문들
- 1805.00205 — 추정 오차가 전략 수익에 '나비효과'로 증폭되는 문제를 강화학습과 견고 최적화로 다룬다.
- 1805.07478 — 헤스턴 변동성 모형으로 가짜 시장 데이터를 만들어 Q-러닝을 훈련시키는 시도. "시뮬레이션에서 배운 트레이딩이 진짜에서 통하는가"라는 이후 수년간의 화두를 미리 던진다.
- 1805.11074 — 보상 함수가 조금만 틀리면 AI가 엉뚱한 것을 최적화한다는 '보상 남용' 문제를 다룬 범용 강화학습 연구.
이 테마의 공통 인사이트
온라인 투자의 성과는 예측력보다 '업데이트 규칙'이 결정한다. 데이터에 과잉 반응하지 않으면서(규제) 소외된 선택지를 남겨 두는(장벽) 균형 — 그리고 보상 설계가 어긋나면 아무리 좋은 학습 알고리즘도 엉뚱한 답을 낸다는 경고.
테마 3. 시장 미시구조 — 소음 섞인 가격에서 진짜 변동성 읽기
비유: 시끄러운 카페에서 속삭임 듣기
초 단위로 찍히는 가격에는 '마찰음'이 섞여 있다. 호가 스프레드, 체결 시점의 어긋남 같은 미시구조 잡음이다. 이 잡음을 그냥 두면 변동성이 부풀려지고, 무작정 제거하면 진짜 변동성의 시간 구조까지 사라진다. 시끄러운 카페에서 상대의 속삭임을 들으려면 "소음을 줄이는 마이크"가 아니라 "어디에 소음이 있는지 아는 마이크"가 필요하다.
대표 논문 깊게 보기: 미시구조 잡음 아래의 비모수 베이지안 변동성 학습 (1805.05606)
네덜란드 라이덴대·TU Delft·암스테르담대 연구팀(Shota Gugushvili 외 4인)의 이 논문은 변동성을 '점'이 아니라 '분포'로 추정한다.
- 변동성을 뻣뻣하게 정하지 않는다. 파라미터 몇 개로 된 변동성 모형을 가정하는 대신, 변동성 함수를 '조각별 상수'로 두고 데이터가 모양을 결정하게 한다(비모수 베이지안 접근).
- 숨은 진짜 가격과 관측된 가격을 분리한다. 관측치를 '숨은 진짜 가격 + 측정 오차'의 상태공간 모형으로 재정의하면, 잡음이 모형 안에서 공식적으로 다뤄진다.
- 불확실성까지 함께 돌려준다. 점 추정만 주는 게 아니라 95% 신용구간 — "변동성이 이 구간 안에 있을 확률이 95%" — 을 계산해 준다.
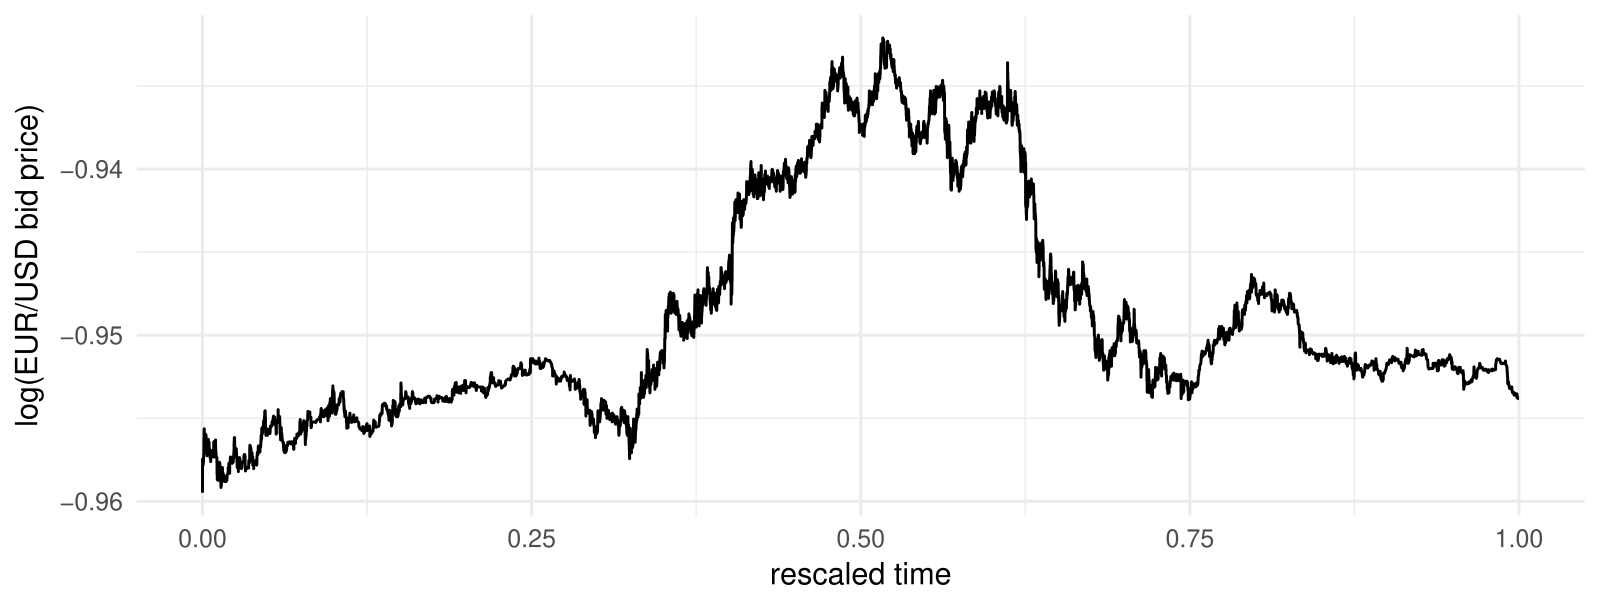
실제 검증은 브로커 Pepperstone의 EUR/USD 틱 데이터(2015년 3월 2일 하루치, 10개 중 1개만 골라 13,025개 관측)로 이뤄졌다. 결과는 직관적이다 — 변동성은 밤 시간대에 낮고, 이른 아침과 늦은 오후에 두 개의 봉우리가 있다. 계산 시간은 약 33분. 데이터를 절반만 쓰는 실험에서는 추정 평균은 거의 그대로이고 구간만 넓어졌는데, 이는 "자료가 줄면 불확실성이 정직하게 커진다"는 모형의 건강한 신호다.
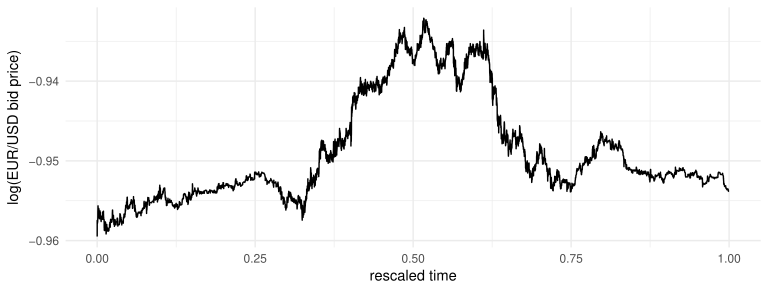
한계도 명확하다. 이 연구는 가격의 점프(갑작스러운 도약)를 의도적으로 다루지 않았고, 저자들은 "큰 점프나 뭉친 작은 점프에 대한 견고성은 주장하지 않는다"고 분명히 밝힌다. 하루 데이터를 이용한 시연이라 일반화에는 추가 검증이 필요하다.
가볍게: 함께 볼 논문들
- 1805.06682 — 주문장의 모든 흐름이 공유하는 '전체 시장 활동'이라는 기저선을 제거한 뒤, 남는 상대 강도로 "다음 주문이 매수일 확률"을 추정한다.
- 1805.07134 — "차익 기회가 없다"는 조건과 군집적 주문 흐름을 가정하면, 시장충격이 멱법칙(극단이 잘 나타나는) 형태를 띠고 변동성이 거칠어야 함이 함께 도출된다는 놀라운 이론.
이 테마의 공통 인사이트
관측된 가격은 진짜 가치에 시장의 마찰음이 더해진 신호다. 잡음은 없애야 할 오류가 아니라 모형의 일부로 다뤄야 할 정보다 — 그렇게 할 때 비로소 "얼마나 불확실한지"까지 함께 얻을 수 있다.
테마 4. 시장 설계와 시스템 리스크 — 수수료는 곧 시장의 설계도
비유: 쇼핑몰의 임대료 정책
거래소는 쇼핑몰, 마켓메이커는 매대를 지키는 상인이라 생각하면 쉽다. 상인이 물건을 내놓고(호가) 손님이 오게 하려면 쇼핑몰이 임대료 정책(수수료)을 잘 짜야 한다. 지정가 주문에 보너스를 주고 시장가 주문에 비용을 매기는 '메이커-테이커 수수료'가 바로 그것인데, 정확히 얼마를 돌려줘야 상인이 호가를 좁히고 손님의 비용이 줄어드는가에 대한 계산 이론이 없었다.
대표 논문 깊게 보기: 마켓메이커 규제를 위한 최적 메이커-테이커 수수료 (1805.02741)
에콜 폴리테크니크 연구팀(Omar El Euch, Thibaut Mastrolia, Mathieu Rosenbaum, Nizar Touzi)은 이 문제를 '주인-대리인 계약'으로 풀었다. 거래소가 주인, 마켓메이커가 대리인이다.
- 마켓메이커의 속마음부터 계산한다. 재고 위험을 싫어하고 효용을 극대화하려는 마켓메이커가, 어떤 보상 체계 아래서 어떤 호가를 내놓을지를 먼저 유도한다.
- 그 위에서 거래소가 제시할 수 있는 최적 계약을 '준명시적' 형태로 구한다. 이 계약의 핵심은 고정 보너스가 아니라, 마켓메이커의 재고 궤적과 자산의 변동성에 연동된 보상이다.
- 시뮬레이션(시나리오 5,000경로)으로 효과를 확인했다. 인센티브 계약은 거래 기간 내내 스프레드를 줄이고, 스프레드가 좁아지면 시장가 주문이 더 자주 오므로 시장 유동성이 올라간다. 재고가 크게 쌓이면 마켓메이커는 심지어 효율 가격보다 낮게 매도 호가를 걸어 재고를 털려 한다 — 계약이 이 비대칭을 부드럽게 만든다.
정리하면, 마켓메이커의 손익은 거의 그대로 유지된 채(효용이 같은 수준으로 보정) 투자자의 거래비용만 유의하게 줄어든다. 수수료 정책이 '시장의 설계도'라는 사실을 수치로 보여 준 셈이다.
한계로는 단일 마켓메이커·단일 투자자라는 단순화, 공개 코드 부재(재현성 38), 깊은 수학적 준비가 필요한 유도 과정이 있다. 2019년 7월에 나온 논문(1907.11053)은 이 주제를 복수 마켓메이커 환경으로 확장한다.
가볍게: 함께 볼 논문들
- 1805.08454 — 많은 펀드가 비슷한 포트폴리오를 들고 있으면(크라우딩) 플래시 크래시가 전염된다는 미시-거시 하이브리드 모형.
- 1805.08544 — 금융 네트워크에서 파생·보험의 '조건부 지급'이 부도 전염과 시스템 리스크를 어떻게 바꾸는지 분석.
이 테마의 공통 인사이트
유동성은 저절로 생기지 않는다. 수수료, 재고, 계약 구조라는 설계 변수가 유동성의 양과 질을 결정하고, 좋은 설계는 중간상(마켓메이커)을 거쳐 최종 투자자의 비용 절감으로 전달된다.
테마 5. 파생상품 가격결정 — 정확하게, 그리고 수십 배 빠르게
비유: 맛을 보지 않고 국물 맛 예측하기
아시안 옵션은 일정 기간 주가의 평균에 보수가 달린 상품이다. 매일의 가격을 전부 확인해야 평균을 알 수 있으니, 몬테카를로 시뮬레이션 한 번마다 'm일치 경로'를 전부 계산해야 한다. m이 수백~수천이면 계산비가 눈덩이처럼 불어난다. "국물 맛을 매번 한 모금씩 다 보지 않고도, 대표 몇 번만 맛보고 정확히 예측하는 법"이 필요한 셈이다.
대표 논문 깊게 보기: 이산 모니터링 아시안 옵션의 일반적 다단계 몬테카를로 (1805.09427)
ESCP Europe의 Nabil Kahalé가 쓴 이 논문은 '다단계 몬테카를로(MLMC)'라는 기법을 아시안 옵션에 맞게 정리했다.
- 거칠게 본 계산과 정밀하게 본 계산의 '차이'만 모은다. 대부분의 시뮬레이션을 대충(적은 비용으로) 돌리고, 정밀 계산은 차이를 보정하는 데만 쓴다. 그 결과 표준편차가 원하는 오차 ε에 도달하는 비용이 O(m + ε⁻²) — 모니터링 날짜 m에 비례하던 항이 사실상 사라진다.
- 블랙-숄즈, CEV, 머튼 점프확산, 지수 레비 과정, 스칼라 미분방정식까지 폭넓은 모형에서 성립하도록 일반화했다. 추정량은 '무편향'이라 계산 결과가 어림값이 아니라 공정한 추정치다.
- 수치 실험(블랙-숄즈, 주가 50, 변동성 30%, 금리 5%, 만기 4년)에서 효율 개선을 확인했다. 동일 계산 시간 대비 전통 몬테카를로의 효율 비율(분산감축계수)은 다음과 같다.
| 행사가 \ 모니터링 날짜 | 125일 | 250일 | 500일 | 1000일 |
|---|---|---|---|---|
| 40 | 17배 | 35배 | 65배 | 138배 |
| 50 | 12배 | 24배 | 49배 | 98배 |
| 60 | 9배 | 18배 | 38배 | 75배 |
모니터링 날짜가 많을수록 이득이 커진다. m = 1000이면 138배 — "전통 몬테카를로를 m의 차수만큼 능가한다"는 이론 예측이 그대로 숫자로 확인된다.
한계로는 선물과 현물의 선형 관계 가정, 실험이 블랙-숄즈 기준의 '예비' 수준이라는 점이 있다. 그래도 구현이 단순하고 무편향 추정량이라 실무 이식이 쉬운 편이다.
가볍게: 함께 볼 논문들
- 1805.03172 — '블랙-숄즈 모형들의 합'이라는 관점으로 바스켓·스프레드·아시안 옵션을 한 번에 계산하는 방법.
- 1805.04704 — 헤스턴 변동성 모형의 파라미터를 조각별 상수로 두어 시장 데이터에 빠르게 보정한다.
- 1805.12587 — '거친 변동성(rough volatility)' 모형에서 생기는 까다로운 방정식을 빠르게 푸는 수치 기법("Rough is not so Tough").
- 1805.03980 — 2007~2017년 고빈도 자료로 유가와 외환 시장이 얼마나 붙어 움직이는지를 기간별로 분해. 유가를 포트폴리오에 넣으면 전체 연결성이 낮아진다는 흥미로운 결과.
이 테마의 공통 인사이트
모형이 정교해지는 방향과 계산이 가벼워지는 방향은 동시에 갈 수 있다. 파생상품 가격결정의 진화는 "더 복잡한 모형"이 아니라 "같은 정확도를 훨씬 싸게"라는 목표를 향해 움직이고 있다.
월 전체 정리: "불확실성을 지우지 말고, 모형 안으로 들이자"
2018년 5월의 다섯 테마를 관통하는 메시지는 하나다 — 불확실성을 없애려 하지 말고, 계산 안으로 정식으로 들이라는 것. 공분산 추정에서는 '데이터가 달라졌을 때'를 방어하는 워서스타인 집합이 수축의 원리가 되었고(테마 1), 온라인 투자에서는 '과거 데이터에 과잉 반응하지 않는' 장벽이 업데이트 규칙이 되었으며(테마 2), 고빈도 데이터에서는 시장의 소음이 상태공간 모형의 한 부분이 되었고(테마 3), 거래소 수수료에서는 재고와 변동성에 연동된 계약이 유동성의 설계 변수가 되었으며(테마 4), 옵션 가격결정에서는 계산 오차 자체를 통제 대상으로 삼았다(테마 5).
또 하나 눈에 띄는 점은, 이 달의 이론 논문들이 실증 표를 거의 다 붙이고 있다는 것이다. 최소분산 포트폴리오의 샤프 비율, 하루치 EUR/USD 틱 데이터의 변동성 곡선, 5,000경로 시뮬레이션의 스프레드 변화, 138배라는 계산 효율 — 전부 '증명 끝'이 아니라 '표본 외 확인'에서 멈춘다. 기계학습이 금융의 주류 도구가 되기 직전, 도구를 쓰기 전에 도구가 견디는 조건을 정리하던 시기의 기록. 2026년의 눈으로 다시 보아도, 오늘날 분포강건 포트폴리오·RL 트레이딩·시장 설계 연구의 씨앗이 이미 이 달에 심겨 있음을 알 수 있다.
더 알아보기
이 글에서 깊게 다룬 논문들의 원문 링크와 점수(KB 5차원 평가, 참고용)다.
테마 1 — 워서스타인 수축 추정
- 1805.07194 Distributionally Robust Inverse Covariance Estimation — 새로움 73 · 적용성 76 · 엄밀성 86 · 재현성 43 · 통찰 72
- 관련 논문: Distributionally Robust End-to-End Portfolio Construction (2206.05134), Non-linear shrinkage of the price return covariance matrix (2112.07521)
테마 2 — 온라인 포트폴리오
- 1805.07430 Efficient Online Portfolio with Logarithmic Regret — 새로움 78 · 적용성 67 · 엄밀성 86 · 재현성 42 · 통찰 74
- 관련 논문: An Introduction To Regret Minimization In Algorithmic Trading: A Survey (2105.13126)
테마 3 — 미시구조 잡음과 변동성
- 1805.05606 Nonparametric Bayesian volatility learning under microstructure noise — 새로움 68 · 적용성 62 · 엄밀성 72 · 재현성 78 · 통찰 64
- 관련 논문: Marked Hawkes process modeling of price dynamics and volatility estimation (1907.12025)
테마 4 — 마켓메이커 수수료 설계
- 1805.02741 Optimal make-take fees for market making regulation — 새로움 78 · 적용성 72 · 엄밀성 81 · 재현성 38 · 통찰 76
- 관련 논문: Optimal make take fees in a multi market maker environment (1907.11053), Optimal Market Making by Reinforcement Learning (2104.04036)
테마 5 — 파생상품 가격결정
- 1805.09427 General multilevel Monte Carlo methods for pricing discretely monitored Asian options — 새로움 72 · 적용성 62 · 엄밀성 84 · 재현성 56 · 통찰 66
- 관련 논문: Nested Multilevel Monte Carlo with Biased and Antithetic Sampling (2308.07835), Stochastic Expansion for the Pricing of Asian and Basket Options (2402.17684)
📚 이 글에서 다룬 논문 (38편)
- ADistributionally Robust Inverse Covariance Estimation: The Wasserstein Shrinkage Estimator
Viet Anh Nguyen, Daniel Kuhn, Peyman Mohajerin Esfahani
- AEfficient Online Portfolio with Logarithmic Regret
Haipeng Luo, Chen-Yu Wei, Kai Zheng
- ANonparametric Bayesian volatility learning under microstructure noise
Shota Gugushvili, Frank van der Meulen, Moritz Schauer 외 1명
- AOptimal make-take fees for market making regulation
Omar El Euch, Thibaut Mastrolia, Mathieu Rosenbaum 외 1명
- AAnalyzing order flows in limit order books with ratios of Cox-type intensities
Ioane Muni Toke, Nakahiro Yoshida
- BTotal, asymmetric and frequency connectedness between oil and forex markets
Jozef Baruník, Evžen Kočenda
- BNo-arbitrage implies power-law market impact and rough volatility
Paul Jusselin, Mathieu Rosenbaum
- BForward-looking portfolio selection with multivariate non-Gaussian models and the Esscher transform
Michele Leonardo Bianchi, Gian Luca Tassinari
- BUnderstanding Flash Crash Contagion and Systemic Risk: A Micro-Macro Agent-Based Approach
James Paulin, Anisoara Calinescu, Michael Wooldridge
- BIntroducing shrinkage in heavy-tailed state space models to predict equity excess returns
Florian Huber, Gregor Kastner, Michael Pfarrhofer
- BMultiple curve Lévy forward price model allowing for negative interest rates
Ernst Eberlein, Christoph Gerhart, Zorana Grbac
- BUtility maximization with proportional transaction costs under model uncertainty
Shuoqing Deng, Xiaolu Tan, Xiang Yu
- BPortfolio Optimization with Delay Factor Models
Shuenn-Jyi Sheu, Li-Hsien Sun, Zheng Zhang
- BAggregating multiple types of complex data in stock market prediction: A model-independent framework
Huiwen Wang, Shan Lu, Jichang Zhao
- BImpact of Contingent Payments on Systemic Risk in Financial Networks
Tathagata Banerjee, Zachary Feinstein
- BConstruction of Forward Performance Processes in Stochastic Factor Models and an Extension of Widder's Theorem
Levon Avanesyan, Mykhaylo Shkolnikov, Ronnie Sircar
- BRobust Log-Optimal Strategy with Reinforcement Learning
Yifeng Guo, Xingyu Fu, Yuyan Shi 외 1명
- BAnticipating cryptocurrency prices using machine learning
Laura Alessandretti, Abeer ElBahrawy, Luca Maria Aiello 외 1명
- BReward Constrained Policy Optimization
Chen Tessler, Daniel J. Mankowitz, Shie Mannor
- BUtilizing Device-level Demand Forecasting for Flexibility Markets - Full Version
Bijay Neupane, Torben Bach Pedersen, Bo Thiesson
- BFast Hybrid Schemes for Fractional Riccati Equations (Rough is not so Tough)
Callegaro Giorgia, Grasselli Martino, Pagès Gilles
- BOptimal make take fees in a multi market maker environment
Bastien Baldacci, Dylan Possamaï, Mathieu Rosenbaum
- ADistributionally Robust End-to-End Portfolio Construction
Giorgio Costa, Garud N. Iyengar
- ANon-linear shrinkage of the price return covariance matrix is far from optimal for portfolio optimisation
Christian Bongiorno, Damien Challet
- BMarked Hawkes process modeling of price dynamics and volatility estimation
Kyungsub Lee, Byoung Ki Seo
- BOptimal Market Making by Reinforcement Learning
Matias Selser, Javier Kreiner, Manuel Maurette
- BNested Multilevel Monte Carlo with Biased and Antithetic Sampling
Abdul-Lateef Haji-Ali, Jonathan Spence
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2023-05 월간
연준의 말이 시장을 움직일 때 — 2023년 5월 AI 금융 연구 리뷰
2023년 5월 arXiv에 올라온 금융 AI 연구를 테마별로 정리합니다. FOMC 연설의 매파/비둘기파 톤을 자동 분류하는 데이터셋부터, 자산 간 가격 충격의 비밀, 포트폴리오 이론의 새로운 수학까지.
 📊 2022-02 월간
2022년 2월 AI 퀀트 리서치 요약 — 포트폴리오, 꼬리 위험, 옵션, 그리고 가상 시장
2022년 2월에 발표된 AI·퀀트 금융 논문들을 일반 독자 눈높이로 풀어쓴 월간 리서치 리뷰. 포트폴리오 최적화, 온라인 학습, 꼬리 위험, 옵션 가격결정, 시장 시뮬레이션 등 다섯 가지 주제를 다룬다.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.