"예측 신호를 더 모으기 전에, 있는 신호를 '어떻게 묶을지'부터 다시 생각하자." 2018년 3월에 나온 금융 연구들을 한 문장으로 요약하면 이렇다 — 백 개에 가까운 예측 변수를 버리지 않고 동적으로 합성하는 예측 회귀, 몬테카를로의 장점과 편미분방정식의 장점을 섞어 옵션 행사 시점을 정확히 잡는 알고리즘, 1초 단위 데이터의 잡음과 어긋난 체결을 지우지 않고 그대로 모형에 넣은 상관 추정, "내 계산이 틀릴 수도 있다"를 전제로 한 포트폴리오 이론, 그리고 종목을 아무리 늘려도 줄지 않는 신용 포트폴리오의 위험을 수학으로 보여 준 연구. 화려한 '대박 예측' 대신 "계산이 현실의 불완전함을 얼마나 담는가"를 묻는 한 달의 기록을 다섯 갈래로 풀어 본다.
들어가며: 다 맞히는 예측보다, 안 틀리는 계산
2018년 3월의 시장은 소란스러웠다. 2017년 말 폭등했던 비트코인은 거품이 꺼진 뒤였고(이 달에는 비트코인 가격이 '전통 시장의 법칙'을 따르는지 묻는 논문까지 나왔다), 2008년 금융위기가 딱 10년 지나던 때라 "그때 우리는 왜 위험을 과소평가했는가"를 다시 묻는 연구도 있었다.
흥미로운 점은, 이 달의 상위 논문들이 "다음 달에 오를 종목"을 거의 묻지 않는다는 사실이다. 대신 이런 질문들이 상위권을 채웠다.
- 예측 변수가 백 개쯤 있는데, 하나를 고르는 대신 전부를 어떻게 묶을까?
- 옵션의 '행사할까 말까' 경계를, 계산이 폭발하지 않으면서 정확히 그릴 수 없을까?
- 종목마다 체결 시각이 제각각이라 데이터가 뻥 뚫린 1초 격자에서, 자산 간 상관을 제대로 추정할 수 있을까?
- 포트폴리오 최적화가 뽑아낸 '최적 비중'은, 내가 모형을 조금 틀렸을 때 얼마나 무너질까?
- 종목을 백 개로 늘리면 정말 위험이 줄어드는가, 아니면 모두가 같은 비에 젖는 것뿐인가?
비유하자면, 자동차를 더 빠르게 만드는 대신 "비 오는 날 미끄러지지 않는 제동 장치"를 다듬는 데 집중한 달이다. 이 글은 2018년 3월의 연구를 다섯 개 테마로 묶어, 논문을 안 읽은 분도 끝까지 따라올 수 있게 풀어 본다.
테마 1. 예측 신호 백 개를 하나로 — 버리지 않고 묶는 기술
비유부터: 요리 재료를 줄일까, 소스 배합을 바꿀까
수익률을 예측할 단서(예측 변수)가 백 개쯤 있다면 어떻게 할까? 흔한 방법은 '별로 안 중요한 재료'를 버리는 것이다 — 통계에서는 LASSO 같은 규제 기법이 이 일을 한다. 또 다른 방법은 백 개를 몇 개의 '덩어리'로 압축하는 것이다 — 요인(팩터) 모형이 그렇다. 둘 다 재료를 줄이는 대가로 무언가를 잃는다. 버려진 변수에 진짜 정보가 있을 수도 있고, 압축된 요인은 "이게 뭘 뜻하는지" 설명하기 어렵다.
그러면 반대로, 모든 재료를 살려 둔 채 소스 배합(조합 비율)을 요리 시간에 따라 계속 조정하면 어떨까? 2018년 3월 1위 논문이 바로 이 질문을 수학으로 풀었다.
대표 논문 깊게 보기: Large-Scale Dynamic Predictive Regressions (1803.06738)
워릭 대학교의 Daniele Bianchi와 템플 대학교의 Kenichiro McAlinn이 쓴 이 논문(이 달 1위, 복합점수 66.1)은 "많은 예측 변수를 어떻게 묶을까"에 대한 가장 근본적인 답안 중 하나다. 핵심 아이디어는 세 단계다.
- 예측 변수를 비슷한 묶음으로 나눈다. 예를 들어 '기업 재무비율' 70여 개를 밸류에이션, 수익성, 재무 건전성 같은 여덟 묶음으로 나눈다. 각 묶음은 작은 예측 모델을 따로 돌려, "우리 묶음의 예측"을 하나의 확률 분포(예측밀도)로 낸다.
- 묶음별 예측을 '베이지안 예측 합성'이라는 공식으로 섞는다. 이때 섞는 비율이 고정이 아니라 시간에 따라 변한다. 시장이 요동치면 어떤 묶음의 말을 더 믿을지가 달라지는 것이다. 게다가 묶음끼리 서로 겹치는 정보(의존성)와 각 묶음이 가진 편향까지 함께 학습한다.
- 버리는 게 없다. 모든 변수가 살아 있고, "지금 어떤 묶음이 중요한가"가 숫자로 보인다.
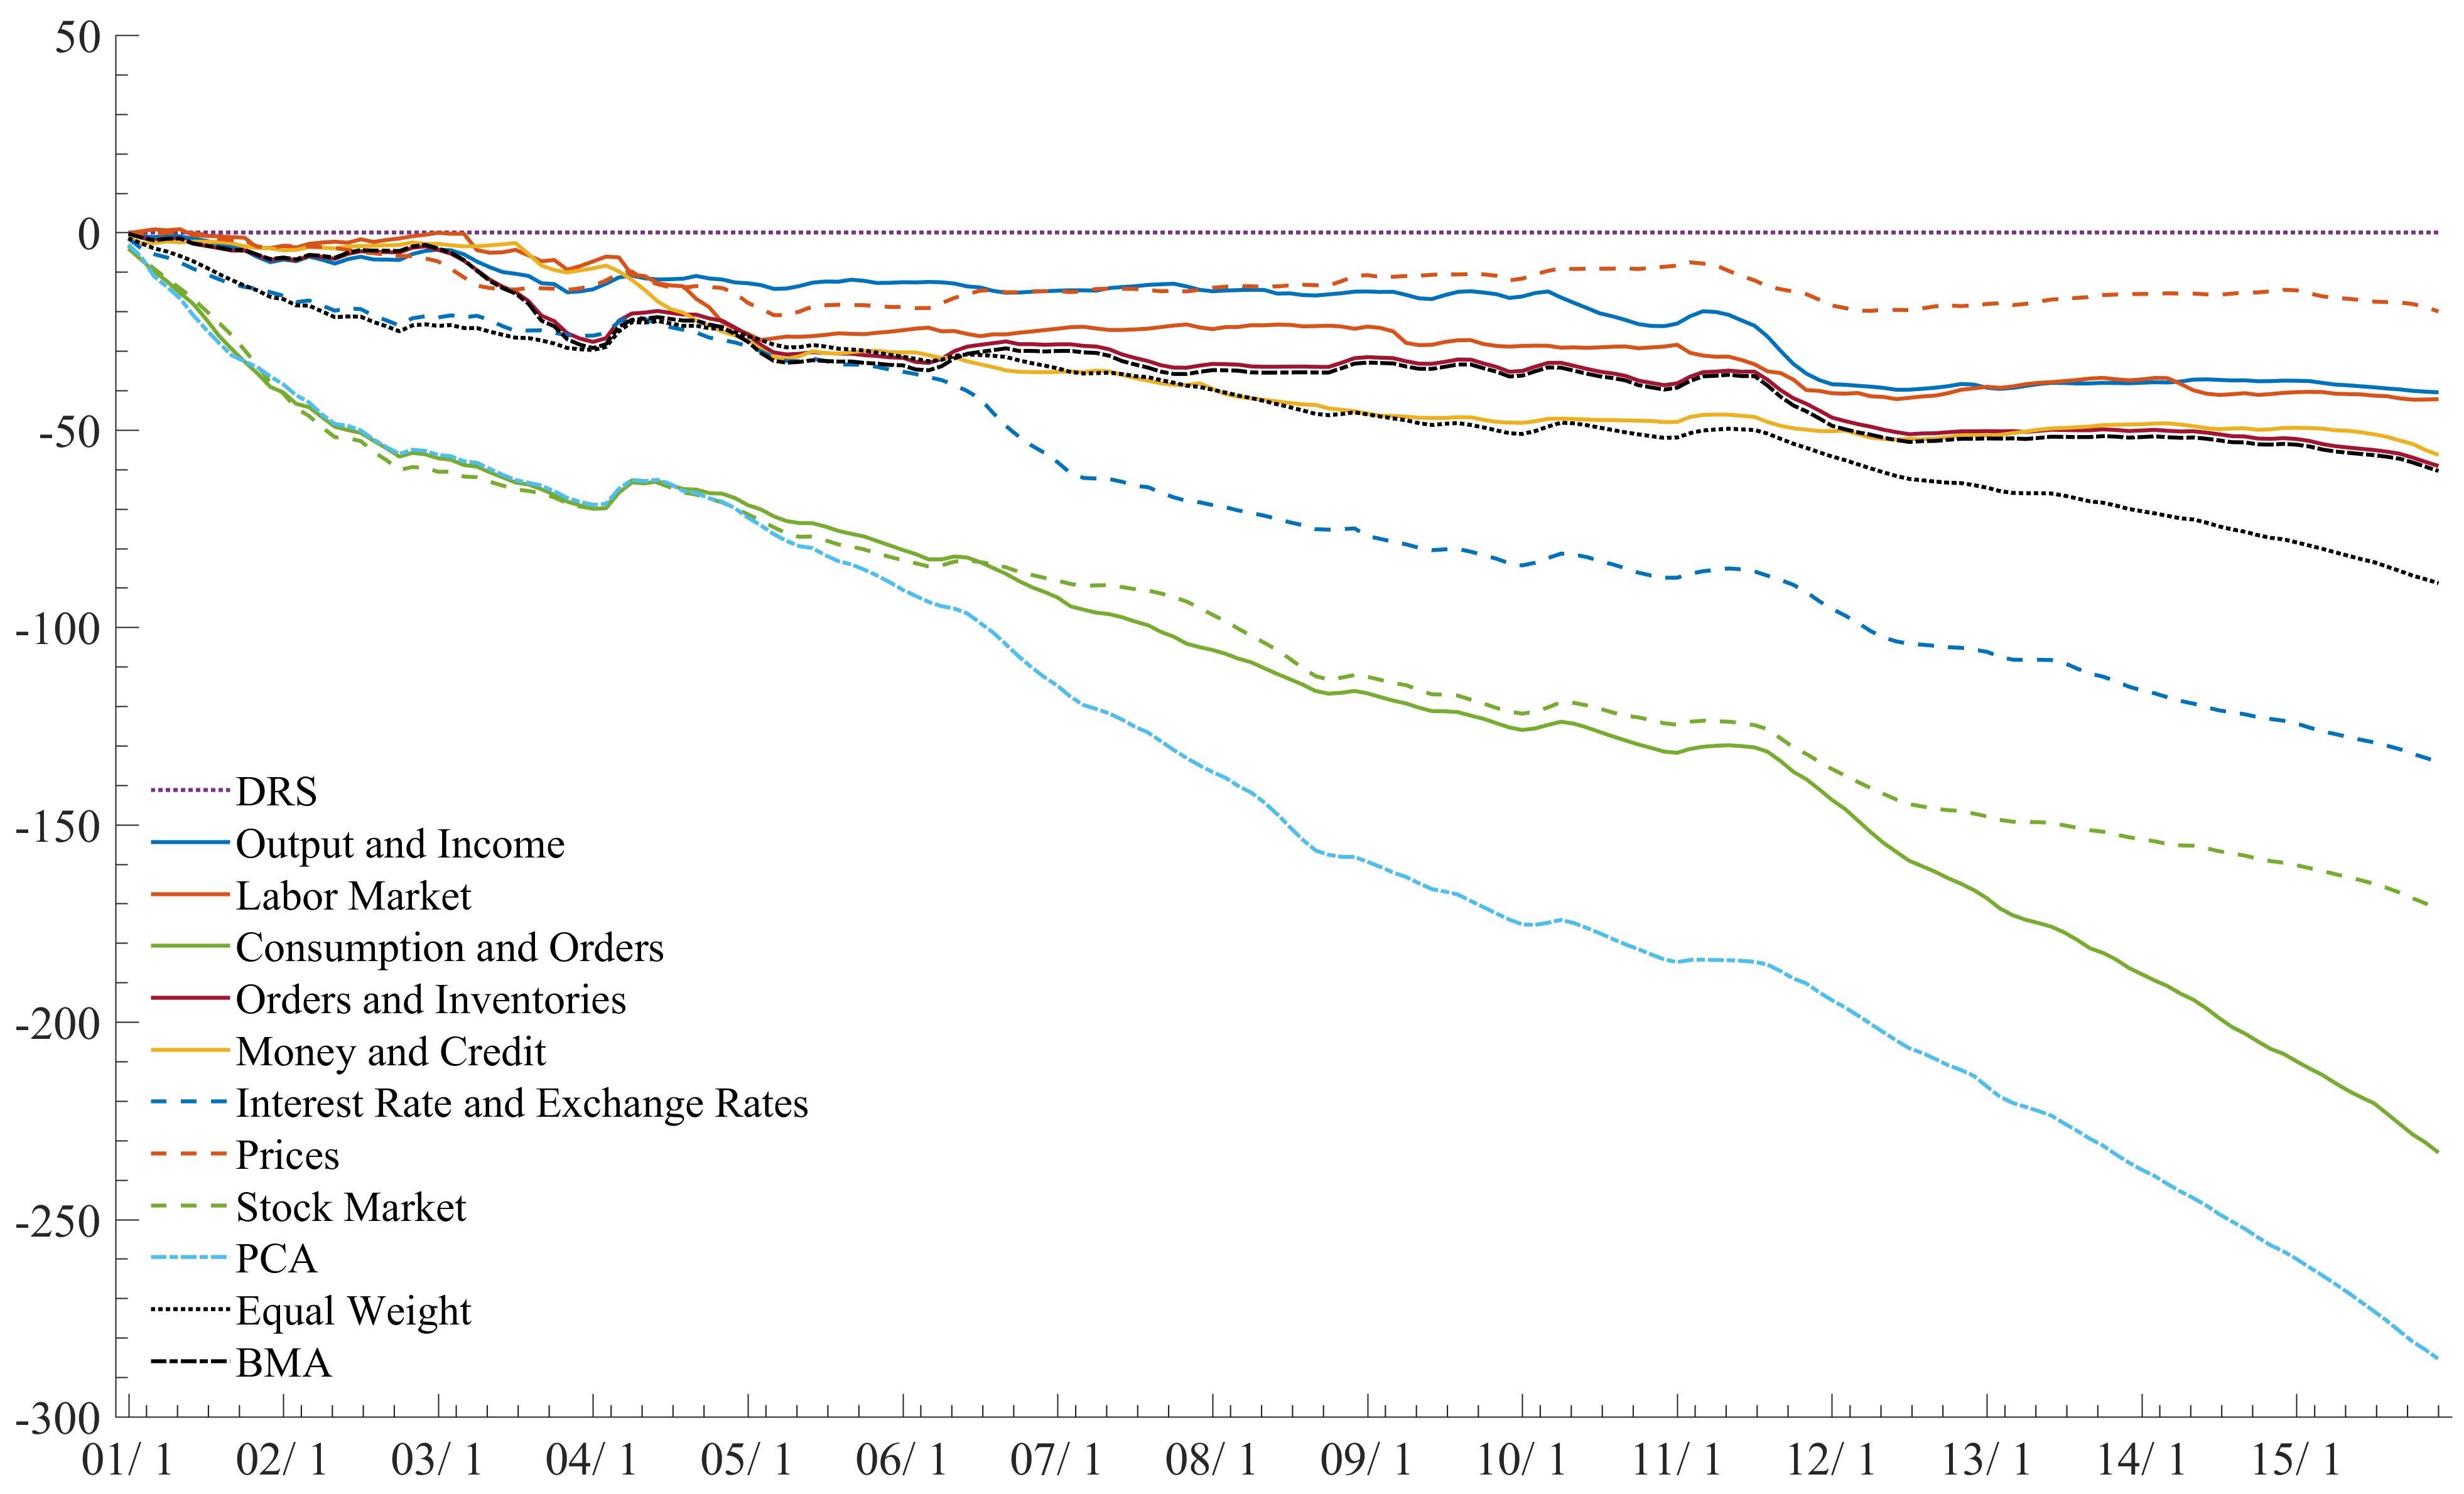
결과가 제법 극적이다. 미국 물가(인플레이션) 예측 실험에서, 이 방법의 오차(RMSFE)는 LASSO의 약 절반, 요인 축약(PCA)의 약 4분의 1 수준이었다. 경쟁 방법 대비 개선 폭은 4%에서 250%가 넘었다. 주식 예측 실험에서는 미국 10개 산업의 초과수익률을 1970년부터 2015년까지 45년치로 검증했는데, 10개 산업 전부에서 이 방법이 가장 좋았다. 재미있는 대목은 그다음이다 — LASSO와 PCA는 '역사적 평균'(아무 예측도 안 하고 과거 평균만 쓰는 것)보다도 나쁜 경우가 많았다. 변수를 버리거나 압축하는 것이 오히려 화를 낸 것이다.
또 하나, '얼마나 자주 맞혔나'(점 오차)가 아니라 '미래 수익률의 분포를 얼마나 잘 예측했나'를 재는 더 까다로운 기준에서는 격차가 더 벌어졌다. 2008년 금융위기 전후로 묶음들의 상대적 중요성이 뒤바뀌는데(예: 위기 전후로 '재무 건전성' 묶음의 역할이 요동친다), 고정된 비율로 섞는 방법들이 무너진 반면 이 방법은 빠르게 적응했다.
한계도 정직하게. 공개 코드는 확인되지 않고(재현성 38), 묶음을 나누는 기준은 사람이 미리 정해야 한다. 각 묶음 안의 모델도 선형이라 아주 급격한 구조변화에는 한계가 있을 수 있다.
이 테마의 공통 인사이트
같은 달의 1803.01389는 "두 자산가격 모형 중 어느 쪽이 더 낫나"의 판정 기준 자체를 — 평균 성과(알파)와 그 불확실성(표준오차)을 하나로 합친 거리 척도로 — 다시 짜자고 제안하고, 1803.00374는 예측 관계가 '어떤 시간 주기에서' 존재하는지 주파수로 분해해 검정한다. 셋이 함께 말하는 것은 이렇다: 예측의 질은 '무엇을 예측 변수로 고르나'보다 '예측들을 어떻게 묶고, 얼마나 정직하게 평가하나'에서 더 크게 갈린다.
테마 논문 한눈에 보기
| 논문 | 한 줄 요약 |
|---|---|
| 1803.06738 (A) | 예측변수 그룹별 예측밀도를 시간에 따라 동적으로 합성 — LASSO·PCA를 압도 |
| 1803.01389 (B) | 모형 비교를 '알파 + 표준오차' 거리로 정직하게 만드는 척도 |
| 1803.00374 (B) | 주파수별 인과성 스펙트럼에서 두드러진 예측 주기를 찾는 부트스트랩 검정 |
테마 2. 옵션 가격의 정확도와 속도 — 경로를 따라 풀고, 옆에서 봐라
비유부터: 천 개의 길을 걸어보는 대신 지형도를 펴라
조기 행사가 가능한 옵션(Bermudan 옵션)의 가격을 매기려면 "언제 행사하는 게 최선인가"를 알아야 한다. 방법은 크게 두 갈래다. 하나는 컴퓨터로 미래 경로를 수십만 번 시뮬레이션해 보는 것(몬테카를로) — 잘 늘어나지만 대신 '행사 경계'가 흐릿하게 나온다. 다른 하나는 지형도(편미분방정식, PDE)를 정밀하게 그려 보는 것 — 정확하지만, 변동성까지 고려하면 지도가 고차원이라 계산이 폭발한다.
2018년 3월의 대표 논문은 이 둘을 "각자의 잘하는 구역"으로 나눠 쓰자고 제안한다.
대표 논문 깊게 보기: Mixing LSMC and PDE Methods to Price Bermudan Options (1803.07216)
토론토 대학교의 David Farahany, Kenneth Jackson, Sebastian Jaimungal이 쓴 이 논문(복합점수 65.9)이 만든 LSMC-PDE 알고리즘은 이렇게 작동한다.
- 변동성의 미래 경로를 시뮬레이션한다 (몬테카를로가 잘하는 일).
- 각 경로 위에서 작은 PDE를 풀어 그 경로에서의 '계속 보유 가치'를 구한다 (PDE가 잘하는 일 — 기초자산 1차원이라 작다).
- 이렇게 나온 수많은 값을 변동성 축을 따라 회귀로 이어 붙여 매끄러운 가치 곡면을 완성한다. 고차원 격자 대신 회귀계수 몇 개만 관리하면 된다.
- '행사할까 말까'의 경계는, 각 시점에서 가치 추정이 변동성에 대해 단조롭다는 성질 덕분에 간단한 1차원 문제로 풀린다.
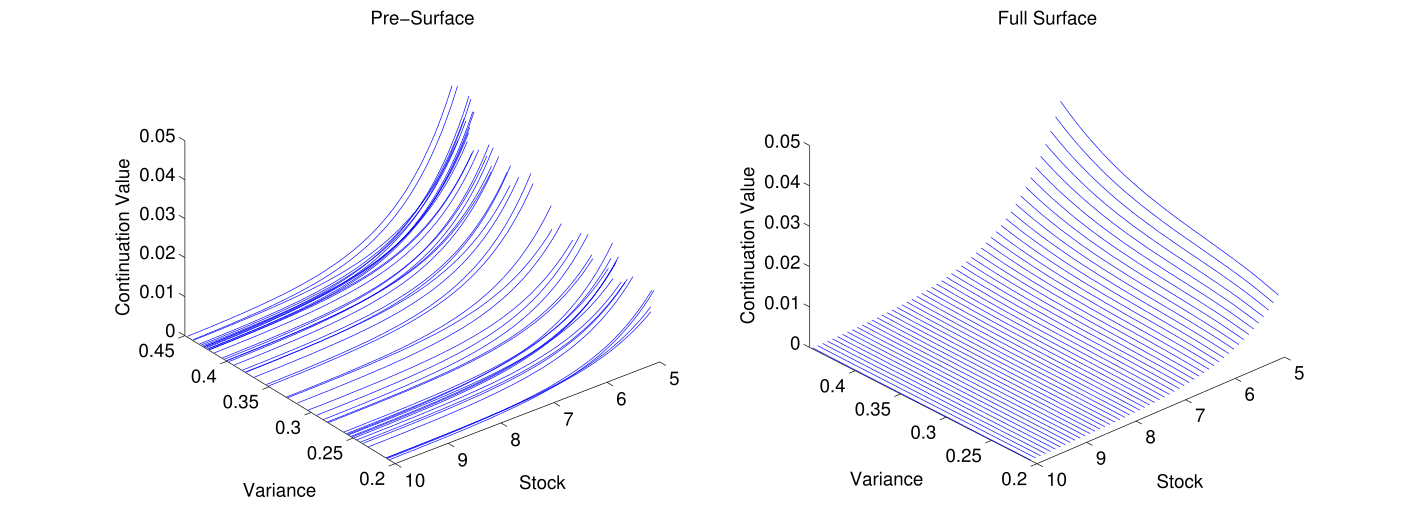
결과를 숫자로 보면. 확률변동성(헤스톤 모형) 아래 Bermudan 풋 옵션에서, 정밀한 유한차분 계산이 준 기준값은 0.7416이었다. LSMC-PDE는 설정에 따라 0.74180.7437로 기준값에 가까웠고(여러 설정이 대부분 소수점 셋째 자리까지 맞았다), 순수 몬테카를로(LSMC)는 0.73610.7372로 수준이 다르게 틀렸다. 계산 시간도 LSMC-PDE가 613초, 순수 LSMC가 1317초로 오히려 빨랐다.
더 인상적인 것은 '행사 경계'의 품질이다. 아래 그림에서 노란 영역은 "이 알고리즘이 맞혔다", 파란 영역은 "틀렸다"는 뜻이다. LSMC-PDE는 경계면 근처에서만 간헐적으로 어긋나는데, 순수 LSMC는 거의 전 구간에서 틀린다 — 기저함수를 바꿔도 나아지지 않았다.
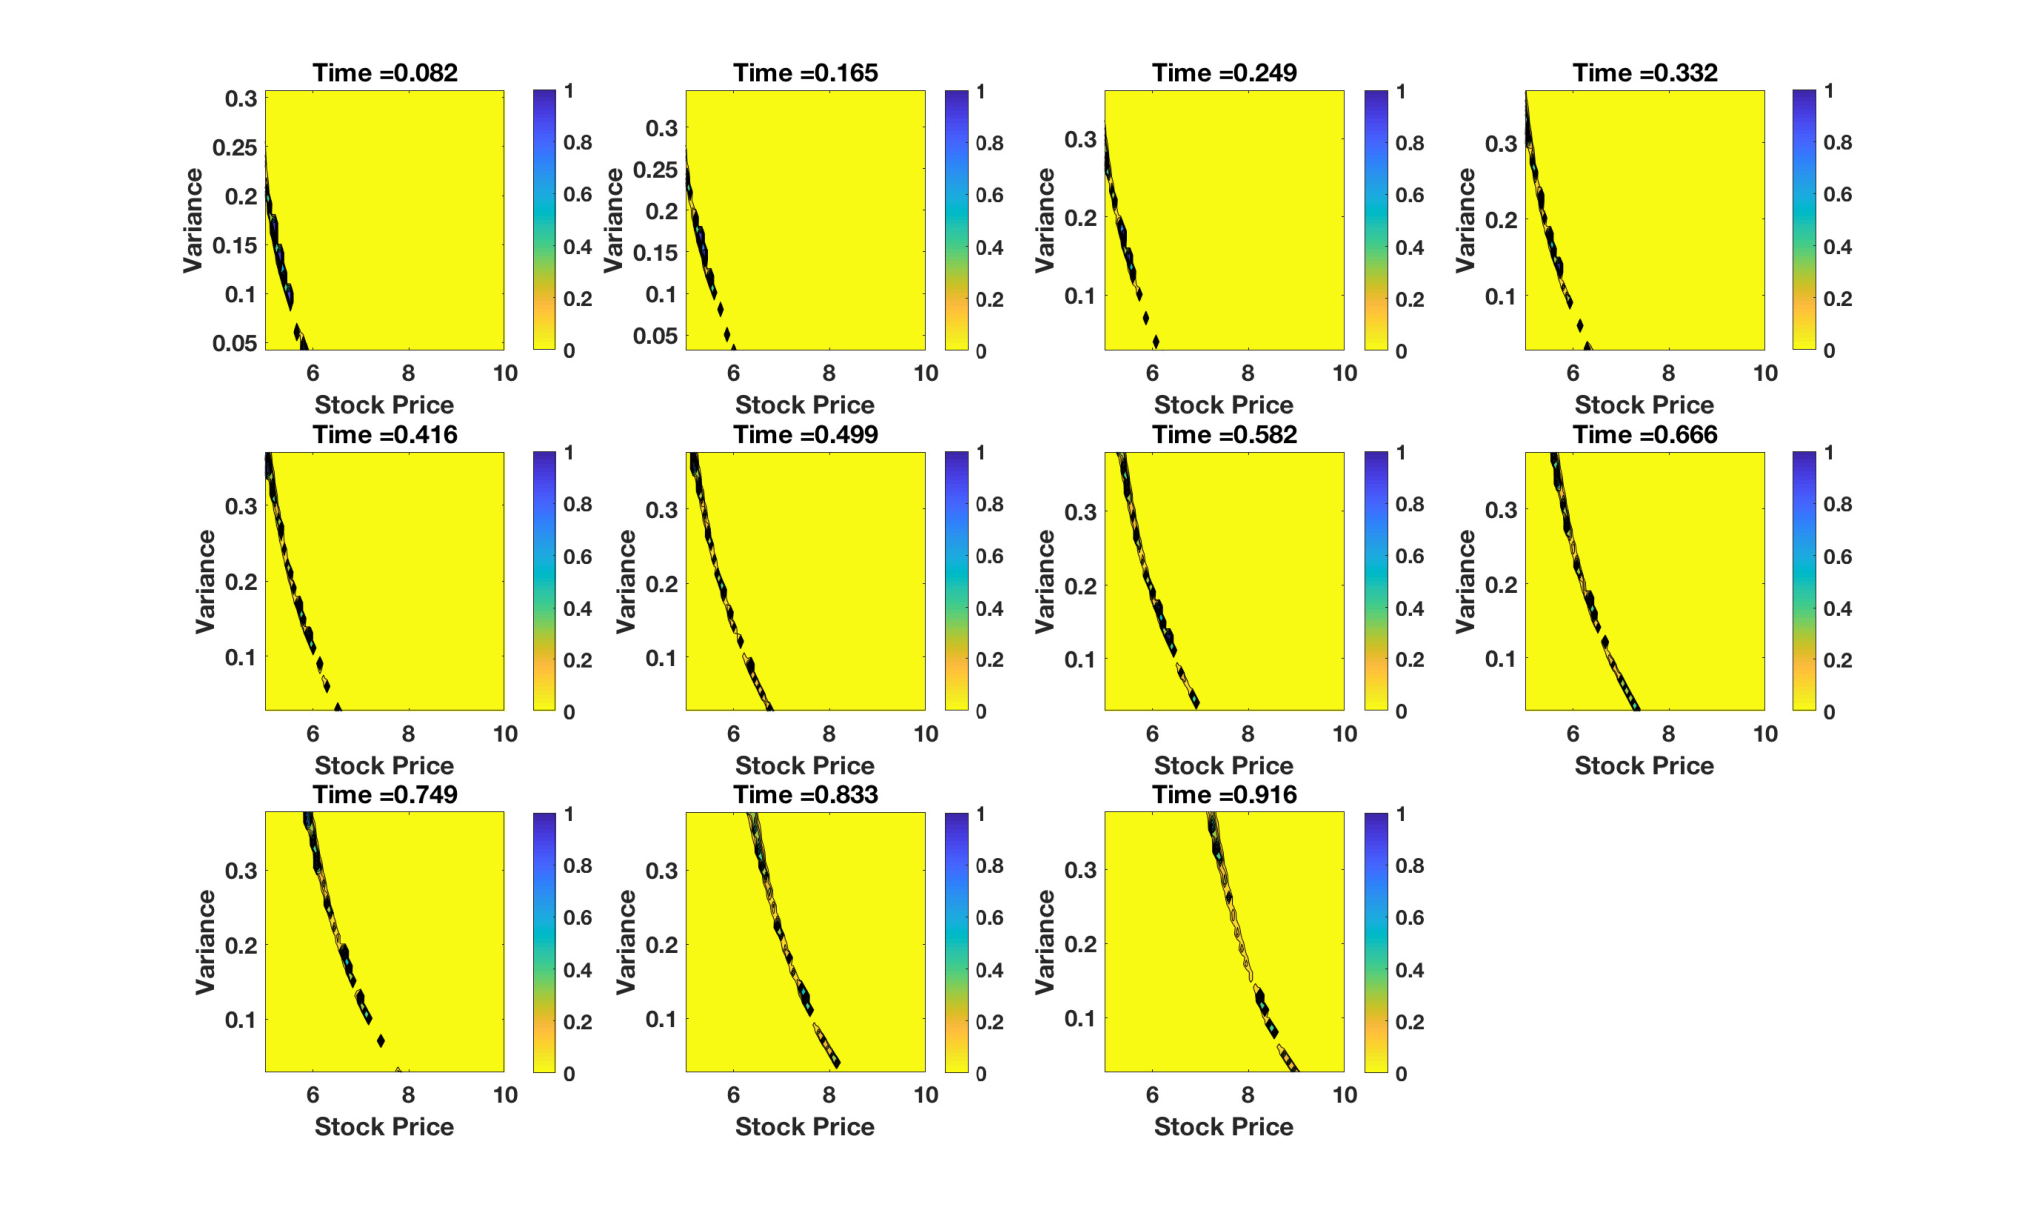
기초자산 두 개를 묶은 베스킷 옵션(2차원 헤스톤) 실험에서는 대조가 더 극명하다. 순수 LSMC는 경로 50만 개를 시뮬레이션하고도 가격 추정이 1.6611(직접 추정)과 1.2028(하한 추정)처럼 크게 벌어져 아직 수렴하지 않았다. LSMC-PDE는 1.18대에서 직접·하한 추정이 밀착했다. 저자들은 분리 가능한 모형군에서 이 알고리즘이 거의 확실하게 수렴함도 증명했다.
한계: 공개 코드가 없고(재현성 38), 수렴 '속도'는 미확정이며, PDE를 푸는 FFT 방식은 구현 편의상 선택한 것이라 최적은 아니다.
이 테마의 공통 인사이트
같은 달의 다른 논문들도 방향은 같다. 1803.04483은 복잡한 시뮬레이션 대신 점근식(중간편차 원리)으로 옵션 가격과 실현분산의 근사 구조를 해석적으로 설명하고, 1803.08803은 다차원 적분을 '접선 초평면 근사'로 바꿔 금리 옵션(스왑션) 가격을 빠르게 내며, 1803.03941은 확률 금리 환경에서 로컬 변동성 모형 보정의 계산 병목을 PDE 기법으로 줄인다. 파생상품 가격결정의 진보는 '더 복잡한 모형'이 아니라 '계산 구조의 재조직'에서 나온다 — 정확함과 빠름은 대체로 서로를 밀어내지 않는다.
테마 논문 한눈에 보기
| 논문 | 한 줄 요약 |
|---|---|
| 1803.07216 (A) | 몬테카를로 + 조건부 PDE로 Bermudan 옵션 가격과 행사 경계를 정확·효율적으로 |
| 1803.04483 (B) | 중간편차 원리로 옵션 가격·실현분산의 점근식을 연결 |
| 1803.02249 (B) | 배당·금리·주식 가격을 하나의 점프-확산 모형으로 통합 |
| 1803.08803 (B) | 접선 초평면 근사로 스왑션 가격평가를 가속 |
| 1803.03941 (B) | 확률 금리 환경의 로컬 변동성 보정을 효율적 PDE로 |
| 1803.08831 (B) | 전력의 장중·현물·선물 가격을 하나의 HJM 구조로 일관되게 연결 |
테마 3. 1초 데이터의 진실 — 지우면 안 되는 잡음과 어긋남
비유부터: 현미경으로 보면 물이 매끈하지 않다
주가를 1초 단위로 들여다보면 아무리 유동성이 큰 종목도 '체결이 고르지 않다' — 어떤 종목은 5초에 한 번, 어떤 종목은 8초에 한 번 거래된다(어긋난 체결, 비동기). 그리고 찍히는 체결가는 호가가 오가는 '시끄러움'(미시구조 잡음)에 오염돼 있다. 흔한 처리법은 데이터를 깨끗하게 만드는 것이다 — 같은 시각으로 맞추고(동기화), 잡음을 부드럽게 펴고(사전평균). 그런데 그 과정에서 관측의 대부분이 사라진다. 정작 알고 싶은 '지금 이 순간 자산들이 얼마나 같이 움직이는가(상관)'는 사라진 데이터 속에 있었다.
대표 논문 깊게 보기: A Score-Driven Conditional Correlation Model for Noisy and Asynchronous Data (1803.04894)
이탈리아(볼로냐·피사·노르말레 수페리오레)와 CME의 Fulvio Corsi 등 네 명이 쓴 이 논문(복합점수 65.3)은 관점을 반대로 뒤집는다. "비어 있는 것은 데이터가 아니라 관측 시계다" — 어긋난 체결은 '결측치가 있는 데이터'로, 잡음은 '관측 오차'로 모형에 정직하게 넣으면, 지우지 않고도 추정할 수 있다는 것이다.
구체적으로는 상태공간 모형(숨겨진 '진짜 가격'과 흐릿한 관측)을 쓰되, 모형 파라미터의 움직임을 예측 우도의 기울기(score) 로 구동한다. 이렇게 하면 칼만필터라는 고전적 도구로 계산이 깔끔하게 끝나고, 상관행렬이 항상 온전한 형태(양의 준정치)로 유지되며, 데이터가 많아도 계산이 버텨 낸다(2단계 추정).
결과가 실용적이다. 먼저 데이터의 현실 — 2014년 뉴욕거래소에서 가장 거래가 많은 상위 250종목을 1초 격자로 만들면, 가장 유동적인 엑슨모빌조차 82%의 칸이 비어 있다(결측 확률 0.816). '결측이 많은 극단적 상황'이 가정이 아니라 현실인 것이다. 그런데도 이 모형은 장중 상관을 안정적으로 추정해 냈다.
추정된 장중 패턴은 그 자체로 흥미롭다. 변동성은 잘 알려진 U자 곡선을 그리는 반면, 자산 간 상관은 하루 종일 오르다가 마감 15분 전에 급락한다. 하루가 갈수록 '개별 종목의 사정'보다 '시장 전체의 파도'가 주식들을 함께 움직이게 한다는 뜻이다(상관행렬의 첫 번째 고유값, 즉 시장 요인의 설명력이 하루 동안 커진다). 연준(FOMC) 회의가 있는 날에는 오후 2시 기자회견 직후의 변동성·상관 급변까지 실시간으로 포착했다.
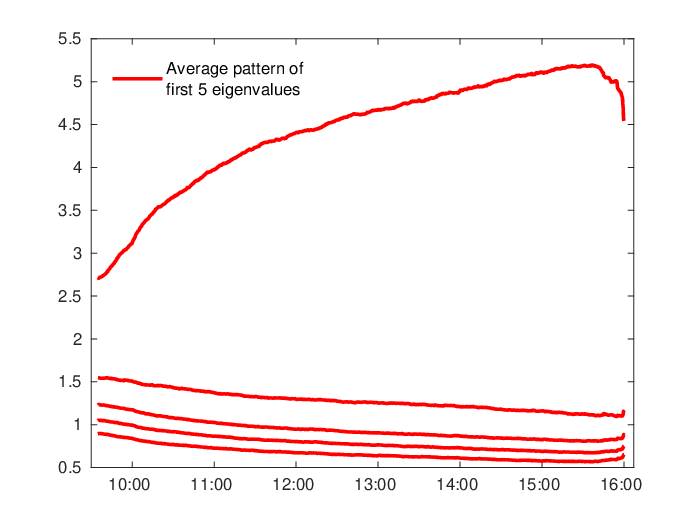
"그래서 돈이 되나?" — 되는지 직접 시험했다. 상위 5종목으로 최소분산 포트폴리오를 짜서, 이 모형의 상관 예측과 표준 방법(DCC)을 경기시키면 120일 중 104일에서 이 모형이 유의하게 좋았고, 포트폴리오 위험(표준편차)이 평균 45% — 어떤 날은 80% 넘게 — 줄었다.
한계: 공개 코드 미확인(재현성 40), 실증은 25종목·2014년 1년에 국한되며, 계산 비용이 표준 방법보다는 크다.
이 테마의 공통 인사이트
같은 달 논문들이 같은 태도를 보인다. 1803.05690은 '내 주문이 얼마나 빨리 체결될까(큐 우선순위)'를 실제 주문장 상태로 계산해 지정가·시장가·취소를 한꺼번에 최적화하고, 1803.06917은 약 1,000종목의 주문장 데이터로 종목을 가리지 않는 가격 형성의 보편적 관계를 딥러닝으로 찾아냈으며, 1803.08390은 대형 펀드의 매매가 시장의 '기억성'을 약화시킨다는 6.7억 건 체결 자료의 실증을 내놓는다. 시장 데이터를 '깨끗하게' 만들 때 잃어버리는 정보가, 오히려 예측력과 실행 품질의 핵심이다.
테마 논문 한눈에 보기
| 논문 | 한 줄 요약 |
|---|---|
| 1803.04894 (A) | 잡음·비동기 체결을 모형에 넣고 1초 단위 상관을 추정 — 포트폴리오 위험 45% 감소 |
| 1803.05690 (B) | 주문장 상태와 큐 우선순위를 반영한 지정가·시장가·취소 통합 최적 실행 |
| 1803.04094 (B) | 부분 정보와 가격충격을 하나의 평균장 게임으로 묶은 알고리즘 트레이딩 이론 |
| 1803.06917 (B) | 약 1,000종목 주문장에서 딥러닝으로 발견한 가격 형성의 보편성 |
| 1803.08336 (B) | TWAP·VWAP 같은 분할 매매 벤치마크가 장중 가격압력을 스스로 만든다는 균형 분석 |
| 1803.08390 (B) | 대형 펀드의 거래 활동이 시장가 주문 부호의 장기기억을 약화시킨다는 실증 |
| 1803.04892 (B) | 거래 횟수·거래량·변동성·스프레드 사이의 스케일링 법칙을 이론과 실증으로 연결 |
테마 4. 최적 포트폴리오의 취약함 — 계산이 틀릴 것을 대비한 투자
비유부터: 일기예보 90%를 믿고 우산을 안 챙길 것인가
포트폴리오 최적화는 '최적 비중'이라는 숫자를 뱉어 냈다. 문제는 그 숫자가 수익률 예측과 상관 같은 모수(추정해서 넣는 숫자들) 위에 세워졌다는 점이다. 추정이 조금만 틀리면 '최적 비중'은 정반대의 비중이 되기도 한다. 거래비용까지 붙으면 실제로는 그 비중에 도달하지 못한다. 2018년 3월의 이 테마 논문들은 각자 다른 각도에서 같은 진단을 내린다 — 최적화의 출력보다, 최적화가 견디는 불확실성의 범위가 더 중요하다.
대표 논문 깊게 보기: Robust utility maximization in markets with transaction costs (1803.04213)
베를린 공대의 Huy N. Chau와 헝가리 레니 연구소의 Miklos Rasonyi가 쓴 이 논문(복합점수 60.5)은 솔직하게 말해 '전략'이 아니라 '존재 증명' 논문이다. 그런데 이 '존재'가 왜 중요한지부터 이해하면, 이 달의 포트폴리오 테마가 한눈에 들어온다.
질문은 이렇다. 투자자는 드리프트(기대수익)뿐 아니라 변동성조차 확신하지 못한다. 이런 불확실성을 '가능한 모형들의 집합'으로 두고, 투자자는 그중 최악의 경우를 대비한 뒤(로버스트), 거래비용까지 감수하며 최선의 전략을 짤 때 — 그런 최적 전략이 정말로 존재하기는 하는가? 거래비용과 변동성 불확실성이 함께 있는 연속시간 시장에서 이 질문에 대한 답이, 이 논문 전까지는 없었다.
저자들은 증명 기술에서 신선한 수를 둔다. 통상의 방법(쌍대 문제를 푸는 접근)이 이 설정에서는 통하지 않아서, 최적화 문제 자체를 직접 다루면서 유한변이 과정 공간에서의 Komlós형 논증을 두 단계로 적용한다. 그 결과 표준 효용에서는 물론, 효용이 무한히 커질 수 있는(비유계) 경우까지 — 거래비용이 있는 광범위한 연속시간 모형에서 최초로 — 최적 전략의 존재를 증명했다. 실무적 흥미는 캘리브레이션 해석에 있다. 추정 파라미터의 신뢰구간을 그대로 '불확실성 범위'로 넣는 것이 이 프레임에서는 자연스럽다.
한계는 크고 분명하다. 명시적 전략이나 계산법이 나오지 않고, 실증이 없으며, 가격의 점프(급변)는 다루지 않았다. '지금 당장 쓸 규칙'이 아니라 '이런 규칙이 이론적으로 성립한다는 보장'이라고 보는 편이 정확하다. 실무 적용은 후속 연구(2206.14015, 2211.00532 등 같은 계보)를 따라가는 게 빠르다.
함께 보면 좋은 다른 각도들
- 1803.03573은 모수 불확실성을 '사후 예측분포'로 반영한 베이지안 평균-분산을 제시한다 — 표본으로 뽑은 효율적 프론티어가 얼마나 불안정한지, 베이지안 프론티어와 겹쳐 보면 한눈에 드러난다.
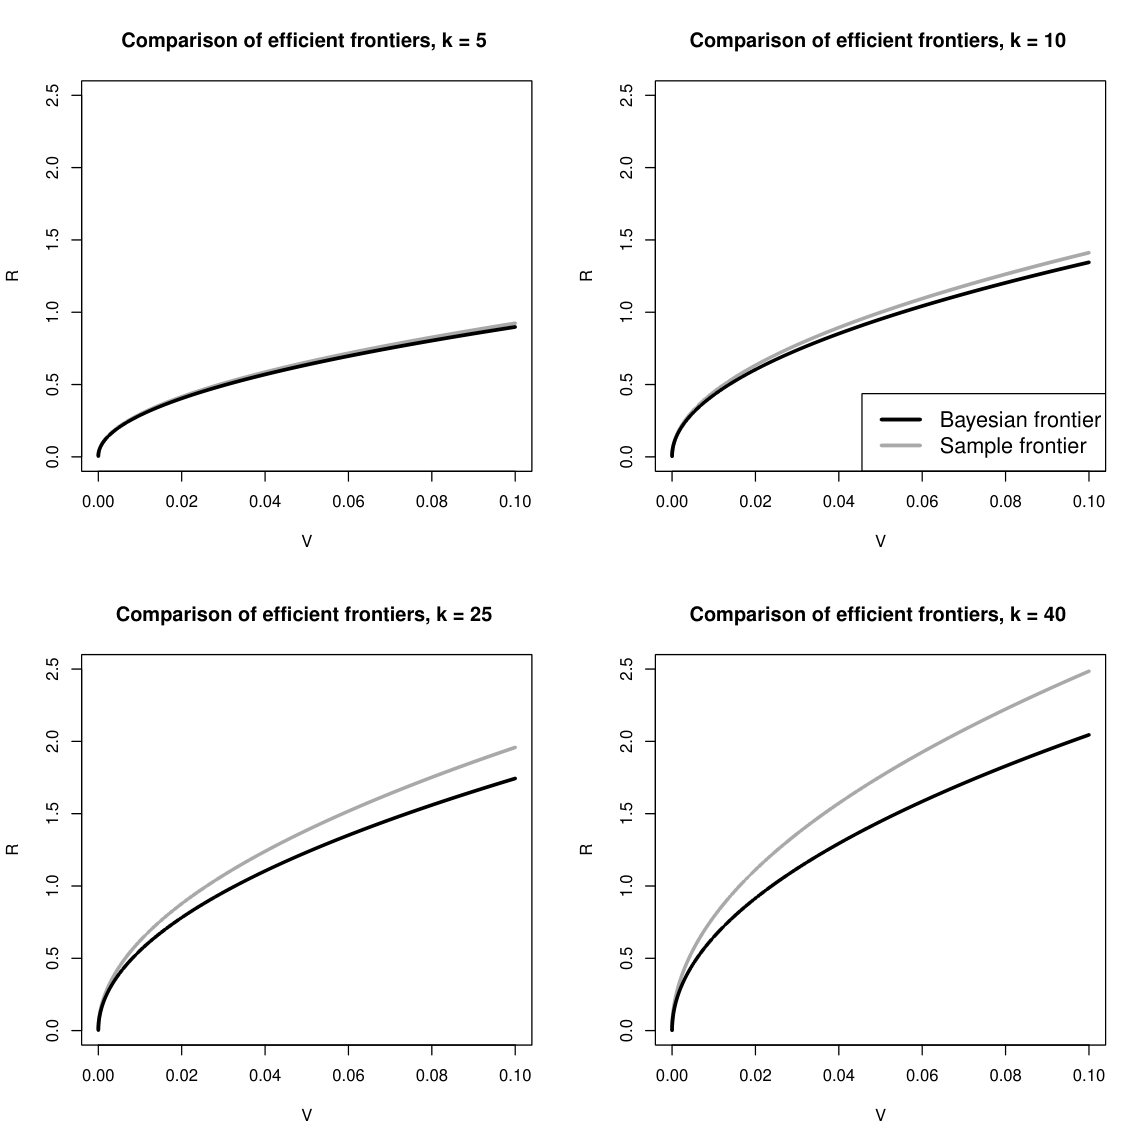
(위 그림은 대표 논문에 캡션 있는 그림이 없어, 같은 테마의 1803.03573에서 가져왔다.)
- 1803.06460은 '평균회귀하는 포트폴리오'를 만들되, 평균회귀성과 희소성(롱-숏 구조의 단순함)을 하나의 최적화로 동시에 잡는다.
- 1803.05819는 벤치마크 초과수익과 추적오차·절대위험을 한 문제로 묶어 폐쇄형(공식으로 바로 계산되는) 최적 비중을 뽑는다.
이 테마의 공통 인사이트
이 달의 포트폴리오 논문들은 "더 나은 최적화 공식"을 경쟁하지 않는다. 대신 점 추정 최적화의 취약함을 각자 다른 방식으로 봉합한다 — 최악의 경우를 대비하고(1803.04213), 불확실성을 분포로 반영하고(1803.03573), 추정하지 않는 성질(평균회귀)을 목적함수로 삼고(1803.06460), 비용과 목표를 한 문제로 합치고(1803.05819). 좋은 비중이란 '계산상 최적'인 비중이 아니라, 틀려도 무너지지 않는 비중이다.
테마 논문 한눈에 보기
| 논문 | 한 줄 요약 |
|---|---|
| 1803.04213 (B) | 거래비용 + 모델 불확실성 연속시간 시장에서 로버스트 효용 최적 전략의 '존재'를 최초로 증명 |
| 1803.03573 (B) | 모수 불확실성을 반영한 베이지안 평균-분산 — 최적 포트폴리오 수익의 예측구간까지 제시 |
| 1803.06460 (B) | 평균회귀와 희소성을 동시에 유도하는 OU-우도 기반 포트폴리오 선택 |
| 1803.02974 (B) | 레버리지 제약을 명시한 통계 차익거래 포트폴리오 설계 |
| 1803.05819 (B) | 초과수익·추적오차·절대위험을 한 문제로 묶은 동적 자산배분 |
| 1803.11467 (B) | 회귀를 최적점 주변에 집중시켜 LSMC 포트폴리오 최적화를 정확·빠르게 |
| 1803.01381 (B) | 벤치마크가 틀린 상황에서도 정직한 성과 평가를 위한 일반화 정보비율 |
테마 5. 신용 리스크와 시장 동학 — 분산화의 안전한 착각
비유부터: 우산 장사를 열 곳에 해도, 모두 같은 비에 젖는다
"여기에 투자하고 저기에 투자하면 위험이 줄어든다" — 분산화의 신앙이다. 그런데 신용(채무) 포트폴리오의 세계에서는 이 말이 자주 틀린다. 기업들은 서로 얽혀 있고(자산 상관), 위기가 오면 같은 방향으로 함께 무너진다. 게다가 그 상관 자체가 평소와 위기 때 다르게 움직인다. 2008년이 그 증거였다. 2018년 3월 — 위기 10주기 — 에 나온 이 논문은 '상관이 변한다'는 사실을 랜덤행렬 이론으로 정확히 계산에 넣자고 제안한다.
대표 논문 깊게 보기: Credit Risk Meets Random Matrices (1803.00261)
뒤스부르크-에센 대학교의 Andreas Mühlbacher와 Thomas Guhr가 쓴 이 논문(복합점수 64.0, 이 테마 1위)은 저자들의 선행 연구를 정리한 리뷰이지만, 메시지가 단순하고 강렬하다.
- 상관행렬은 '하나의 숫자 표'가 아니라 '요동치는 표들의 모임'이다. 짧은 기간으로 잘라 측정한 상관행렬들을 모아 보면 그 집합 자체가 랜덤행렬(Wishart 모형)로 설명된다. 덕분에 복잡한 상관 구조가 '평균 상관'과 '요동 강도' 두 숫자로 압축된다.
- 이 상관의 평균을 신용 리스크의 고전 모형(머턴 모형)에 넣고 포트폴리오 손실분포를 계산하면, 놀라운 결론이 나온다.
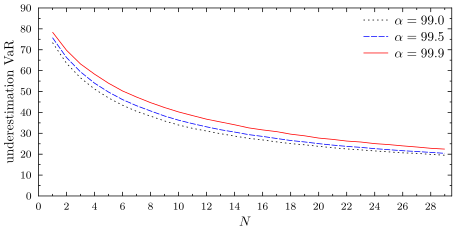
결론 1: 분산화가 거의 통하지 않는다. S&P 500 데이터(1992~2012)로 계산해 보면, 포트폴리오에 채무 계약을 10개 → 100개 → 무한개로 늘려도 손실분포가 아주 빨리 '극한 분포'로 수렴한다. 크게 잃을 위험이 줄지 않는다는 뜻이다. 쉽게 말하면, 상관이 채무자들을 하나로 묶어 두어 '열 개를 든 셈'이 아니라 '거의 하나를 든 셈'로 만든다.
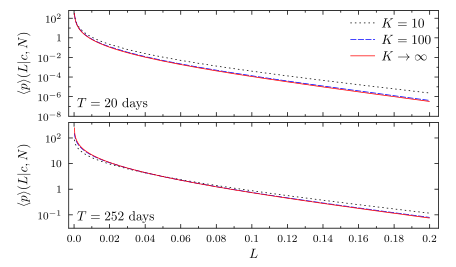
결론 2: 상관의 요동을 무시하면 리스크가 30~40% 낙관적으로 나온다. 상관을 '평소 값'으로 고정(정상 가정)해 두면, 2006~2010년 실제 데이터 기준으로 Value at Risk(일정 신뢰수준에서의 최대 예상 손실)가 30~40% 과소평가됐다. 반대로, 상관의 요동은 넣되 종목별 변동성만 제대로 추정하면 계산이 실제와 잘 들어맞았다 — 중요한 교훈은 '공분산 행렬의 구조'보다 '변동성 추정의 질'이 리스크 계산을 좌우한다는 점이다.
결론 3: 두 포트폴리오가 함께 무너지는 방식도 따로 봐야 한다. S&P 500의 272개사와 니케이 225의 179개사, 21년치(1993년 1월~2014년 4월) 데이터를 쓴 시뮬레이션에서, 종목별 변동성이 서로 다르다는 사실만으로도 두 포트폴리오 손실의 의존 구조(코퓰라)는 이상적인 가우시안 형태에서 벗어났다. 특히 큰 손실이 동시에 몰리는 '꼬리 모서리'에서 편차가 컸다 — CDO처럼 여러 포트폴리오를 함께 드는 투자자에게 결정적인 위험이다.
한계: 리뷰 논문이라 원 결과는 저자들의 별도 논문들에 있으며(수치 인용 시 원 출처 확인 권장), 머턴 구조모형과 대규모 동질 포트폴리오라는 가정에 의존한다. 재현성은 48이다.
이 테마의 공통 인사이트
같은 달의 1803.08160은 경제 버블이 '언제 꺼질까'를 최초통과시간(가격이 아래 경계를 처음 넘는 시점)의 분포로 다루고, 1803.08405는 2017년 비트코인 폭등·폭락 직후에 비트코인의 극단값이 전통 시장의 스케일링 법칙을 따르는지 묻는다. 고정된 것으로 치부되던 것들 — 상관, 붕괴 시점, 스케일링 법칙, 심지어 시장 간 주도권(1803.09432의 위안화 리드-래그 전환) — 을 '변하는 것'으로 모델링할 때, 꼬리 위험이 비로소 보인다.
테마 논문 한눈에 보기
| 논문 | 한 줄 요약 |
|---|---|
| 1803.00261 (B) | 상관 요동을 랜덤행렬로 모델링 — 분산화의 한계와 VaR 30~40% 과소평가를 정량화 |
| 1803.08160 (B) | 버블의 하방 붕괴 시점을 최초통과시간 분포로 추정하는 수학적 틀 |
| 1803.08405 (B) | 비트코인 극단값의 스케일링이 전통 시장의 법칙을 따르는지 검사 |
| 1803.09432 (B) | 온쇼어·오프쇼어 위안화의 주도권이 시간에 따라 바뀐다는 동적 리드-래그 분석 |
| 1803.05831 (B) | 자원 매장량의 기술적 불확실성과 학습을 실물옵션 투자 결정에 통합 |
| 1803.10128 (B) | 무작위 종료 시점의 시장에서 모든 감소과정을 명시적으로 분류 |
| 1803.00329 (B) | 포아송 개입 시점에만 결정할 수 있는 최적 중지 게임을 벌점 방정식으로 특성화 |
2018년 3월, 한 장의 그림으로 보면
이 달의 다섯 테마는 사실 하나의 문장으로 모인다 — "고정된 것처럼 보이는 것들을 변하는 것으로 다룰 때, 계산이 현실에 가까워진다." 예측은 변수군 간 관계가 변한다고 보아 합성 비율을 실시간으로 조정했고(테마 1), 옵션은 변동성이라는 움직이는 상태를 경로와 회귀로 분업해 행사 경계를 정확히 그렸으며(테마 2), 1초 데이터는 잡음과 어긋남을 지우는 대신 모형에 넣어 45%의 위험 감소를 얻었고(테마 3), 포트폴리오는 '계산이 틀릴 가능성' 자체를 최적화의 제약으로 삼았으며(테마 4), 신용 리스크는 상관이 요동친다는 사실만으로 분산화의 신화를 깨뜨렸다(테마 5).
2018년의 시점에서 보면 이 달은 '기계학습이 금융의 유행어가 되기 직전'의 풍경이다. 딥러닝은 아직 주가 예측의 소박한 비교(ARIMA 대 LSTM) 수준이었고, 강화학습은 '이상화된 거래 게임' 실험 단계였다. 그런데 같은 달에 이미 약 1,000종목 주문장에서 가격 형성의 보편성을 찾는 딥러닝 연구가 나와 있었다(1803.06917) — 이후 초고빈도 딥러닝 시대를 예고하는 씨앗이었다. 요컨대 2018년 3월은 "더 똑똑한 예측"보다 "덜 틀리는 계산"이 이기던 달이고, 그 교훈은 8년이 지난 지금도 유효하다.
더 알아보기
이 글에서 깊게 다룬 다섯 논문의 원문과 평가 점수, 그리고 이어 읽을 만한 논문들이다. 점수는 오셀랩 KB의 5차원 평가(새로움·적용성·엄밀성·재현성·통찰, 각 100점 만점)로, 참고용이다.
1. Large-Scale Dynamic Predictive Regressions (Bianchi & McAlinn, 2018)
- 원문: https://arxiv.org/abs/1803.06738
- KB 점수: 새로움 76 · 적용성 72 · 엄밀성 68 · 재현성 38 · 통찰 70 (복합 66.1, A등급)
- 이어 읽기: Decision-Focused Forecasting: A Differentiable Multistage Optimisation Approach — 예측을 '결정의 품질'로 평가하자고 제안하는 후속 흐름의 연구
2. Mixing LSMC and PDE Methods to Price Bermudan Options (Farahany, Jackson & Jaimungal, 2018)
- 원문: https://arxiv.org/abs/1803.07216
- KB 점수: 새로움 68 · 적용성 70 · 엄밀성 78 · 재현성 38 · 통찰 65 (복합 65.9, A등급)
- 이어 읽기: Leave-one-out least squares Monte Carlo algorithm for pricing Bermudan options, Closed-form approximations with respect to the mixing solution for option pricing — LSMC와 혼합 접근의 후속 개선 연구들
3. A Score-Driven Conditional Correlation Model for Noisy and Asynchronous Data (Buccheri, Bormetti, Corsi & Lillo, 2018)
- 원문: https://arxiv.org/abs/1803.04894
- KB 점수: 새로움 76 · 적용성 72 · 엄밀성 79 · 재현성 40 · 통찰 70 (복합 65.3, A등급)
- 이어 읽기: When Frictions are Fractional: Rough Noise in High-Frequency Data, An Intraday GARCH Model for Discrete Price Changes and Irregularly Spaced Times — 고빈도 잡음·비동기 데이터 연구의 계보
4. Robust utility maximization in markets with transaction costs (Chau & Rasonyi, 2018)
- 원문: https://arxiv.org/abs/1803.04213
- KB 점수: 새로움 72 · 적용성 39 · 엄밀성 86 · 재현성 38 · 통찰 64 (복합 60.5, B등급)
- 이어 읽기: Robust utility maximization with nonlinear continuous semimartingales, Robust utility maximisation under proportional transaction costs for contingent claims — 같은 문제를 실무 쪽으로 넓힌 후속 연구
5. Credit Risk Meets Random Matrices: Coping with Non-Stationary Asset Correlations (Mühlbacher & Guhr, 2018)
- 원문: https://arxiv.org/abs/1803.00261
- KB 점수: 새로움 66 · 적용성 68 · 엄밀성 62 · 재현성 48 · 통찰 72 (복합 64.0, B등급)
- 이어 읽기: Consistent Estimation of the High-Dimensional Efficient Frontier, Mitigating optimistic bias in entropic risk estimation and optimization — 상관·위험 추정의 왜곡을 다루는 최근 연구들
이 글은 2018년 3월 arXiv 코호트(총 85편, 관련 53편)를 오셀랩 KB의 재평가 기준으로 정리한 월간 종합이다. 논문별 상세 평가는 백필 리포트(analysis/reports/backfill/1803.md)에, 같은 달의 다른 주목 논문 23편의 요약도 거기에 있다.
📚 이 글에서 다룬 논문 (39편)
- ALarge-Scale Dynamic Predictive Regressions
Daniele Bianchi, Kenichiro McAlinn
- AMixing LSMC and PDE Methods to Price Bermudan Options
David Farahany, Kenneth Jackson, Sebastian Jaimungal
- AA Score-Driven Conditional Correlation Model for Noisy and Asynchronous Data: an Application to High-Frequency Covariance Dynamics
Giuseppe Buccheri, Giacomo Bormetti, Fulvio Corsi 외 1명
- BCredit Risk Meets Random Matrices: Coping with Non-Stationary Asset Correlations
Andreas Mühlbacher, Thomas Guhr
- BOptimal liquidity-based trading tactics
Charles-Albert Lehalle, Othmane Mounjid, Mathieu Rosenbaum
- BPathwise moderate deviations for option pricing
Antoine Jacquier, Konstantinos Spiliopoulos
- BA Term Structure Model for Dividends and Interest Rates
Damir Filipović, Sander Willems
- BMean Field Games with Partial Information for Algorithmic Trading
Philippe Casgrain, Sebastian Jaimungal
- BAn Economic Bubble Model and Its First Passage Time
Angelos Dassios, Luting Li
- BRobust utility maximization in markets with transaction costs
Huy N. Chau, Miklos Rasonyi
- BBayesian mean-variance analysis: Optimal portfolio selection under parameter uncertainty
David Bauder, Taras Bodnar, Nestor Parolya 외 1명
- BMean Reverting Portfolios via Penalized OU-Likelihood Estimation
Jize Zhang, Tim Leung, Aleksandr Y. Aravkin
- BA structural Heath-Jarrow-Morton framework for consistent intraday, spot, and futures electricity prices
Wieger Hinderks, Andreas Wagner, Ralf Korn
- BOutperformance and Tracking: Dynamic Asset Allocation for Active and Passive Portfolio Management
Ali Al-Aradi, Sebastian Jaimungal
- BEquilibrium Effects of Intraday Order-Splitting Benchmarks
Jin Hyuk Choi, Kasper Larsen, Duane J. Seppi
- BLocal Control Regression: Improving the Least Squares Monte Carlo Method for Portfolio Optimization
Rongju Zhang, Nicolas Langrené, Yu Tian 외 3명
- BOptimal Portfolio Design for Statistical Arbitrage in Finance
Ziping Zhao, Rui Zhou, Zhongju Wang 외 1명
- BLarge large-trader activity weakens the long memory of limit order markets
Kevin Primicerio, Damien Challet
- BA bootstrap test to detect prominent Granger-causalities across frequencies
Matteo Farné, Angela Montanari
- BTime-dependent lead-lag relationship between the onshore and offshore Renminbi exchange rates
Hai-Chuan Xu, Wei-Xing Zhou, Didier Sornette
- BTechnical Uncertainty in Real Options with Learning
Ali Al-Aradi, Alvaro Cartea, Sebastian Jaimungal
- BDynkin games with Poisson random intervention times
Gechun Liang, Haodong Sun
- BTheoretical and empirical analysis of trading activity
Mathias Pohl, Alexander Ristig, Walter Schachermayer 외 1명
- BFast swaption pricing in Gaussian term structure models
Jaehyuk Choi, Sungchan Shin
- BScaling properties of extreme price fluctuations in Bitcoin markets
Stjepan Begušić, Zvonko Kostanjčar, H. Eugene Stanley 외 1명
- B
- ADecision-Focused Forecasting: A Differentiable Multistage Optimisation Architecture
Egon Peršak, Miguel F. Anjos
- ALeave-one-out least squares Monte Carlo algorithm for pricing Bermudan options
Jeechul Woo, Chenru Liu, Jaehyuk Choi
- AWhen Frictions are Fractional: Rough Noise in High-Frequency Data
Carsten H. Chong, Thomas Delerue, Guoying Li
- ARobust utility maximization with nonlinear continuous semimartingales
David Criens, Lars Niemann
- BRobust utility maximisation under proportional transaction costs for càdlàg price processes
Christoph Czichowsky, Raphael Huwyler
- AConsistent Estimation of the High-Dimensional Efficient Frontier
Taras Bodnar, Nikolaus Hautsch, Yarema Okhrin 외 1명
- AMitigating optimistic bias in entropic risk estimation and optimization
Utsav Sadana, Erick Delage, Angelos Georghiou
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.
 📊 2026-07 월간
7월의 AI 투자 연구: 더 큰 모델이 정답이 아니다
2026년 7월 시스템 트레이딩 연구 동향. LLM 에이전트 비용 최적화, DEX 라우팅 $2,400만 손실 계량화, 추세추종의 주파수 영역 해석, 포트폴리오 분포 불확실성 강건 최적화, 시계열 부트스트랩 실용화.