"가격을 예측하기 전에, 내 매매가 가격에 미치는 힘부터 계산에 넣자." 2018년 4월에 나온 금융 연구들은 대체로 이런 자세였다. 이 달의 상위 논문들을 한 문장으로 요약하면 이렇다 — 큰 주문을 넣으면 시장이 밀려난다는 사실을 수학으로 풀어낸 최적 투자 이론, 실제 주문장 데이터 위에서 스스로 호가를 배우는 강화학습 마켓메이커, 데이터가 적어도 포트폴리오가 폭발하지 않게 만드는 기계학습, "요인은 사실 몇 개가 아니라 종목마다 다르다"며 파마-프렌치 5요인을 이긴 새 자산가격 모형, 그리고 옵션 시장의 '무차익' 법칙을 지키면서 1초 만에 변동성 표면을 그리는 알고리즘. 화려한 예측 대신 "계산이 현실의 마찰을 얼마나 담고 있는지"를 묻는 한 달의 기록을 다섯 갈래로 풀어 본다.
들어가며: 세상의 모든 계산에는 마찰이 있다
2018년 4월의 시장은 요동치고 있었다. 비트코인은 2017년 말의 거품이 꺼진 뒤였고(이 달에만 비트코인 실증 논문이 3편이나 나왔다), 미중 무역 긴장이 시작되던 시기였다. 그런데 그 달의 금융 연구들은 "다음 달 오를 종목"을 묻지 않았다. 대신 이런 질문들이 상위권을 채웠다.
- 내가 주식 10만 주를 팔면 가격이 밀린다. 밀린 가격까지 감수한 '진짜 최적 매도법'은 무엇인가?
- 사람이 마켓메이커(양쪽 호가를 다는 유동성 공급자) 일을 기계에게 맡기려면, 기계가 재고 위험을 피하는 법을 어떻게 배우게 하는가?
- 포트폴리오를 짜려면 자산들 사이의 관계를 추정해야 하는데, 데이터가 적어서 계산이 폭발하는 문제는 어떻게 없앨 수 있는가?
- 수익률을 설명하는 '요인(팩터)'은 대체 몇 개이고, 그 요인을 통계적으로 정직하게 고르는 법은 무엇인가?
비유하자면, 자동차 엔진을 더 세게 튜닝하기 전에 "이 속도에서 타이어가 도로를 얼마나 잡는지"부터 시험하는 달이었다. 이 글은 2018년 4월의 연구를 다섯 개 테마로 묶어, 논문을 안 읽은 분도 따라올 수 있게 풀어 본다.
테마 1. 가격충격과 최적 청산 — "내 매매가 시장을 움직인다"
비유부터: 시장은 수영장, 내 주문은 돌
작은 주문은 아무 일도 일으키지 않는다. 하지만 큰 주문은 다르다 — 수영장에 돌을 던지면 물이 밀리고, 잠시 후에야 제자리로 돌아온다. 시장도 그렇다. 큰 매도 주문은 가격을 내리고(일시적 충격), 그 자국은 곧바로 사라지지 않고 서서히 회복된다. 그런데 대부분의 투자 이론은 이 '물이 밀리는 힘'을 계산에서 뺀 채 "얼마나 좋은 자산을 얼마나 사느냐"만 묻는다. 그러면 계산된 최적 매매량은 현실에서 실행할수록 손해를 보는, 너무 낙관적인 숫자가 된다.
대표 논문 깊게 보기: transient price impact 모형에서의 최적 투자 (1804.07392)
베를린 공대의 Peter Bank와 UC 산타바바라의 Moritz Voß가 쓴 이 논문(이 달 1위, 복합점수 70.0)은 "밀리는 시장에서 어떻게 투자해야 하는가"를 처음부터 끝까지 수학으로 풀었다. 핵심 아이디어는 세 가지다.
- 시장을 세 가지 숫자로 표현한다. 시장 깊이(한 번에 얼마나 밀리는가), 스프레드(사자 가격과 팔자 가격의 간격), 회복력(밀린 가격이 얼마나 빨리 돌아오는가). 매수 가격과 매도 가격을 서로를 향해 회복하는 두 개의 곡선으로 그려, 거래에 따르는 비용이 자연스럽게 '볼록한 곡선'으로 계산되게 했다.
- 한 번에 '던지는' 매매까지 허용한다. 현실에서 큰 주문을 쪼개기만 하면 안 되고, 때로는 블록으로 한 번에 처리해야 유리할 때가 있다. 논문은 이런 '점프'하는 매매까지 포함해 최적 전략을 찾는다.
- 어려운 문제를 쉬운 문제로 바꾼다. 특정 조건(가격이 무작위로 걷는 '브라운 운동'이고 투자자의 성향이 일정할 때)에서는, 이 복잡한 투자 문제가 "이상적인 목표 포트폴리오를 비용을 감수하며 따라잡는 추적 문제"로 단순해진다. 그리고 이 단순해진 문제를 풀어 최적 전략의 지도를 그렸다.
그 지도가 놀랍다. 아래 그림처럼 '남은 시간', '현재 스프레드', '보유 주식 수'로 만든 3차원 세계에서, 최적 행동은 세 개의 영역으로 나뉜다.
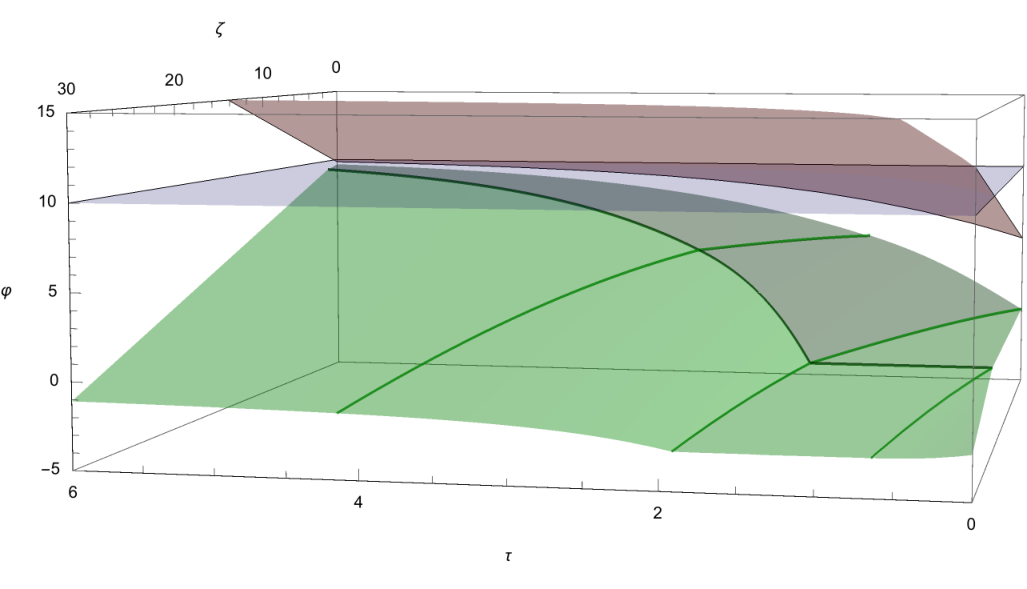
- 경계 밖에 있으면 — 지금 당장 한 번에 밀어내서(또는 사서) 경계선까지 이동한 뒤, 경계선을 따라가며 조금씩 거래한다.
- 두 경계 사이에 있으면 — 아무것도 하지 않고 기다리는 게 최선이다. 스프레드가 좁아지고 시간이 지나 경계에 닿는 순간 다시 움직인다.
- 만기가 가까워지면 — 남은 주식은 마지막에 한 번에 정리한다.
쉽게 말하면 "급하게 팔 때는 찔끔찔끔이 아니라 한 방에, 평소에는 스프레드가 좁아질 때까지 인내하는" 규칙이다. 스프레드가 넓을수록 '기다리는 영역'이 넓어진다는 예측은, 시장이 혼잡할 때 섣불리 움직이지 말아야 한다는 실무 감각과 정확히 일치한다. 논문은 특수한 경우에 기존 연구의 유명한 결과(Obizhaeva-Wang의 최적 청산)가 그대로 나오는 것도 확인해, 계산의 정합성을 점검했다.
한계와 실무 이야기
이 명시적인 해는 아직 단순한 세계(한 개 자산, 특정한 수익 분포, 일정한 위험 회피 성향)에서만 나온다. 유동성 파라미터도 현실처럼 시시각각 변하지 않고 상수로 둔다. 게다가 공개 코드가 없어(재현성 42) 직접 구현해야 한다. 그래도 "매도·매수·대기"의 3단 구조는 실행 알고리즘의 설계 원리로 그대로 쓸 수 있다.
이 테마에는 이론의 상대편인 실증 논문도 있다. 1804.09565(Co-impact)는 미국 주식 기관투자자들의 대형 주문(메타오더) 770만 건을 분석해, 시장이 개별 주문 하나하나가 아니라 "지금 시장에 몰려 있는 주문들의 순 합(순주문흐름)과 방향의 군집성"에 반응한다는 사실을 보였다. 여러 기관이 같은 방향으로 몰릴 때 충격이 예상보다 커진다는 뜻이다 — 큰 주문의 실행 비용을 계산할 때 "남들도 같은 방향인지"를 넣어야 한다는 이야기다. 1804.04170은 충격의 크기 자체가 변한다고 보고 청산 전략을 다시 유도했고, 1804.09151은 가격충격이 있으면 투자 자체가 제약되고 헤징 비용이 달라진다고 분석했다.
이 테마의 공통 인사이트
가격충격은 '거래 비용'의 문제가 아니라 '최적화의 변수'다. 내 행동이 시장을 움직인다는 사실을 상태로 넣을 때, 비로소 실행 가능한 규칙이 나온다.
테마 2. 강화학습 트레이딩 — 기계 마켓메이커의 "기초 체력"
비유부터: 시장의 키오스크를 지키는 알바생
마켓메이커는 식당 앞 키오스크처럼 양쪽 호가를 끊임없이 제시해 사람들의 거래를 돕고, 그 대가로 스프레드를 남긴다. 문제는 재고다. 사자 호가가 계속 체결되면 주식이 쌓이고, 그 주식이 폭락하면 스프레드로 번 게 한꺼번에 날아간다. 좋은 마켓메이커는 "재고를 0 부근에 유지하면서" 스프레드를 꾸준히 수확해야 한다. 이 균형 감각을 강화학습(보상을 받으며 스스로 전략을 학습하는 AI)에게 어떻게 가르칠까?
대표 논문 깊게 보기: 강화학습 마켓메이커 (1804.04216)
리버풀 대학과 Stratagem Technologies의 연구팀이 세계적인 에이전트 학회 AAMAS 2018에 낸 이 논문은, 과거 연구의 "시간차 강화학습은 시장조성에 안 통한다"는 결론을 뒤집은 작업이다. 세 가지가 핵심이다.
- 가짜 시장이 아니라 진짜 주문장을 되살렸다. 2010년 1~8월 8개월치, 유럽 주식 10종목(은행·제약·통신 등)의 주문장 깊이와 체결 데이터로 시뮬레이터를 직접 재구성했다. 에이전트는 실제와 똑같은 5단계 호가창 앞에서 자기 주문을 관리한다.
- 보상 함수를 '재고에 예민하게' 만들었다. 재고가 쌓일수록 평가손익의 인정을 깎아 주는 비대칭 감쇄 보상. 쉽게 말해 "재고를 잔뜩 안고 버틴 수익은 수익으로 안 쳐 준다"는 규칙이다. 이러면 에이전트는 투기를 포기하고 재고를 털며 스프레드를 벌 방법을 찾는다.
- 학습 안정화에 공을 들였다. 자격 추적(지난 행동의 공과를 나중에 돌려주는 장치)과 타일 코딩이라는 고전적이지만 탄탄한 함수 근사의 조합으로, 과거 연구가 실패한 지점을 해결했다.
성과는 숫자로 확인된다. 이 논문은 "정규화 일일 손익(하루 이익을 평균 스프레드로 나눈 값 — 스프레드를 몇 번 잡았는지)"으로 매긴다.
| 종목 | 기존 온라인 학습 벤치마크 | 고정 호가 전략 | 이 논문의 통합 RL 에이전트 |
|---|---|---|---|
| HSBA.L (은행) | 1.66 (표준편차 22.48) | 2.80 (10.30) | 15.43 (13.01) |
| GSK.L (제약) | −3.36 (13.75) | 0.95 (2.86) | 7.32 (7.23) |
| SAN.MC (은행) | −2.53 (26.51) | 1.52 (11.64) | 5.67 (13.41) |
더 흥미로운 건 손익이 아니라 재고다. HSBA.L에서 이 에이전트의 평균 절대 보유량은 104주에 불과한 반면, 고정 호가 전략은 2,678주, 기존 벤치마크는 7,330주를 들고 있었다.
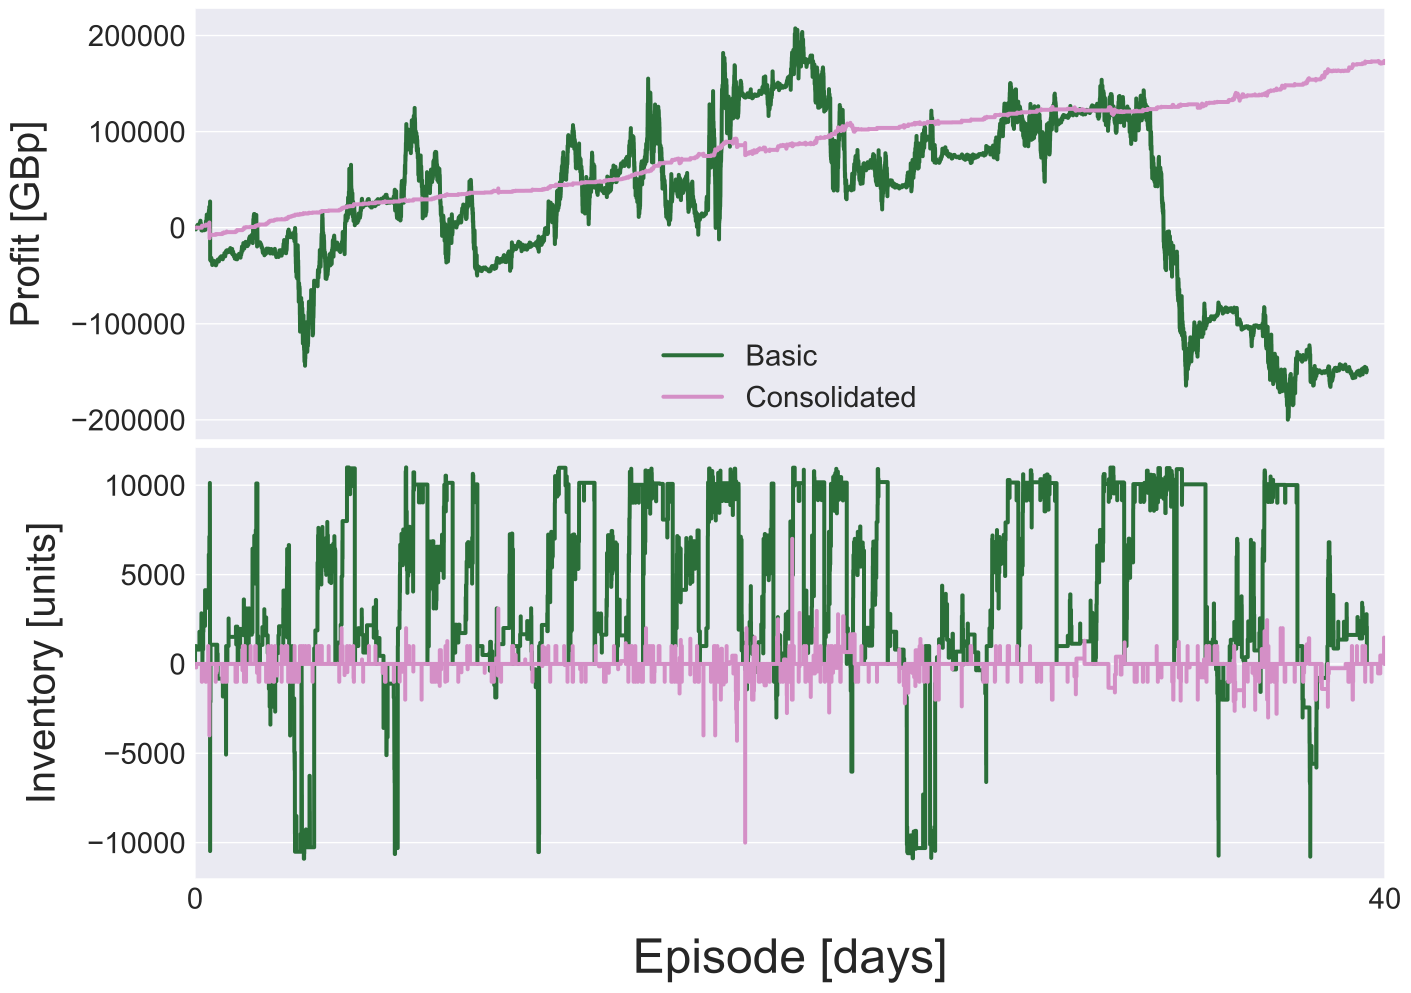
정직한 주의사항도 있다. 10종목 중 7종목에서 이겼지만 두 종목에서는 손실이었고, 시뮬레이터가 과거 데이터 재구성이라 "내 주문이 시장을 밀리는" 효과는 반영되지 않았다. 취소 주문이 큐에서 어디에 있는지도 단순하게 가정했다. 그래도 이 논문의 가장 값진 결론은 오히려 "범용적"이다 — 강화학습 트레이딩의 성패는 알고리즘보다 시뮬레이터의 충실도와 보상·상태 설계가 결정한다. 재현을 위해 코드도 공개했다(이 시기 논문으로는 드문 일이다).
같은 테마의 1804.05950은 보상이 "상태-행동-다음 상태"에서 오는 일반적인 경우에, 위험에 민감한 목표를 다루려면 상태를 어떻게 보강해야 하는지를 다룬 이론 논문이다 — "보상 설계가 잘못되면 에이전트가 엉뚱한 것을 배운다"는 문제의식이 같다.
이 테마의 공통 인사이트
에이전트를 바꾸기 전에 세계를 바꿔라. 이 논문들은 "더 똑똑한 알고리즘"이 아니라 "더 정직한 시뮬레이터, 더 정교한 보상"이 성과를 만든다고 말한다.
테마 3. 포트폴리오 최적화 — 데이터가 적어도 안 흔들리는 계산
비유부터: 재료가 부족한데 레시피대로 하라니
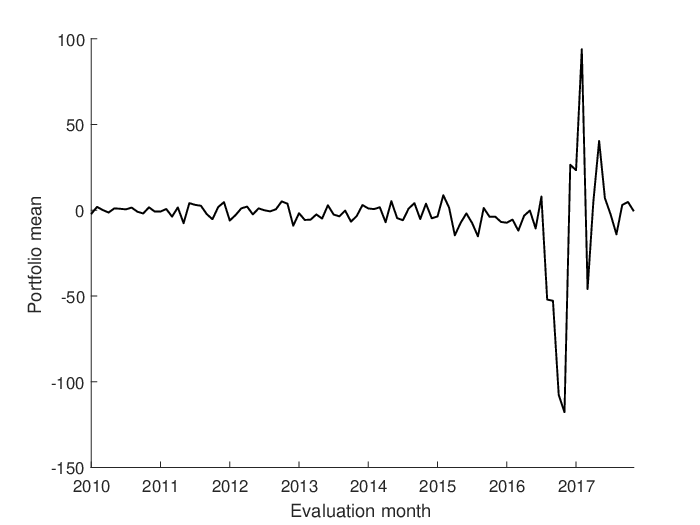
포트폴리오를 짤 때 필요한 재료는 "자산들 사이의 관계(공분산)"다. 그런데 자산 100개의 관계를 구하려면 몇 년치 데이터가 필요하고, 실제는 자산 수보다 표본이 적은 경우가 허다하다. 이때 전통적 계산은 "재료가 부족한데 레시피대로 하라"는 꼴이 되어, 자산 비중이 폭발적으로 흔들린다. 아래 그림이 그 전형이다.
대표 논문 깊게 보기: 포트폴리오 가중치를 기계학습으로 추정하기 (1804.01764)
노르웨이 BI 경영대학원의 Daniel Kinn이 쓴 이 논문의 아이디어는 한 문장으로 요약된다. "포트폴리오 가중치 구하기를, 회귀 문제로 바꿔 버리자."
자산들의 수익률로 "항상 똑같은 값(상수)"을 예측하는 회귀를 세우면, 회귀 계수가 곧 포트폴리오 가중치가 된다. 쉽게 말해 "정답이 항상 1점짜리인 시험에서 각 자산에게 몇 점씩 배분할지 학습하는" 셈이다. 이렇게 바꾸면 릿지, 라쏘, 주성분 회귀처럼 이미 검증된 기계학습 도구를 그대로 포트폴리오 엔진으로 쓸 수 있다.
핵심은 '자동 방어 장치'다. 이 방법들은 교차검증(데이터를 쪼개어 검증)으로 페널티 강도를 자동으로 정한다. 데이터가 적으면 페널티를 세게 걸어 자산 비중을 억누르고, 데이터가 많아지면 페널티를 풀어 전통적 계산에 자연스럽게 수렴한다. "무조건 비중을 줄여라"가 아니라 "불확실할수록 베팅을 줄여라"인 것이다.
성과는 두 갈래로 확인됐다. 먼저 시뮬레이션(미국 S&P500 데이터로 현실적인 모집단을 만들고 100번 반복 표본 추출):
| 상황 | 전통적 방법 | 기계학습(릿지) | 모집단 이상값 |
|---|---|---|---|
| 자산 10개, 표본 20개월 | 샤프 0.25 | 0.39 | 0.62 |
| 자산 50개, 표본 120개월 | 1.31 | 1.50 | 2.05 |
| 자산 50개, 표본 20개월 | 계산 불가 | 0.51 | 2.05 |
(샤프 비율 = 위험 1단위당 수익. 높을수록 좋다.)
그리고 실제 데이터 6종 — 미국 주식 20·50·500종목, 산업 포트폴리오 30·49개, 그리고 2017년 말 기준 시가총액 상위 암호화폐 200종(추정 기간은 단 10개월!) — 에서 롤링 표본 외 검증을 했다. 미국 주식 20종목에서는 전통적 방법이 샤프 −0.10으로 손실을 본 반면 기계학습은 0.25 안팎이었고, 암호화폐처럼 "데이터는 적은데 자산은 많은" 극단적 상황에서도 기계학습이 무너지지 않았다.
가장 인상적인 장면은 위기 구간에서 나온다. 표본 말미에 시장이 크게 흔들렸을 때 전통적 계산은 극단적 비중으로 폭주한 반면, 라쏘는 모든 자산의 비중을 0으로 두고 "지금은 투자하지 않는 것"을 스스로 선택했다. 데이터가 불안정하면 아예 베팅을 멈추는, 설계된 대로 작동하는 안전 장치다.
한계와 함께 볼 논문들
복잡한 방법이 항상 이기지는 않았다. 산업 포트폴리오와 암호화폐에서는 "모든 자산에 똑같이" 투자하는 단순한 등가중 전략이 오히려 좋았고, 그 차이는 통계적으로 유의미하지 않았다. 기준 전략(등가중)을 이기지 못하는 복잡함은 무의미하다는 교훈. 논문 자체도 선형 모델에 한정되고 공개 코드가 없으며(재현성 35), 라쏘의 "0-투자" 선택은 설명력이 아니라 방어 전술이라는 점을 감안해야 한다.
같은 테마의 다른 논문들도 같은 정신이다. 1804.05454는 수익률 분포를 가정하지 않고도 포트폴리오의 최악 상황을 더 타이트하게 상계하는 확률 부등식을, 1804.03002는 변동성이 빠르게 요동치는 '거친' 환경에서의 근사 최적 전략을, 1804.08442는 시장 분위기가 바뀌는 국면전환 상황의 명시적 해를 다룬다.
이 테마의 공통 인사이트
좋은 포트폴리오는 "더 정확한 예측"이 아니라 "추정이 틀려도 무너지지 않는 구조"에서 나온다. 데이터가 적을 때 스스로 베팅을 줄이는 계산이, 데이터가 많을 때 앞서는 계산이다.
테마 4. 팩터 모델과 예측 — "요인은 몇 개인가"에 대한 새 답변
비유부터: 모든 학생에게 같은 과외 과목을 시키면
주식 수익률을 설명하는 '요인(팩터)' — 시장 전체의 움직임, 대형주 대비 소형주, 저평가 대비 고평가 같은 공통 힘 — 을 찾는 연구는 반세기 역사가 있다. 전통 모형은 "요인은 몇 개면 충분하다"고 전제한다. 하지만 요인이 늘어나면서 문제가 생겼다. 모든 종목에 똑같은 소수 요인을 적용하니, 실제로는 서로 다른 힘에 반응하는 종목들이 뭉뚱그려지는 것이다. 비유하면 학생마다 약한 과목이 다른데 모두에게 같은 과외 시간표를 짜는 격이다.
대표 논문 깊게 보기: 적응형 다요인 모형과 GIBS 알고리즘 (1804.08472)
코넬 대학(통계학과·경영대학원)과 Kamakura Corporation의 연구팀(Liao Zhu, Sumanta Basu, Robert Jarrow, Martin T. Wells)이 제안한 이 모형의 이름은 적응형 다요인(Adaptive Multi-Factor, AMF) 모형. 절차는 이렇다.
- 후보 재료를 ETF로 모은다. 시중의 ETF는 이미 "섹터·스타일별 힘"을 담고 있다. ETF들을 자산 클래스별로 묶고, 서로 중복되지 않는 대표 ETF들만 뽑아 '기초 자산(베이지 에셋)' 후보군을 만든다.
- 종목마다 필요한 요인만 고른다. 라쏘라는 희소 회귀 기법으로, 각 종목을 설명하는 데 실제로 필요한 소수의 기초 자산만 선택한다.
- 선택이 진짜인지 검증한다. 다시 일반 회귀로 유의성을 확인하고, 5,000개 종목을 대량 검정할 때 생기는 '거짓 발견'까지 통계적으로 통제한다.
결과는 뚜렷했다. 종목당 평균 3.4개 요인만 선택됐고(기존의 흔한 방식은 13.4개를 골라 과적합했다), 이렇게 만든 모형의 설명력은 수정 R² 0.348로 파마-프렌치 5요인(0.234)보다 49% 높았다. 다음 주를 예측하는 표본 외 R²도 0.331 대 0.209로 58% 앞섰다.
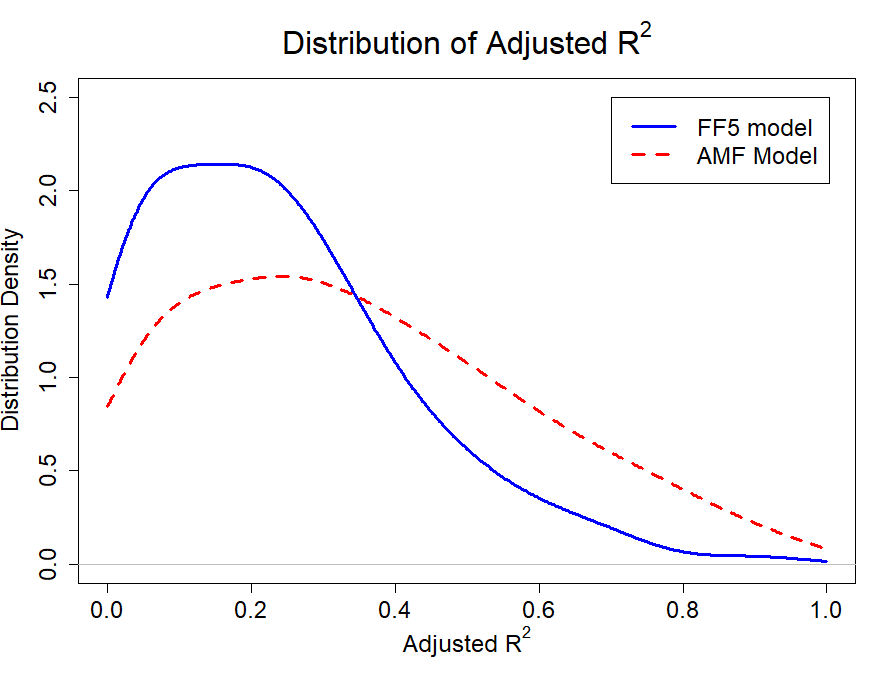
그런데 이 논문의 진짜 보물은 부록 같은 검증들이다.
- 알파(초과수익)의 대부분은 착시였다. 파마-프렌치 모형에서는 종목의 6.33%가 "설명되지 않는 수익(알파)"을 보였지만, 대량 검정의 거짓발견률을 보정하자 사실상 전부가 통계적 착시로 판명됐다. 알파가 큰 종목을 사고 작은 종목을 파는 '무투자 롱숏 전략'을 2017년 데이터로 돌려 보니 손익이 0을 오갈 뿐이었다.
- 이 결과는 역설적이지만 이 모형의 강점이다. "설명력이 높아졌는데 알파는 없다"는 말은, 남은 수익률이 진짜 위험의 대가로 정직하게 설명된다는 뜻이다.
한계와 함께 볼 논문들
주간 수익률 기준의 "느린 시계" 모형이라 단기 매매에는 그대로 못 쓰고, 후보 ETF를 어떤 걸 쓰느냐에 결과가 달려 있다. 그리고 설명력 0.35는 "아직 3분의 2가 미스터리"라는 뜻이기도 하다. R²가 올랐다고 알파가 생기지는 않는다.
같은 테마의 1804.09314는 딥러닝(ReLU, LSTM)으로 기존의 선형·덧셈 구조를 넘는 비선형 팩터를 학습했고, 1804.03811은 주식들 사이의 관계 그물이 시간에 따라 어떻게 변하는지 추적해 위기 때 연결 구조가 확대되는 모습을 포착했다.
이 테마의 공통 인사이트
요인을 고르는 일과 요인으로 예측하는 일을 같은 통계 틀에서 다뤄야 한다. 그리고 수천 번의 검정에서 나온 '헀다'는 결과는, 검정을 통제하지 않으면 대부분 거짓말이다.
테마 5. 파생상품과 변동성 표면 — "무차익"을 지키며 빠르게
비유부터: 지도를 그리는 제약
옵션 시장에는 만기와 행사가격마다 '내재변동성'이라는 값이 있고, 이 값들이 모여 하나의 표면(지도)을 이룬다. 문제는 이 지도가 시장의 기본 법칙 — "무차익" — 을 어기면 안 된다는 것이다. 지도의 곡선이 서로 겹치거나 뒤집히면, 그 틈으로 돈이 공짜로 벌리는 구멍(차익)이 생긴다. 그런데 시장 데이터는 소음이 섞여 있어 그대로 이으면 법칙을 어기기가 일쑤다. 법칙을 어기지 않으면서, 시장 데이터를 빠르고 안정적으로 지도에 옮기는 법은 무엇인가?
대표 논문 깊게 보기: SSVI 변동성 표면의 강건한 보정 (1804.04924)
파리의 금융 소프트웨어 회사 Zeliade Systems의 연구팀(Jacopo Corbetta 외 3인)이 쓴 이 논문은 실무 감각이 물씬 흐르는 작업이다. 만기별로 SSVI라는 3파라미터 곡선(평균 변동성, 상관, 곡률)을 쓰되:
- 각 만기에서 '선물가와 가장 가까운 관측점'을 정확히 지나도록 못 박고, 나머지 두 개만 조정한다. 자유도를 줄여 보정이 요동치지 않게 하는 트릭이다.
- 무차익 조건을 계산해서 지킨다. 버터플라이 차익(행사가 방향의 구멍)과 캘린더 스프레드 차익(만기 방향의 구멍)이 생기지 않도록 후보를 걸러, 앞뒤 만기가 서로 겹치지 않게 배치한다.
- 이렇게 얻은 만기별 파라미터를 그냥 이어 붙여도(보간·외삽) 무차익이 유지됨이 증명됐다. 이 성질 덕분에 표면 전체를 저장하고 재사용하기가 쉬워진다.
성과는 실전 수준이다. 2018년 1월 8일의 SPX(미국 대표 지수 옵션) 종가 데이터, 만기 12개에 만기당 평균 98개 옵션을 맞춘 결과, 평균 가격 오차가 선물가의 4 베이시스포인트(0.04%) 미만이었고 대부분의 적합이 매수-매도 호가 차이 안에 들어왔다. 계산 시간은 Python 구현으로 1.2초 — 프로덕션에 바로 넣을 수 있는 속도다.
한계도 명시적이다. 호가가 아주 좁게 붙는 전문 마켓메이킹 상황에서는 적합도가 모자랄 수 있고, 보정의 출발점이 되는 관측점이 이상치면 전체가 흔들린다. 검증 데이터 대부분이 회사 내부라 공개 재현은 SPX 예시에 한정된다(재현성 43).
같은 테마의 계산 기술들은 각자 다른 구멍을 메운다. 1804.07556은 예정된 공시처럼 "시점을 알고 있는 점프"까지 포함하는 금융모형의 수학적 토대를, 1804.03975는 장벽옵션의 그릭(민감도)을 유한차분 없이 안정적으로 뽑는 몬테카를로 기법을 제안했다.
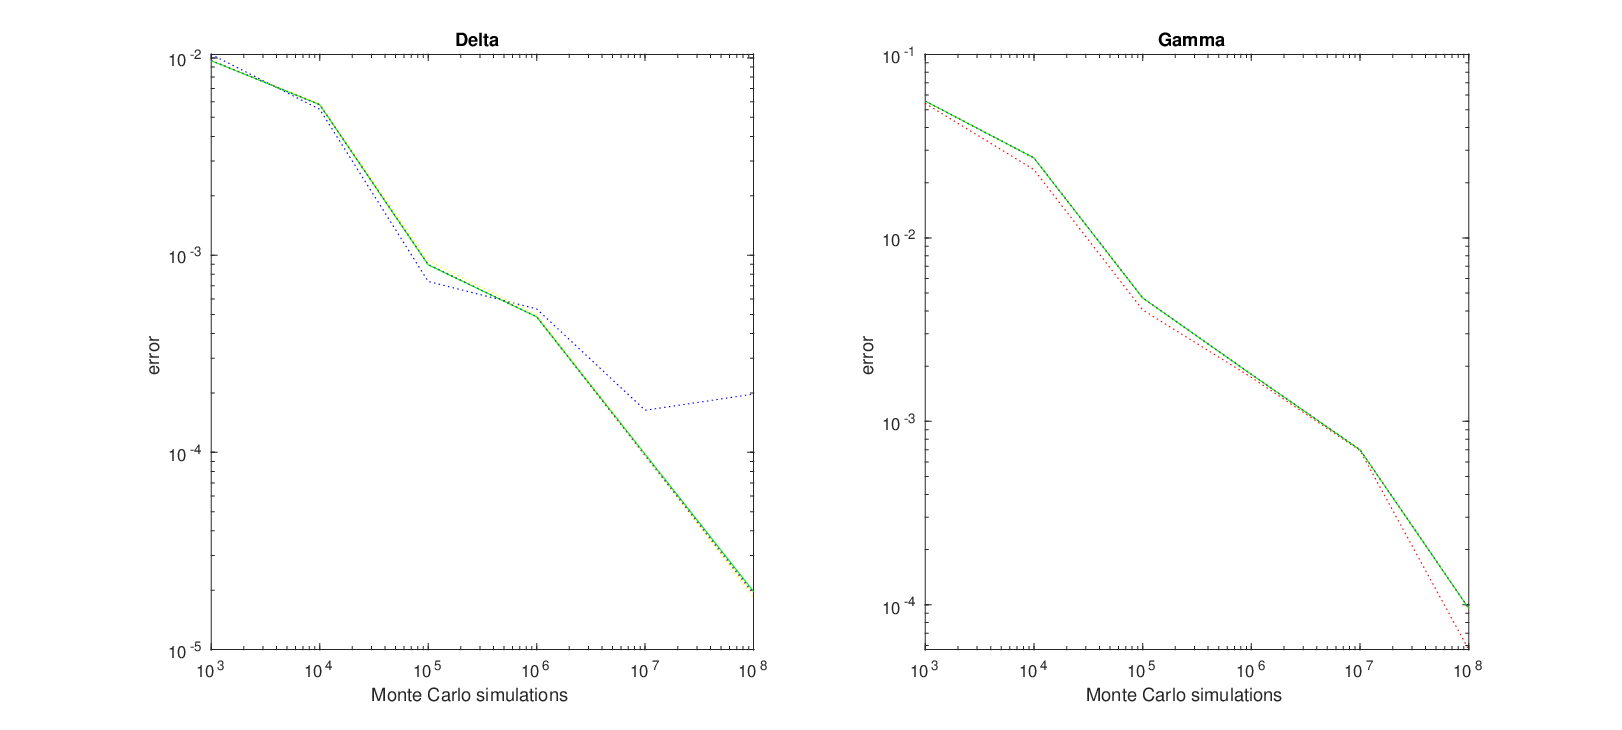
그 밖에 1804.10753(비선형 시장의 미국형 옵션 가격), 1804.07852(움직이는 장벽의 해석적 가격), 1804.07534(점프확산 모형의 고차 정밀 수치해법), 1804.02289(거래 상대방 부도 위험을 반영한 가격, 이른바 CVA)가 있다.
이 테마의 공통 인사이트
파생 가격결정의 진보는 "더 복잡한 모형"이 아니라 "법칙을 지키며 더 빠르게"다. 무차익이라는 제약을 계산 과정에 처음부터 박아 두는 설계가, 실무에서 이긴다.
월 전체 정리: "마찰을 지우지 말고, 계산 안으로 들이자"
2018년 4월의 다섯 테마를 관통하는 메시지는 하나다 — 현실의 마찰을 모형 밖으로 밀어내지 말고, 계산 안으로 정식으로 들이라는 것. 내 매매가 가격을 밀어내는 힘은 최적 투자의 상태 변수가 되고(테마 1), 재고가 쌓이는 위험은 강화학습의 보상 함수가 되며(테마 2), 추정이 틀릴 확률은 포트폴리오의 자동 감속 장치가 되고(테마 3), 수천 번 검정에서 생기는 거짓 알파는 통제 대상이 되고(테마 4), 무차익이라는 시장의 법은 계산의 제약 조건이 된다(테마 5).
또 하나 눈에 띄는 점은, 이 달의 이론 논문들이 전부 실증 표를 붙이고 있다는 것이다. 770만 건의 메타오더, 10종목 8개월치 주문장, 6개 데이터셋의 표본 외 검증, 4,881종목의 F검정, SPX 옵션의 4 베이시스포인트 오차 — 전부 "증명 끝"이 아니라 "표본 외 확인"에서 멈춘다. 2017년 비트코인 거품의 직후라서일까, 이 달에는 비트코인의 버블 해부(1804.06261), 시장 성숙도(1804.05916), 변동성 계량분석(1804.07978)이 한꺼번에 쏟아져 나왔다 — 새 자산군을 기존 도구로 검증하려는 움직임도 같은 정신이다.
기계학습이 금융의 유행어가 되기 직전, "도구에 먹이는 데이터와 계산이 견디는 조건"부터 묻던 시기의 기록. 2026년의 눈으로 다시 보아도, 오늘날의 실행 알고리즘, 강화학습 트레이딩, 위험 기반 포지션 사이징 연구의 씨앗이 이 달에 이미 심겨 있음을 알 수 있다.
더 알아보기
이 글에서 깊게 다룬 논문들의 원문 링크와 점수(KB 5차원 평가, 참고용)다.
테마 1 — 가격충격과 최적 청산
- 1804.07392 Optimal investment with transient price impact — 새로움 78 · 적용성 63 · 엄밀성 84 · 재현성 42 · 통찰 76
- 관련 논문: Portfolio liquidation under transient price impact (1912.06426), On Parametric Optimal Execution and Machine Learning Surrogates (2204.08581)
테마 2 — 강화학습 마켓메이커
- 1804.04216 Market Making via Reinforcement Learning — 새로움 66 · 적용성 68 · 엄밀성 62 · 재현성 74 · 통찰 70
- 관련 논문: Optimal Market Making by Reinforcement Learning (2104.04036), Robust Market Making via Adversarial Reinforcement Learning (2003.01820)
테마 3 — 포트폴리오 추정 위험
- 1804.01764 Reducing Estimation Risk in Mean-Variance Portfolios with Machine Learning — 새로움 68 · 적용성 75 · 엄밀성 72 · 재현성 35 · 통찰 72
- 관련 논문: Machine Learning and Factor-Based Portfolio Optimization (2107.13866), Two is better than one: Regularized shrinkage of large minimum variance portfolios (2202.06666)
테마 4 — 적응형 다요인 팩터
- 1804.08472 High-Dimensional Estimation, Basis Assets, and the Adaptive Multi-Factor Model — 새로움 70 · 적용성 66 · 엄밀성 64 · 재현성 72 · 통찰 68
- 관련 논문: Deep Learning in Asset Pricing (1904.00745), The Low-volatility Anomaly and the Adaptive Multi-Factor Model (2003.08302)
테마 5 — 변동성 표면과 파생 가격결정
- 1804.04924 Robust calibration and arbitrage-free interpolation of SSVI slices — 새로움 70 · 적용성 77 · 엄밀성 77 · 재현성 43 · 통찰 68
- 관련 논문: No arbitrage SVI (2005.03340), Deep Smoothing of the Implied Volatility Surface (1906.05065)
📚 이 글에서 다룬 논문 (40편)
- A
- AMarket Making via Reinforcement Learning
Thomas Spooner, John Fearnley, Rahul Savani 외 1명
- ACo-impact: Crowding effects in institutional trading activity
Frédéric Bucci, Iacopo Mastromatteo, Zoltán Eisler 외 3명
- AHigh-Dimensional Estimation, Basis Assets, and the Adaptive Multi-Factor Model
Liao Zhu, Sumanta Basu, Robert A. Jarrow 외 1명
- A
- AAffine processes beyond stochastic continuity
Martin Keller-Ressel, Thorsten Schmidt, Robert Wardenga
- ARobust calibration and arbitrage-free interpolation of SSVI slices
Pierre Cohort, Jacopo Corbetta, Claude Martini 외 1명
- ADeep Learning for Predicting Asset Returns
Guanhao Feng, Jingyu He, Nicholas G. Polson
- BTransport plans with domain constraints
Erhan Bayraktar, Xin Zhang, Zhou Zhou
- BMonte Carlo pathwise sensitivities for barrier options
Thomas Gerstner, Bastian Harrach, Daniel Roth
- BOptimal liquidation under stochastic price impact
Weston Barger, Matthew Lorig
- BThe value of informational arbitrage
Huy N. Chau, Andrea Cosso, Claudio Fontana
- BDissection of Bitcoin's Multiscale Bubble History from January 2012 to February 2018
Jan-Christian Gerlach, Guilherme Demos, Didier Sornette
- BPortfolio Optimization under Fast Mean-reverting and Rough Fractional Stochastic Environment
Jean-Pierre Fouque, Ruimeng Hu
- BForex trading and Twitter: Spam, bots, and reputation manipulation
Igor Mozetič, Peter Gabrovšek, Petra Kralj Novak
- BOptimal Investment, Demand and Arbitrage under Price Impact
Michail Anthropelos, Scott Robertson, Konstantinos Spiliopoulos
- BArbitrage-free pricing of American options in nonlinear markets
Edward Kim, Tianyang Nie, Marek Rutkowski
- BAnalytical Path-Integral Pricing of Moving-Barrier Options under non-Gaussian Distributions
Andre Catalao, Rogerio Rosenfeld
- BFourth order compact scheme for option pricing under Merton and Kou jump-diffusion models
Kuldip Singh Patel, Mani Mehra
- BBitcoin market route to maturity? Evidence from return fluctuations, temporal correlations and multiscaling effects
Stanisław Drożdż, Robert Gębarowski, Ludovico Minati 외 2명
- Planetary boundaries of consumption growth: Declining social discount rates
Victor E. Gluzberg, Yuri A. Katz
- APortfolio liquidation under transient price impact -- theoretical solution and implementation with 100 NASDAQ stocks
Ying Chen, Ulrich Horst, Hoang Hai Tran
- SOn Parametric Optimal Execution and Machine Learning Surrogates
Tao Chen, Mike Ludkovski, Moritz Voß
- BOptimal Market Making by Reinforcement Learning
Matias Selser, Javier Kreiner, Manuel Maurette
- ARobust Market Making via Adversarial Reinforcement Learning
Thomas Spooner, Rahul Savani
- AMachine Learning and Factor-Based Portfolio Optimization
Thomas Conlon, John Cotter, Iason Kynigakis
- ATwo is better than one: Regularized shrinkage of large minimum variance portfolio
Taras Bodnar, Nestor Parolya, Erik Thorsén
- A
- AThe Low-volatility Anomaly and the Adaptive Multi-Factor Model
Robert A. Jarrow, Rinald Murataj, Martin T. Wells 외 1명
- A
- ADeep Smoothing of the Implied Volatility Surface
Damien Ackerer, Natasa Tagasovska, Thibault Vatter
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2026-08 월간
2026년 8월의 금융 AI 연구: 이론과 실전의 간극이 좁혀지는 달
2026년 8월 arXiv에 공개된 금융 AI 연구를 4개 테마로 정리했습니다. 포트폴리오 최적화의 실전화, LLM 에이전트 벤치마크 전쟁, 변동성 표면의 수학적 통일, 뉴스 NLP의 시간 누수 감사 — 이론이 실제로 작동하는 도구로 변하는 순간을 포착했습니다.
 📊 2026-07 월간
7월의 AI 투자 연구: 더 큰 모델이 정답이 아니다
2026년 7월 시스템 트레이딩 연구 동향. LLM 에이전트 비용 최적화, DEX 라우팅 $2,400만 손실 계량화, 추세추종의 주파수 영역 해석, 포트폴리오 분포 불확실성 강건 최적화, 시계열 부트스트랩 실용화.