
평균을 맞추는 건 그만, 이제 '틀렸을 때 얼마나 잃나'를 최적화하자 — 2020년 7월 AI 금융 연구 종합
2020년 7월 AI 금융 연구 종합
들어가며
주식을 사면 보통 이런 생각을 합니다: "이 종목이 오를까?" 수익률 평균을 맞추는 것이 투자의 핵심이라고 배워왔죠. 하지만2020년7월, COVID-19 이후의 불확실한 시장에서 arXiv에 올라온 연구들은 조금 다른 이야기를 하고 있습니다. 평균을 맞추는 것보다, 틀렸을 때 얼마나 잃는지를 직접 최적화하는 것이 더 중요하다고요.
이번 달167편의 논문 중85편이 관련 연구로 분류되었고, 그 중10편이 최상위 A등급을 받았습니다. 네 가지 연구 테마로 나눠서, 가장 흥미로운 발견들을 쉽게 풀어보겠습니다.
테마 1: 리스크를 직접 최적화하는 베이지안 방법
문제: 비싼 시뮬레이터 안에서 리스크를 찾으려면?
투자 전략을 개발할 때, 백테스트나 시뮬레이션은 매우 비쌉니다. 한 번 돌리는데 몇 분에서 몇 시간이 걸리죠. 이 비싼 시뮬레이터 안에서 "가장 리스크가 낮은 전략 파라미터"를 찾으려면 어떻게 해야 할까요?
기존의 베이지안 최적화(BO)는 시뮬레이터의 결과값을 가우시안 과정으로 모델링했습니다. 하지만 리스크 측도(VaR나 CVaR처럼 꼬리 위험을 잡는 지표)는 평균과 달리 비선형이고, 환경 조건(W)에 따라 크게 달라집니다. 결과값을 직접 모델링하면 표본 효율이 떨어집니다.
핵심 아이디어: 구조를 활용하라
Cakmak, Astudillo, Frazier, Zhou가 NeurIPS2020에 발표한 이 논문(arXiv:2007.05554)의 핵심은 간단하지만 강력합니다. 결과값 ρ[F(x,W)] 전체를 모델링하지 않고, 내부 함수 F(x,W) 자체를 가우시안 과정으로 모델링합니다. 여기서 ρ는 VaR나 CVaR 같은 리스크 측도, x는 전략 파라미터, W는 시장 환경 변수입니다.
이게 왜 중요하냐면, F를 따로 모델링하면 의사결정 변수 x와 환경 변수 W를 동시에 탐색할 수 있습니다. 기존 연구는 x만 최적화하고 W를 무작위로 샘플링했지만, 이 방법은 "어떤 환경에서 이 전략이 가장 위험한지"를 능동적으로 찾아냅니다.
새로운 획득함수인 ρKG(리스크 지식 경사)는 "다음 관찰이 리스크를 얼마나 개선시킬까"를 한 단계 베이즈 최적으로 계산합니다. 근사형인 ρKG_apx는 속도를 높이면서도 성능 저하가 거의 없습니다.
무엇을 알아냈나
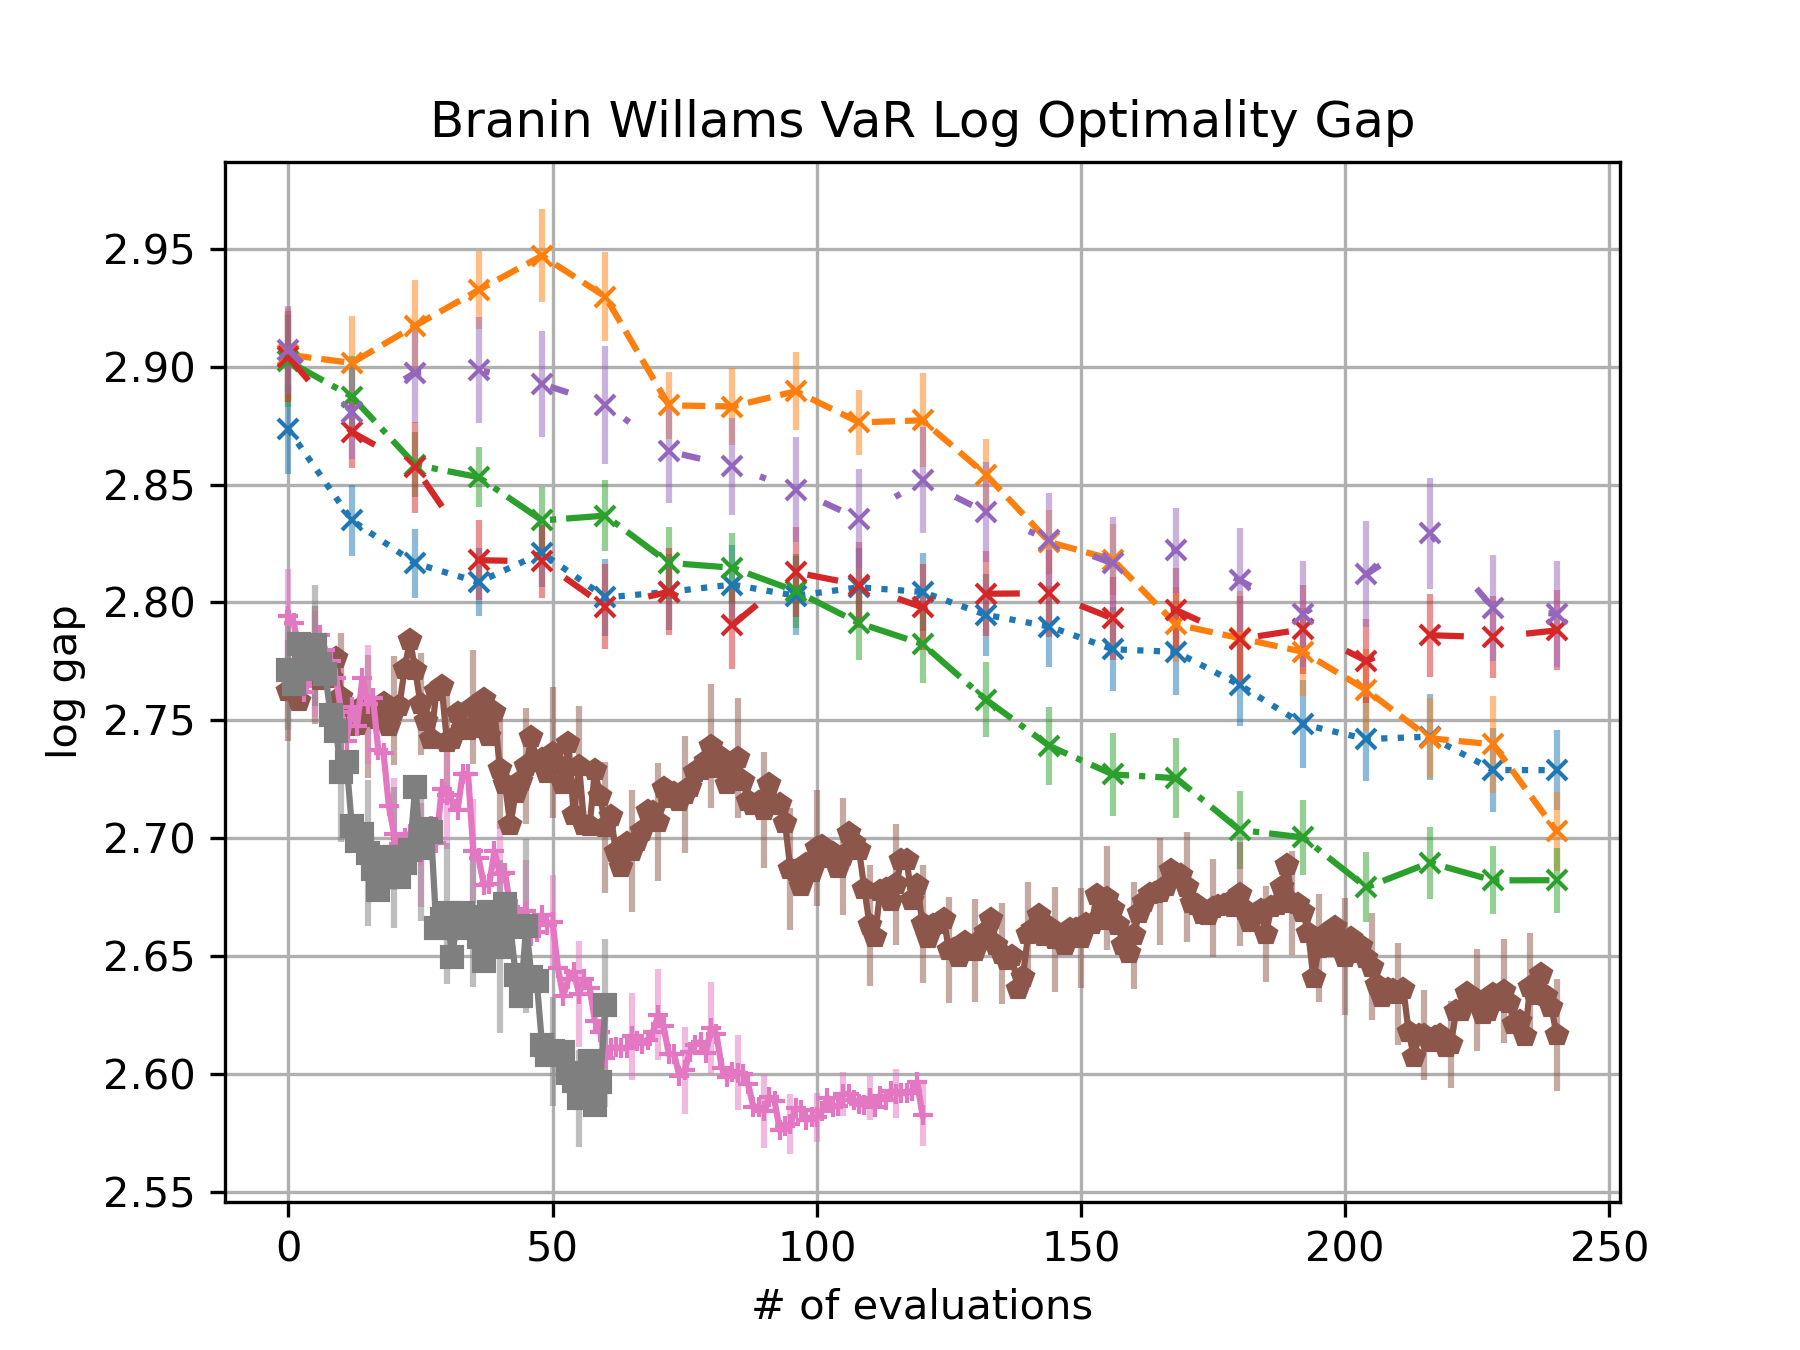
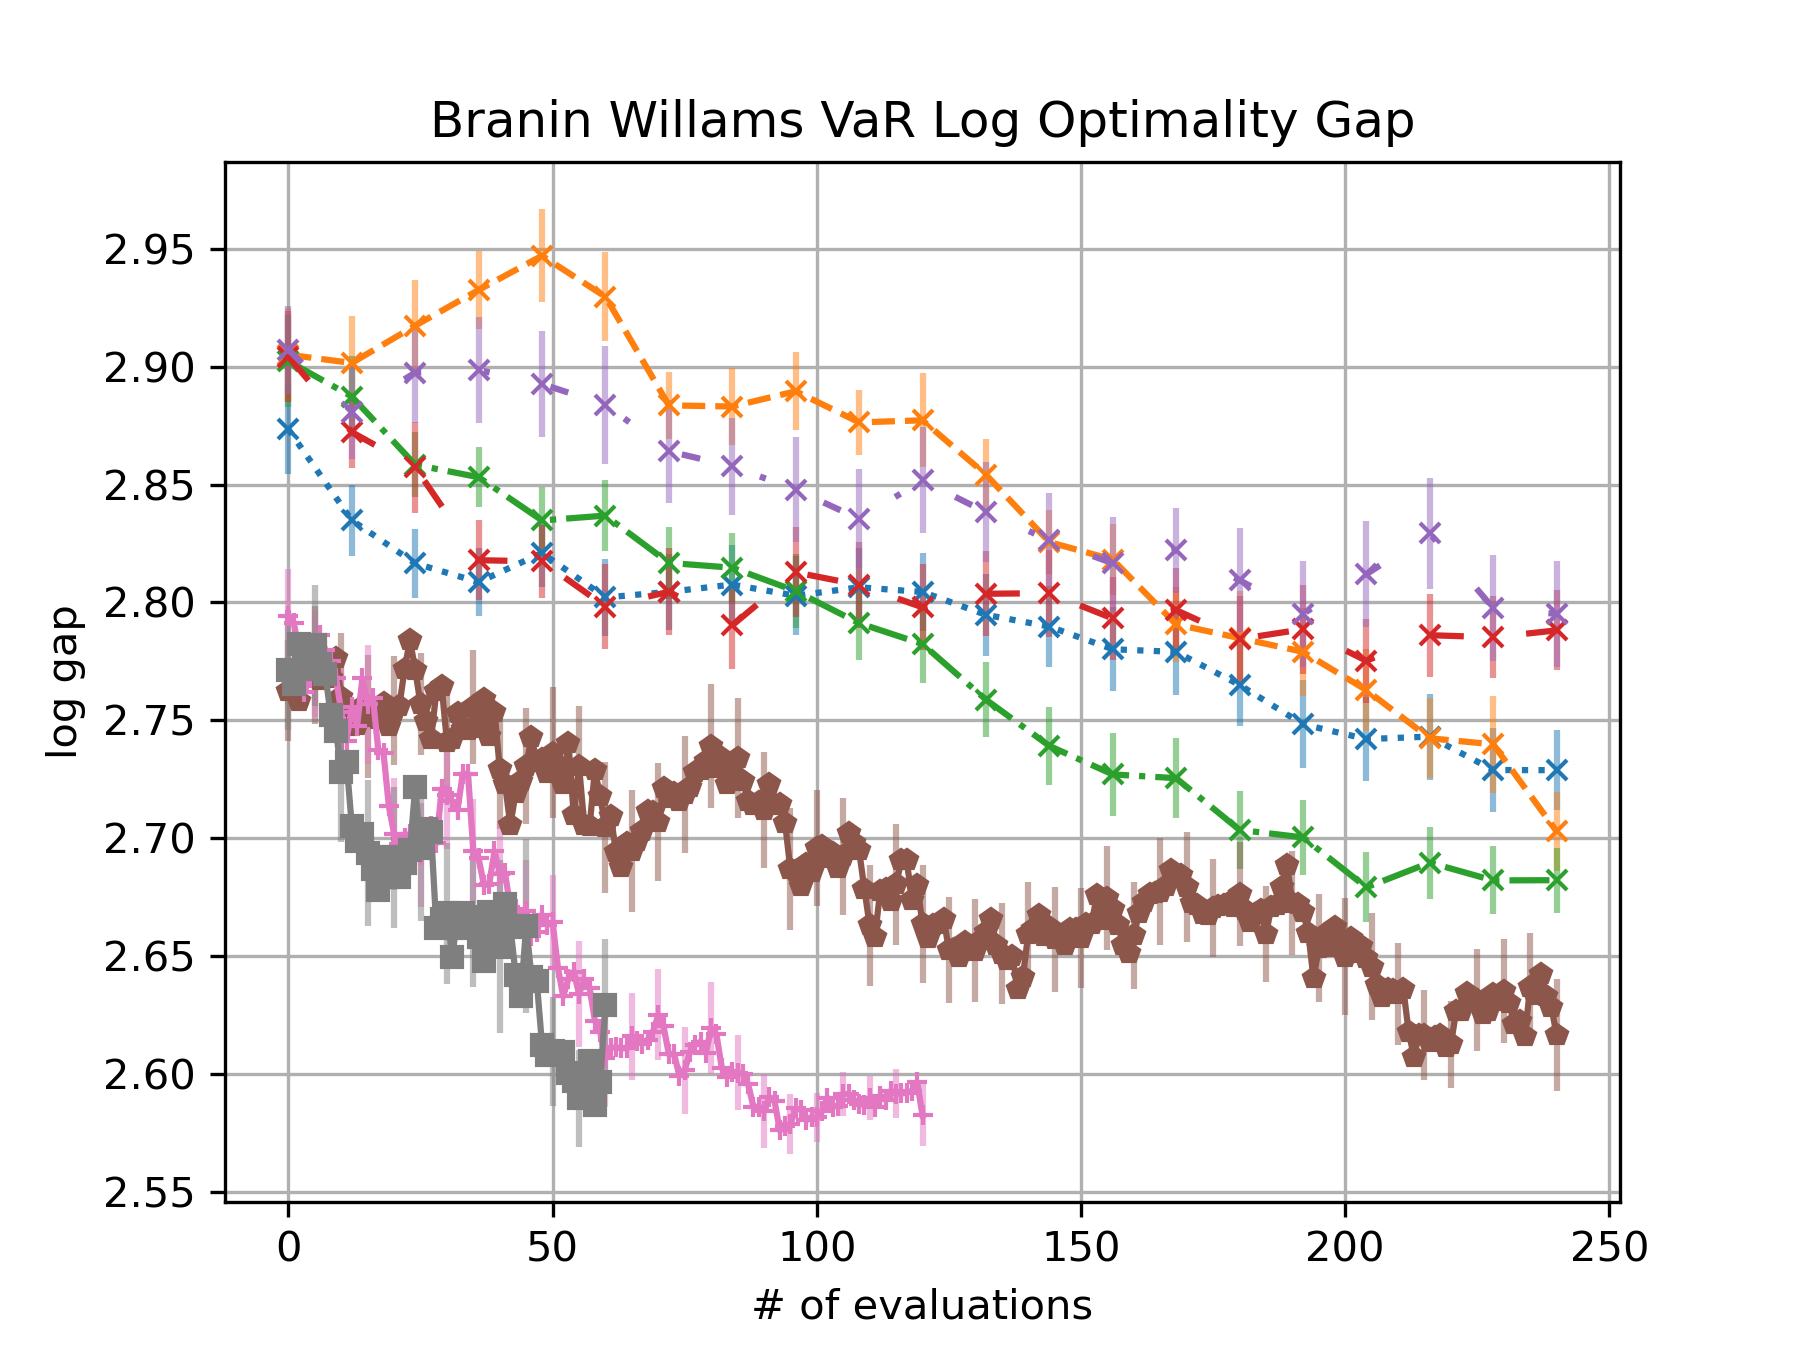
실험 결과, ρKG/ρKG_apx는 기존 방법 대비 평가 횟수의 절반 이하로 같은 수준의 최적해를 찾았습니다. Branin-Williams, 포트폴리오, COVID-19 검사 배분 등 다양한 문제에서 일관된 우위를 보였죠.
가장 실용적인 발견은 (x,W) 공동 최적화입니다. 전략 파라미터를 바꿔가며 "어떤 시장 환경에서 이 전략이 가장 큰 손실을 보는지"를 동시에 찾을 수 있다는 뜻입니다. 이건 스트레스 테스트를 자동화하는 것과 같습니다.
한계와 주의점
계산 복잡도가 관측치 수에 따라 O(n³)으로 늘어나므로, 매우 큰 데이터셋에는 부담입니다. 또한 시뮬레이터 자체에 편향이 있으면 해도 편향됩니다. 코드는 GitHub(BoTorch 기반)에서 공개되어 있습니다.
그래서 투자/실무엔?
전략 하이퍼파라미터(예: 손절매 비율, 포지션 크기)와 스트레스 시나리오를 함께 최적화하는 프레임워크로 바로 활용할 수 있습니다. "평균 수익률을 높이는 파라미터"가 아니라 "CVaR(꼬리 위험)을 낮추는 파라미터"를 직접 찾는다는 점이 핵심입니다.
테마 2: 딥러닝으로 옵션 가격면을 배우되, 무차익은 지켜라
문제: 신경망은 유연하지만, 금융 법칙을 어길 수 있다
옵션 가격면을 보간(interpolation)하는 데 딥러닝이 뛰어나다는 건 이미 알려진 사실입니다. 하지만 대부분의 딥러닝 접근법은 무차익 조건을 강제하지 않습니다. 쉽게 말해, 신경망이 만들어낸 가격면에 "돈이 공중에서 생기는" 조합이 숨어 있을 수 있다는 거죠. 이건 실무에서 절대 쓸 수 없습니다.
핵심 아이디어: Dupire 공식을 손실 함수에 넣어라
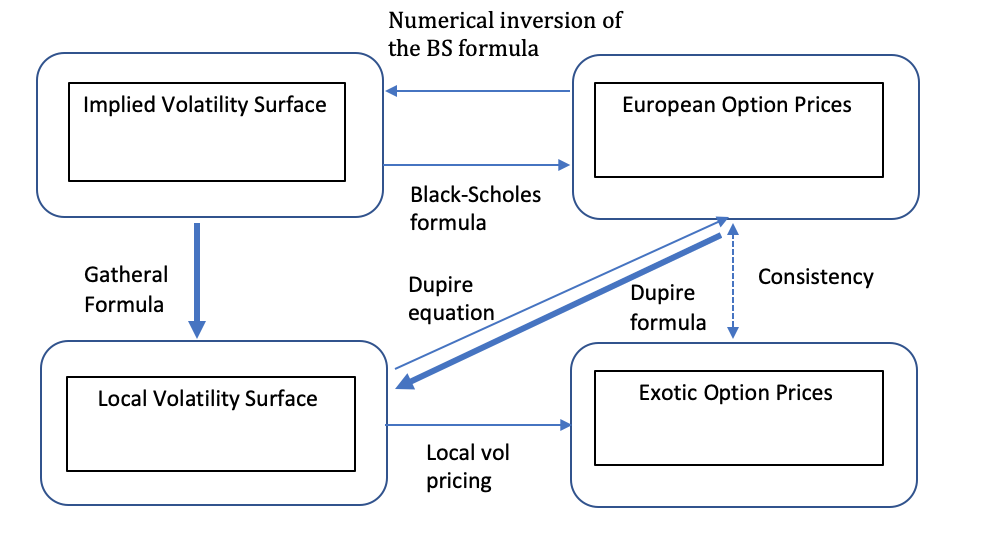
이 논문(arXiv:2007.10462)은 유러피안 바닐라 옵션 가격 P(T,K)를 신경망으로 보간하면서, Dupire 공식을 통해 국소변동성면 σ²(T,K)을 동시에 추정합니다. 두 가지 제약 방식을 비교합니다:
- 경제적 제약(희소 네트워크): 신경망 구조 자체로 무차익을 보장하지만, 표현력이 떨어져서 RMSE가 약28로 치솟습니다
- 소프트 제약(조밀 네트워크): 손실 함수에 패널티항을 추가. 캘린더 스프레드, 버터플라이, 그리고 Dupire 국소변동성 범위까지 제약
무엇을 알아냈나
DAX 바닐라 옵션(2001년8월) 데이터로 검증한 결과:
- 소프트 제약+Dupire 페널티: 테스트 RMSE3.36, 차익 위반 0건
- 제약 없음: 테스트 RMSE3.77, 차익 위반44건
- 경제적 제약: 차익 위반0건이지만 RMSE28.91 (실용 불가)
핵심은 "소프트 제약+Dupire" 조합이 차익을 제거하면서도 가격 정확도를 거의 유지한다는 점입니다. 경제적 제약은 이론적으로 완벽하지만 수치적으로 너무 비쌉니다.
한계와 주의점
소프트 제약만으로는 산발적 차익 위반을 완전히 제거하기 어렵습니다. 데이터도 DAX3일치밖에 없어 일반화를 확인하려면 더 많은 검증이 필요합니다.
그래서 투자/실무엔?
학습이 끝나면 신경망이 전체 가격면과 국소변동성면을 즉시 산출합니다. 실시간 옵션 가격 보간, 이색옵션 평가, 리스크 산출용 국소변동성 캘리브레이션에 바로 쓸 수 있습니다. 무차익 위반이0건이라는 건 실무에서 신뢰할 수 있다는 뜻입니다.
테마 3: 강화학습으로 헤지하되, 하방 위험을 제약으로 걸어라
문제: 강화학습은 보상만 좇다가 큰 손실을 볼 수 있다
강화학습으로 포트폴리오를 관리하거나 옵션을 헤지할 때, 에이전트는 "평균 보상"을 최대화하려고 합니다. 하지만 금융에서는 평균이 좋아도 한 번의 큰 손실이 치명적입니다. "평균적으로 잘하지만 가끔 크게 잃는" 정책은 실제로는 위험합니다.
핵심 아이디어: 하방 부분모멘트를 Bellman 방정식으로 바꿔라
Spooner와 Savani의 이 논문(arXiv:2007.04203)은 하방 부분모멘트(LPM)를 리스크 측도로 사용합니다. LPM은 "기준 수익률 미달의 크기"만 세는 지표로, 상승 변동성은 무시하고 하락만 잡습니다.
기존 연구들은 LPM을 직접 추정(몬테카를로)했는데, 분산이 매우 높아 표본 효율이 나빴습니다. 이 논문은 LPM을 TD 학습 가능한 수축 Bellman 프록시로 변환합니다. 변환 g(r) = (τ_R - r)₊ 에서 분산이 원래 보상보다 작다는 것도 증명했습니다(보조정리2).
NRCPO 알고리즘은 이 프록시를 제약으로 사용하면서 자연 정책 경사로 업데이트합니다. 쉽게 말해, "수익을 높이되 하방 위험은 이 선을 넘지 마라"는 제약을 걸고 학습하는 겁니다.
무엇을 알아냈나
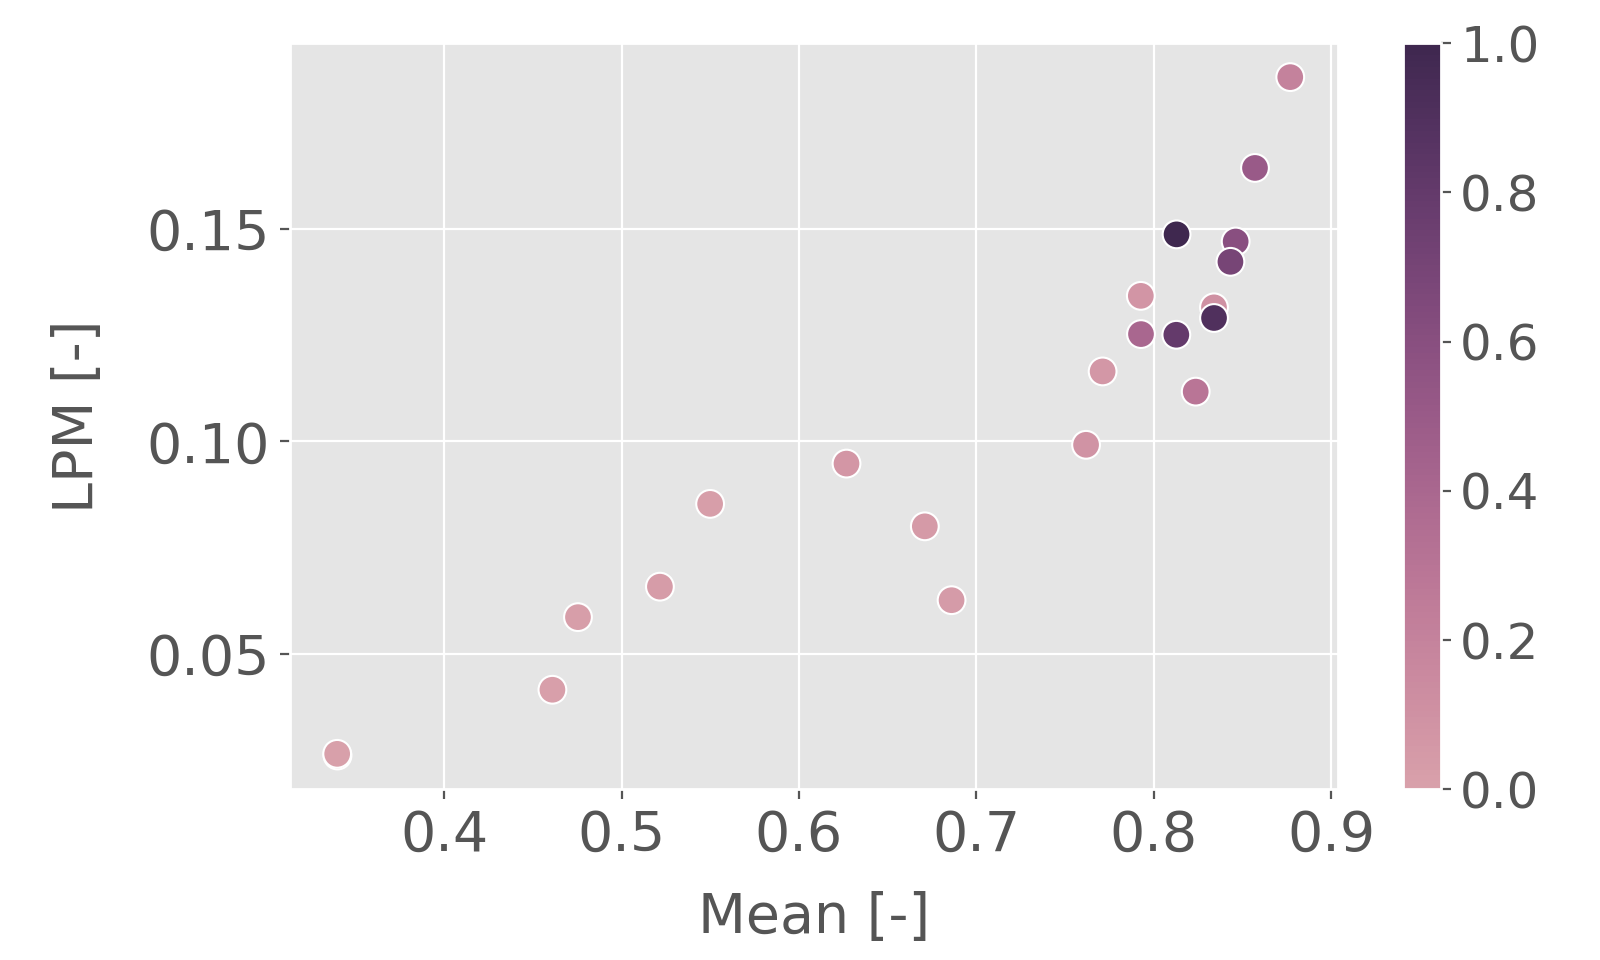
3무장 밴딧 실��험에서 NRCPO-LPM이 약5,000 샘플로 리스크 최적 선택에 수렴한 반면, 분산 기반 방법은 약100,000 샘플이 필요했습니다. 20배 빠른 수렴입니다. 포트폴리오 최적화에서는 기대수익-LPM 리스크 사이의 효율적 프론티어를 성공적으로 생성했습니다.
한계와 주의점
호환 함수 근사가 필요해 아키텍처 선택이 제한됩니다. 고차원·대규모 문제에서는 아직 검증되지 않았습니다.
그래서 투자/실무엔?
포트폴리오 RL에서 "평균 보상 최대화" 대신 "하방 위험 제약 하의 보상 최대화"를 할 수 있게 해줍니다. 손실 목표 미달 위험을 명시적 제약으로 걸고 학습하는 체계로, 자산배분 정책의 하방 손실 통제에 바로 적용 가능합니다.
테마 4: 팩터 모델에 불확실성을 더하면 Sharpe가 두 배로
문제: 팩터 신호가 맞을 때만 수익이 난다
전통적 팩터 투자(예: EBIT/EV로 저평가 종목 선별)는 현재 보고된 재무 데이터를 사용합니다. 하지만 재무 보고는 분기마다 나오고, 시장은 이미 반영한 뒤입니다. 미래 재무를 예측할 수 있다면? 그리고 그 예측이 얼마나 불확실한지 알 수 있다면?
핵심 아이디어: 미래를 예측하되, 불확실한 예측은 덜 믿어라
Chauhan, Alberg, Lipton의 이 논문(arXiv:2007.04082)은 딥러닝(MLP, LSTM)으로 12개월 미래 EBIT을 예측합니다.5년 치 재무 히스토리를 보고17개 피처를 동시에 예측하죠.
하지만 핵심은 예측 자체가 아니라 불확실성 정량화입니다:
- 알레아토릭 불확실성: 데이터 자체의 noise (신경망이 평균과 분산을 동시에 예측)
- 에피스테믹 불확실성: 모델의 ignorance (드롭아웃을 추론 시에도 켜서10번 예측 후 분산)
이 두 불확실성을 합쳐서, "이 종목의 미래 EBIT 예측이 얼마나 불확실한지"를 수치로 산출합니다. 그리고 표준 팩터(EBIT/EV)를 불확실성 조정 팩터(EBIT / (σ² × EV))로 바꿉니다. 예측이 불확실한 종목의 가중치를 낮추는 거죠.
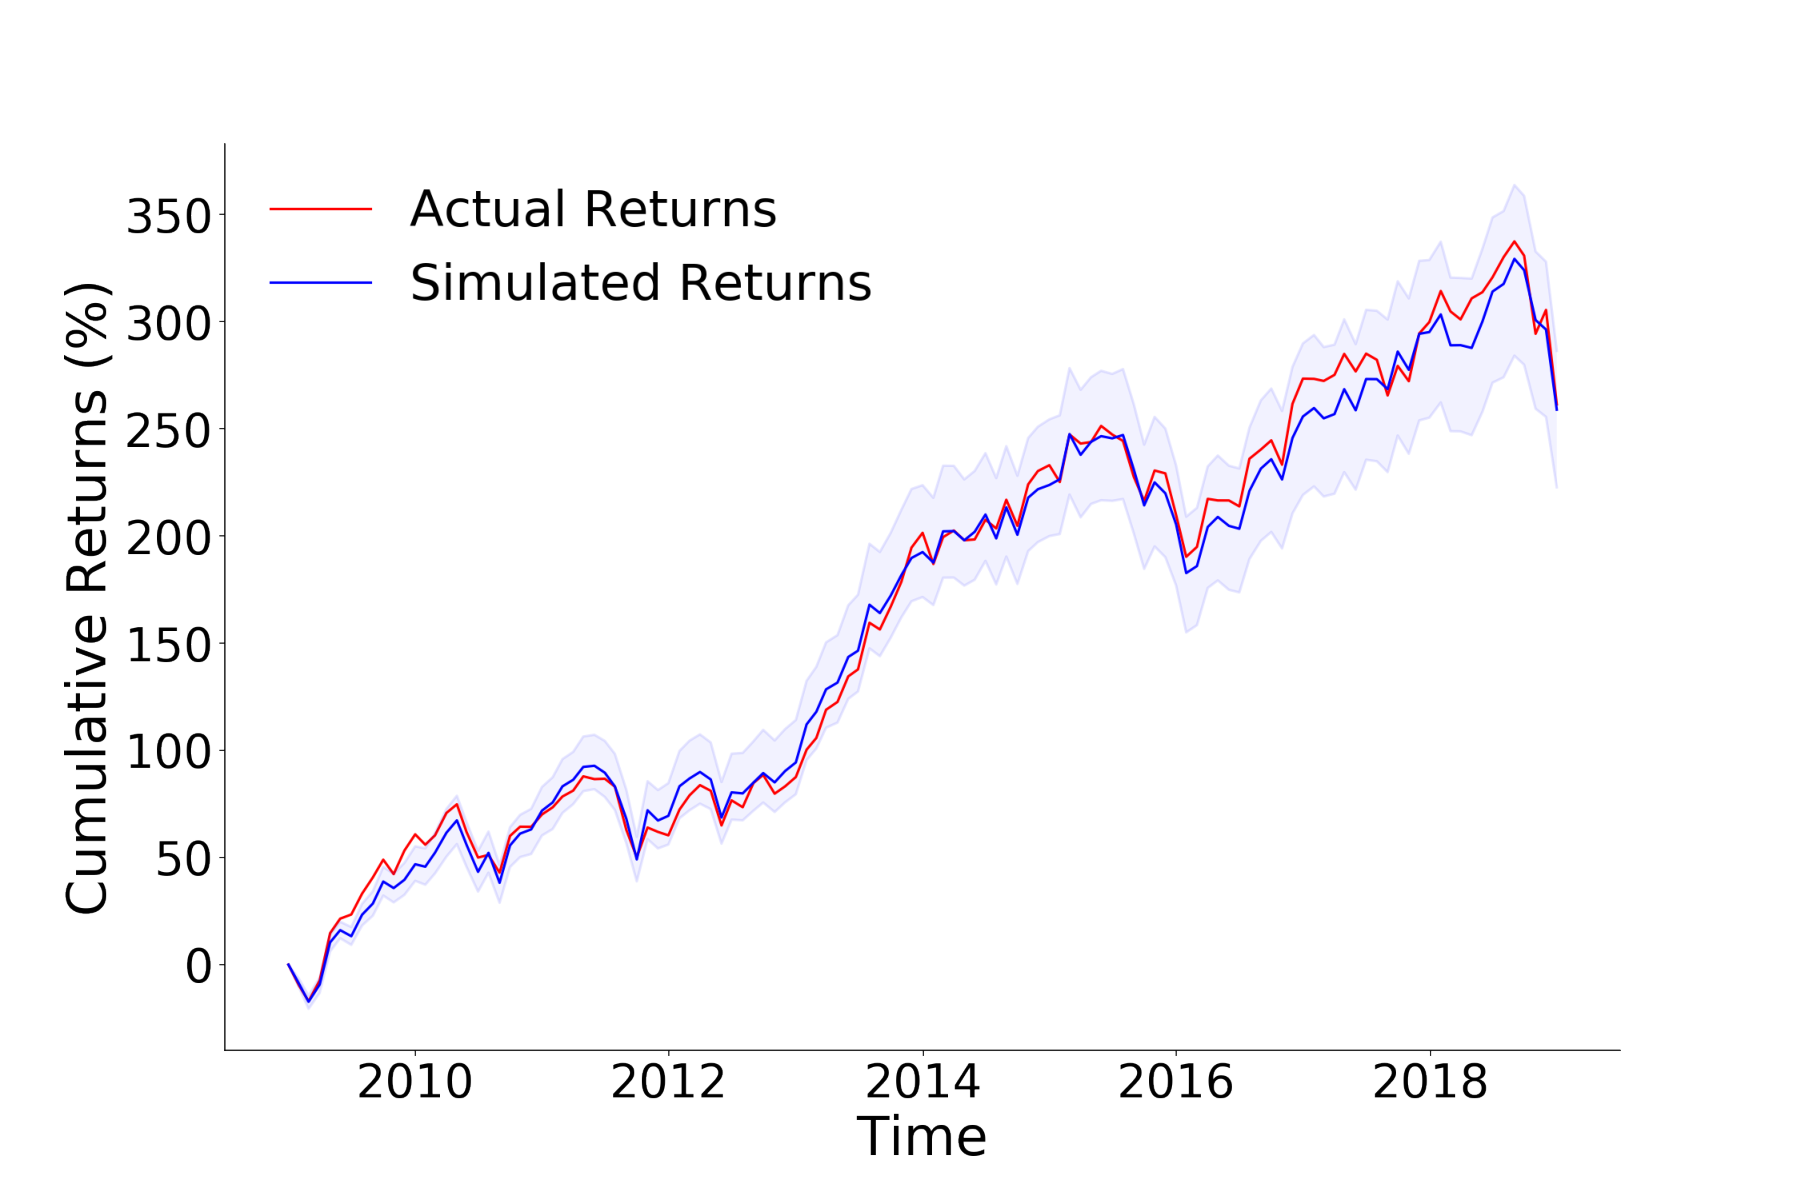
무엇을 알아냈나
2000~2019년 표본 외 검증 결과:
| 전략 | 연환산 수익률 | Sharpe |
|---|---|---|
| S&P 500 | 6.05% | 0.32 |
| 표준 팩터 모델 (현재 EBIT) | 14.0% | 0.52 |
| LSTM (미래 EBIT 예측) | 16.2% | — |
| 불확실성 인식 LSTM | 17.7% | 0.84 |
표준 팩터 모델에서 불확실성 인식 LSTM로 바꾸면, 수익률은14.0%→17.7%로26% 개선되고, Sharpe는0.52→0.84로 62% 개선됩니다. 불확실성이 높은 종목을 피하는 것만으로 위험조정 수익이 크게 좋아진다는 뜻입니다.
한계와 주의점
"완벽한 미래 EBIT을 알면" 연40% 수익이 가능한데, 최고 모델은17.7%에 불과합니다. Oracle 갭이 여전히 큽니다. 또한 미국 외 종목, 금융 섹터, 시가총액1억 달러 미만 소형주는 제외했습니다. 불확실성 추정에 사용한 MC 드롭아웃은 경험적 휴리스틱이지 원칙적인 베이즈 방법이 아닙니다.
그래서 투자/실무엔?
팩터 모델의 신호를 그대로 쓰지 말고, "이 신호가 얼마나 불확실한지"를 가중치로 사용하는 것만으로 위험조정 수익이 크게 개선됩니다. 실무에서는 다른 알파 신호와 결합할 때도 불확실성 가중치를 적용할 수 있습니다.
Big Picture: "꼬리"를 다루는 한 달
2020년 7월의 연구를 관통하는 하나의 메시지가 있습니다: "평균을 잘 맞추는 것"보다 "틀렸을 때의 비용을 줄이는 것"이 더 중요하다.
- 베이지안 최적화가 VaR/CVaR를 직접 탐색하고
- 딥러닝이 무차익 제약 아래 변동성면을 학습하며
- 강화학습이 하방 위험을 제약으로 명시하고
- 팩터 모델이 예측 불확실성으로 신호를 위험조정합니다
COVID-19 위기 이후 시장 불확실성이 일상화된 환경에서, 이 연구들은 모두 같은 방향을 가리키고 있습니다. 리스크를 사후에 측정하는 것이 아니라, 설계 단계부터 최적화 대상에 넣는 것. 이게2020년7월 AI 금융 연구가 우리에게 말하는 핵심입니다.
더 알아보기
함께하기: ohselab.com에서 최신 AI 금융 연구 소식을 받아보세요.
오세랩의 월간 연구 종합 시리즈입니다. 원문 논문은 각 arXiv 링크에서 확인할 수 있습니다.
📚 이 글에서 다룬 논문 (9편)
- BBayesian Optimization of Risk Measures
Sait Cakmak, Raul Astudillo, Peter Frazier 외 1명
- B
- AA Natural Actor-Critic Algorithm with Downside Risk Constraints
Thomas Spooner, Rahul Savani
- BUncertainty-Aware Lookahead Factor Models for Quantitative Investing
Lakshay Chauhan, John Alberg, Zachary C. Lipton
- ARobust pricing and hedging via neural SDEs
Patryk Gierjatowicz, Marc Sabate-Vidales, David Šiška 외 2명
- B
- BDeep Learning modeling of Limit Order Book: a comparative perspective
Antonio Briola, Jeremy Turiel, Tomaso Aste
- BOrdering and Inequalities for Mixtures on Risk Aggregation
Yuyu Chen, Peng Liu, Yang Liu 외 1명
등급은 오세에이아이연구소가 참신성·실전 적용성·엄밀성·재현성·인사이트를 종합해 매긴 것입니다. S·A 등급 전체 목록은 Awesome AI Trading Research에서 볼 수 있습니다.
관련 글
 📊 2020-08 월간
포트폴리오에 세금과 꼬리위험을 넣는 수학 — 2020년 8월 AI·퀀트 연구 하이라이트
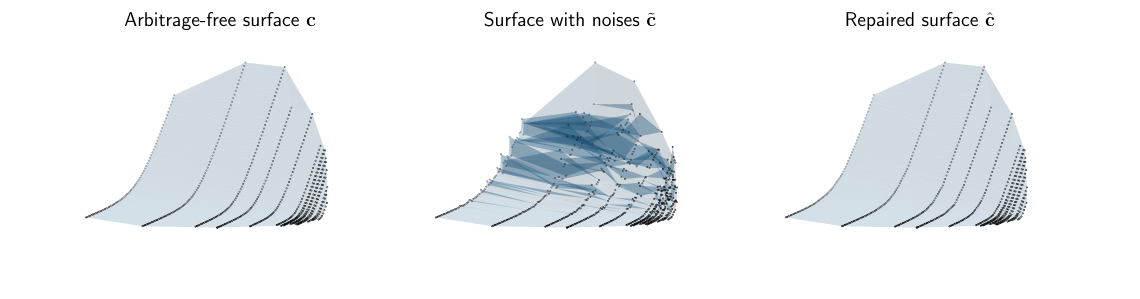
2020년 8월 arXiv에 올라온 시스템 트레이딩 핵심 논문들을 테마별로 정리합니다. 세금 인식 포트폴리오 최적화, 두꺼운 꼬리의 CVaR 추정, 옵션 차익거래 자동 탐지·수리, 예측 모델 검증 표준화까지 — 현실의 복잡한 제약을 수학으로 풀어내는 실용적 연구들을 살펴봅니다.
 📊 2026-09 월간
2026년 9월의 금융 AI 연구: 측정이 통념을 뒤집고, 검증이 창의성을 압도하다
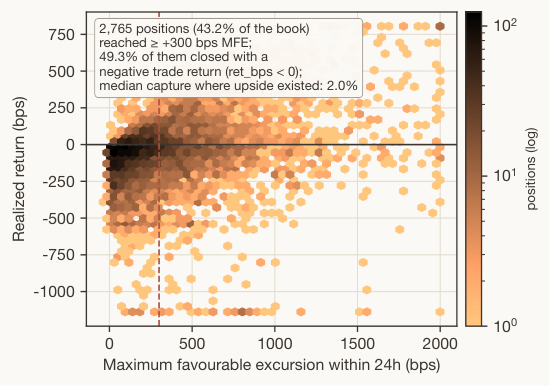
2026년 9월 arXiv에 공개된 금융 AI 연구를 5개 테마로 정리했습니다. 1년치 CME 실측 데이터로 HFT 설계 원칙을 뒤집은 S티어 논문, 수천 개 LLM 에이전트의 프로덕션 현실, anytime-valid 심판으로 팩터 거짓발견을 5~11배 줄이는 방법, 매직 스트라이크로 분산 계약을 정밀 산정하는 수학, drawdown을 강건하게 제어하는 포트폴리오 이론까지 — 측정과 검증이 창의성을 압도하는 달이었습니다.
 📊 2025-12 월간
크립토 백테스트가 거짓말하는 이유, 그리고 2025년 12월 퀀트 연구의 다섯 가지 흐름
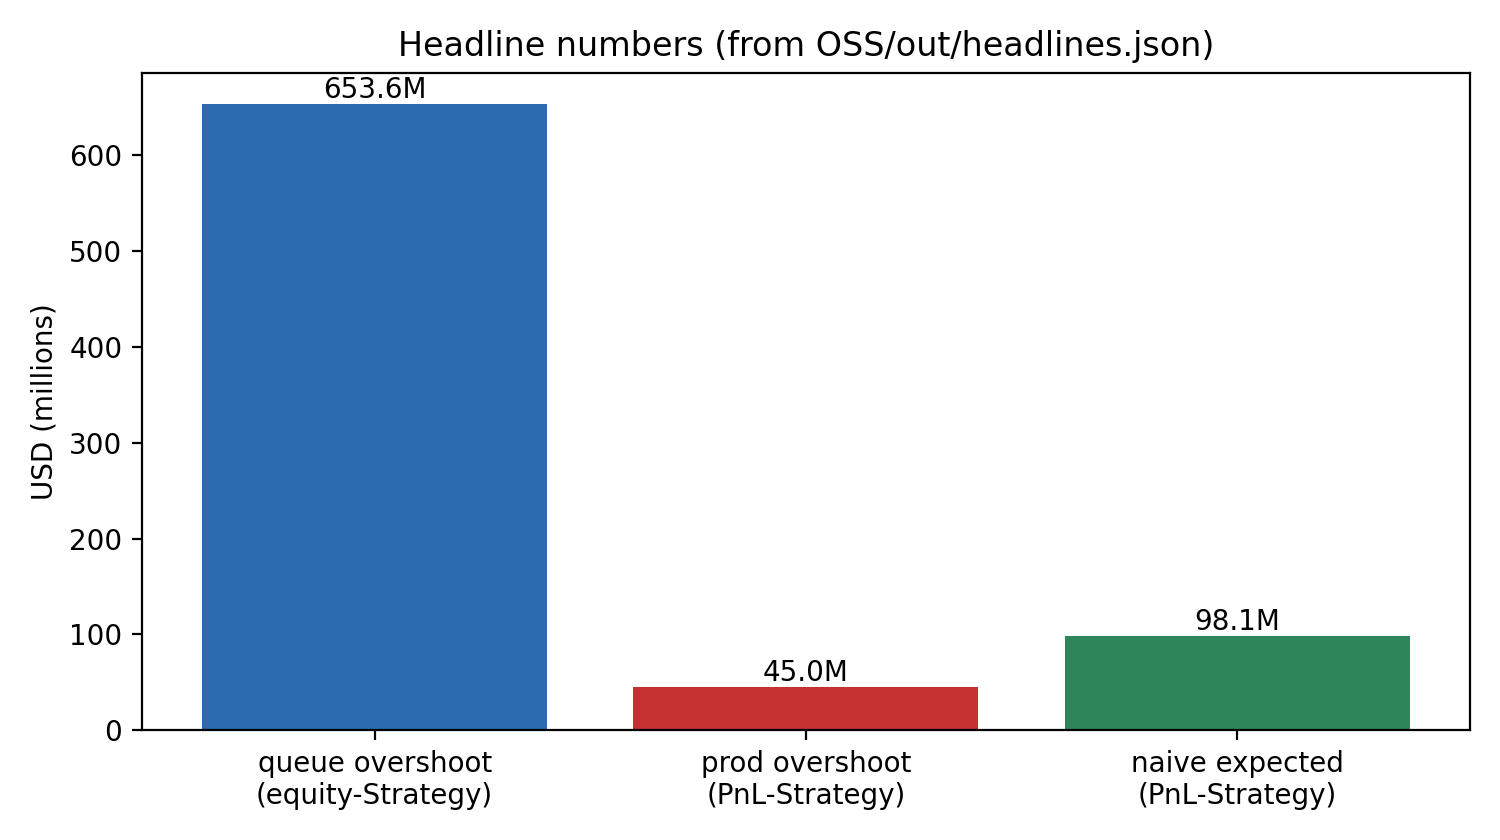
2025년 12월 arXiv에 올라온 금융 AI·퀀트 연구 중 주목할 만한 다섯 가지 흐름을 살펴봅니다. 크립토 백테스트의 과대평가 문제부터 팩터 알파의 수명까지, 실전에 가까워지는 퀀트 연구의 최신 동향을 쉽게 풀어 설명합니다.