Ohse AI LabOHSE AI LAB

AI·ML 트레이딩

딥러닝·강화학습·NLP·LLM·생성 모델을 활용한 트레이딩 · 글 25편

가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결
강화학습 포트폴리오

가상 시장을 만들어 연습시킨 AI 포트폴리오 매니저 — vine copula 시뮬레이션과 강화학습이 거래비용을 41.5% 줄인 비결

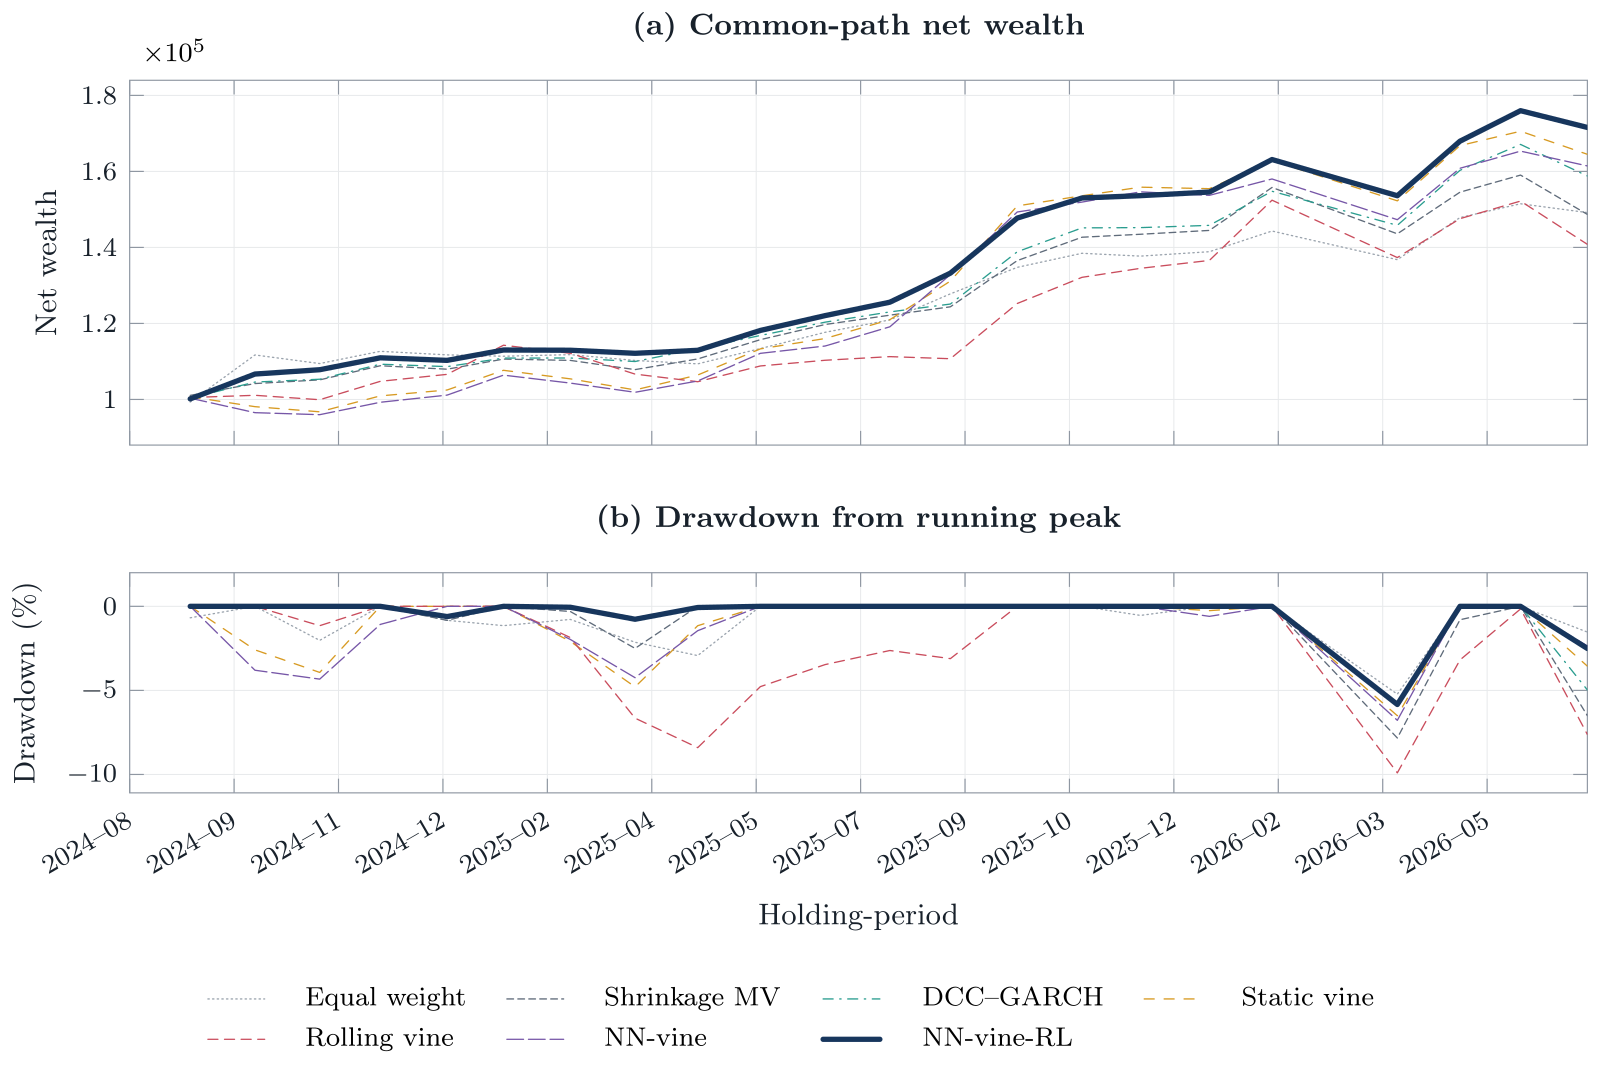
투자는 미래가 한 번뿐이라 연습할 수 없다. 이 논문은 자산 간 관계를 배워 가상 시장을 찍어내고, 그 가상 세계에서 강화학습 매니저를 훈련시켜 22개월 실전에서 연 34.13%, 샤프 2.31을 기록했다. 시뮬레이션 연습이 거래비용을 41.5% 줄인 과정과, '모형을 믿어도 되는가'를 수학적으로 따진 점을 쉽게 정리한다.

20분
포트폴리오 최적화vine copula+5
2020년 Deep Empirical Risk Minimization in finance: AI 투자 전략이 '미래를 훔쳐보는' 이유
포트폴리오 최적화S

2020년 Deep Empirical Risk Minimization in finance: AI 투자 전략이 '미래를 훔쳐보는' 이유

백테스트에서는 대박이 나는데 실전에서는 안 되는 그 이유. 2020년 발표된 이 논문은 딥러닝 투자 모델이 훈련 데이터 안에서 미래 정보를 몰래 암기하는 메커니즘을 이론적으로 증명했습니다. 데이터 규모와 모델 복잡도의 균형으로 과학습을 통제하는 조건까지 쉽게 풀어 설명합니다.

14분
딥러닝과적합+6
강화학습 주문집행이 실전에서 실패하는 이유: 2023년 일반화 거래집행 RL
알고리즘 트레이딩S

강화학습 주문집행이 실전에서 실패하는 이유: 2023년 일반화 거래집행 RL

백테스트에서는 완벽했던 강화학습 주문집행 알고리즘이 실전에서 무너지는 이유를 이론과 실험으로 규명한 2023년 연구를 쉽게 풀어 설명합니다. 과적합의 구조적 원인, 컨텍스트 압축 해법, 그리고 실전 적용 시사점을 다룹니다.

19분
강화학습 트레이딩주문집행+6
전력 가격 예측 벤치마크 TRACE: 운영 공지 텍스트로 상방 위험을 줄인다
시계열 계량경제학A

전력 가격 예측 벤치마크 TRACE: 운영 공지 텍스트로 상방 위험을 줄인다

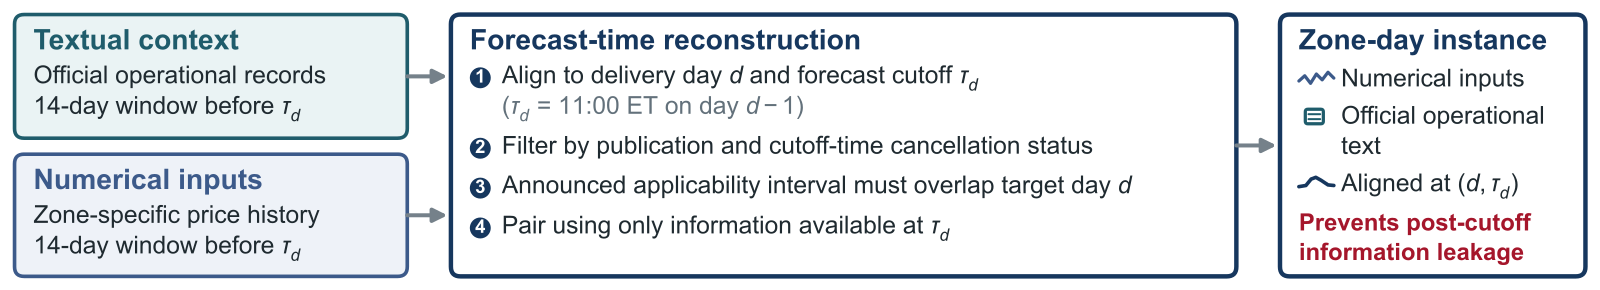
미국 전력 시장의 공식 운영 공지문을 예측 시점 기준으로 되살려 가격 데이터와 결합한 재현 가능 벤치마크 TRACE를 소개합니다. 텍스트가 전력 가격의 상방 위험 예측을 얼마나 개선하는지, 실험 설계와 한계를 일반인 눈높이로 설명합니다.

20분
전력 가격 예측텍스트 데이터 활용+5
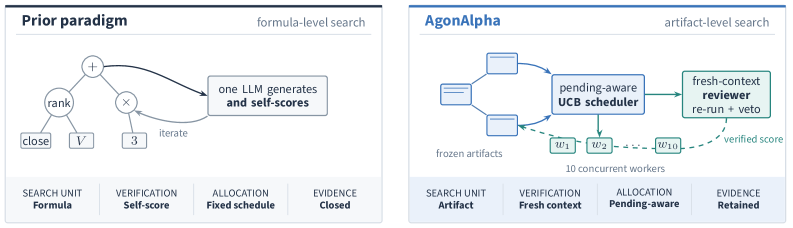
알파 팩터 마이닝 LLM 에이전트: 로컬 훈련으로 탐색 다양성을 되살리다
LLM 트레이딩 에이전트A

알파 팩터 마이닝 LLM 에이전트: 로컬 훈련으로 탐색 다양성을 되살리다

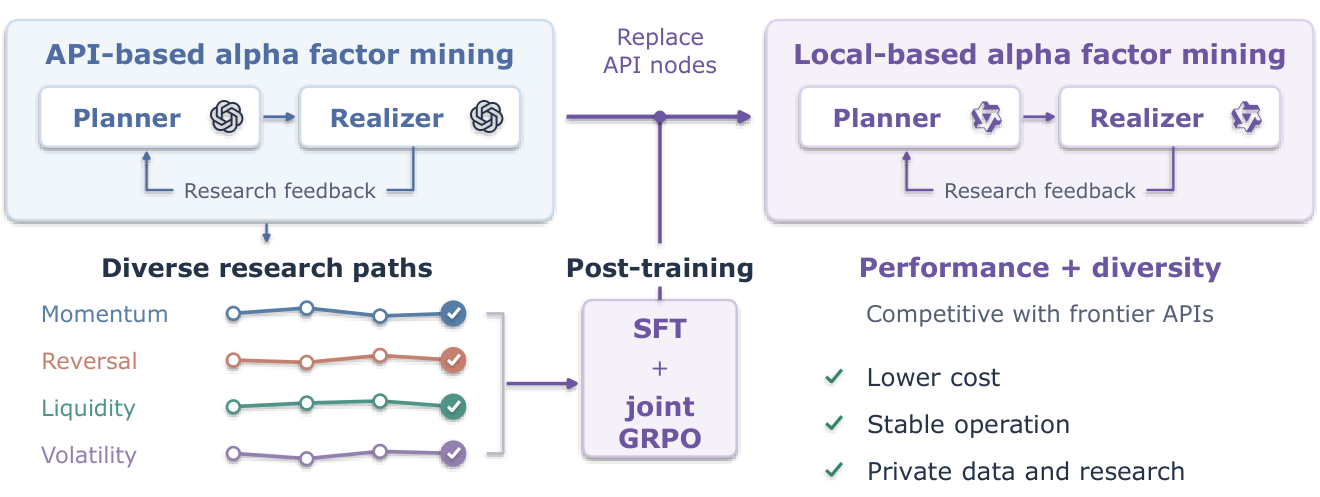
LLM 멀티 에이전트로 알파 팩터를 자동 발굴하면서도 같은 아이디어만 반복하는 연구 경로 붕괴를 극복하고, 외부 API 없이 로컬 모델로 훈련한 AlphaDiverse 논문을 쉽게 설명합니다. 예측 성능과 탐색 다양성을 함께 얻은 비결과 한계를 짚어봅니다.

20분
알파 팩터 마이닝LLM 트레이딩 에이전트+5
AI가 투자 팩터를 발굴하면 누가 검증할까? — LLM 에이전트와 통계 심판의 분리
팩터 투자A

AI가 투자 팩터를 발굴하면 누가 검증할까? — LLM 에이전트와 통계 심판의 분리

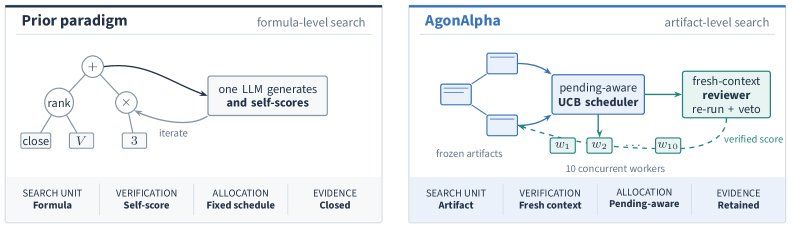
LLM 에이전트가 투자 팩터를 제안하고, 에이전트가 건드릴 수 없는 동결 통계 심판이 유효성을 판단하는 새로운 프레임워크를 소개합니다. 팩터 과적합과 가짜 발견을 막는 근본적인 해결책.

15분
LLM투자팩터+7
AI 트레이딩 에이전트 15종 보안 진단 — 80%는 위기 대응, 100%는 보안에서 실패
LLM 트레이딩 에이전트A

AI 트레이딩 에이전트 15종 보안 진단 — 80%는 위기 대응, 100%는 보안에서 실패

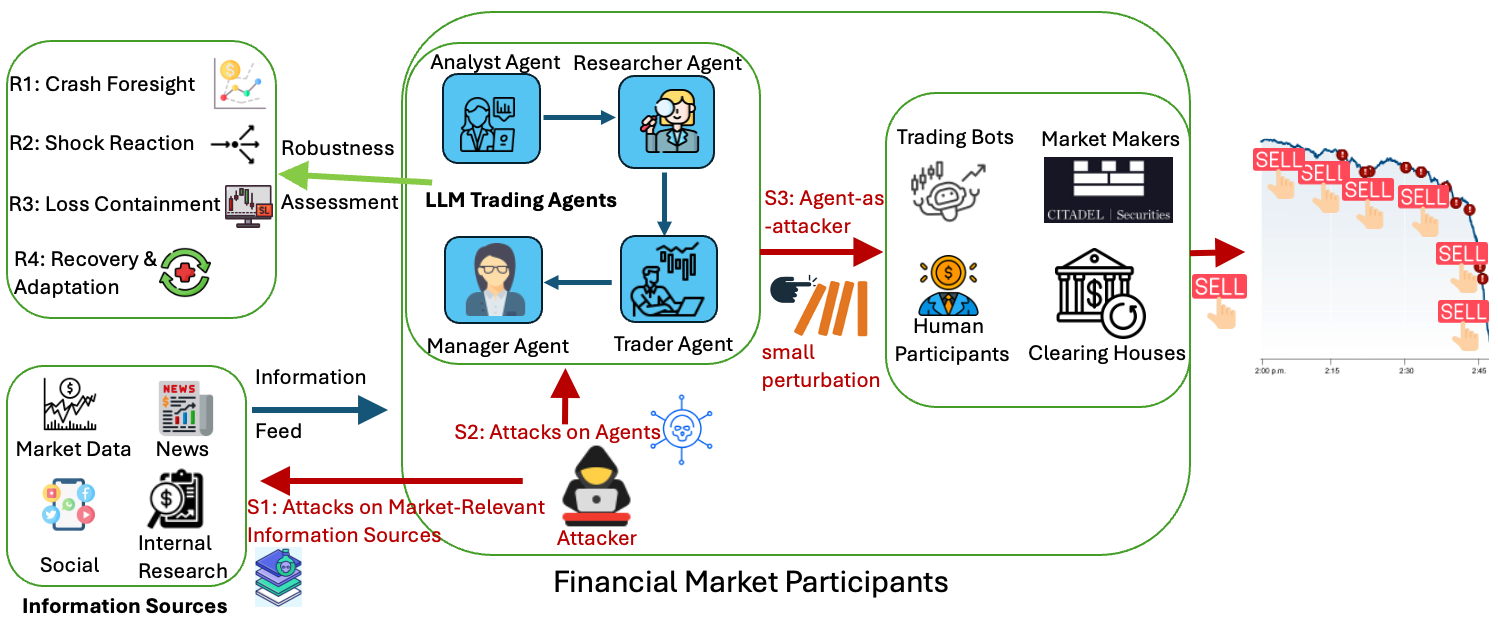
자금을 직접 굴리는 LLM 트레이딩 에이전트 15개를 견고성과 보안 9개 지표로 진단한 FARSIGHT 연구를 쉽게 풀어 설명합니다. 플래시 크래시 대응 부재, 프롬프트 주입, 에이전트 탈취 위험과 실무 방어 설계까지 AI 트레이딩 보안이 왜 필요한지 알려드립니다.

26분
LLM 트레이딩 에이전트AI 트레이딩 보안+5
같은 보고서, 다른 결론: AI 애널리스트의 '역할' 한 줄이 투자 판단을 바꾼다
LLM 트레이딩 에이전트A

같은 보고서, 다른 결론: AI 애널리스트의 '역할' 한 줄이 투자 판단을 바꾼다

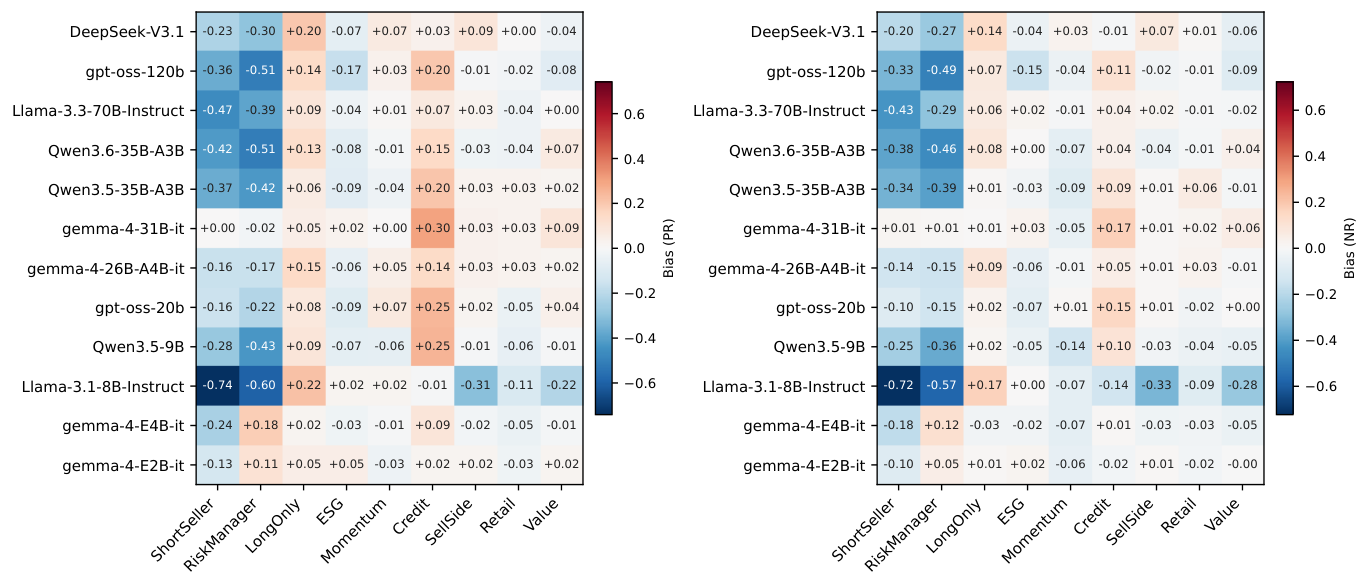
SEC 보고서 3,575건과 12개 AI 모델로 검증한 결과, '당신은 공매도 투자자입니다'라는 한 줄이 '중립' 분석 점수까지 바꾸는 것으로 나타났습니다. 편향이 어디서 생기고, 어떻게 줄이는지(그리고 왜 완전히 없애기는 어려운지) 쉽게 설명합니다.

22분
LLM 투자프롬프트 편향+6
LLM 트레이딩 전략 100개 자동 발굴, 정직한 평가를 통과한 것은?
LLM 트레이딩 에이전트A

LLM 트레이딩 전략 100개 자동 발굴, 정직한 평가를 통과한 것은?

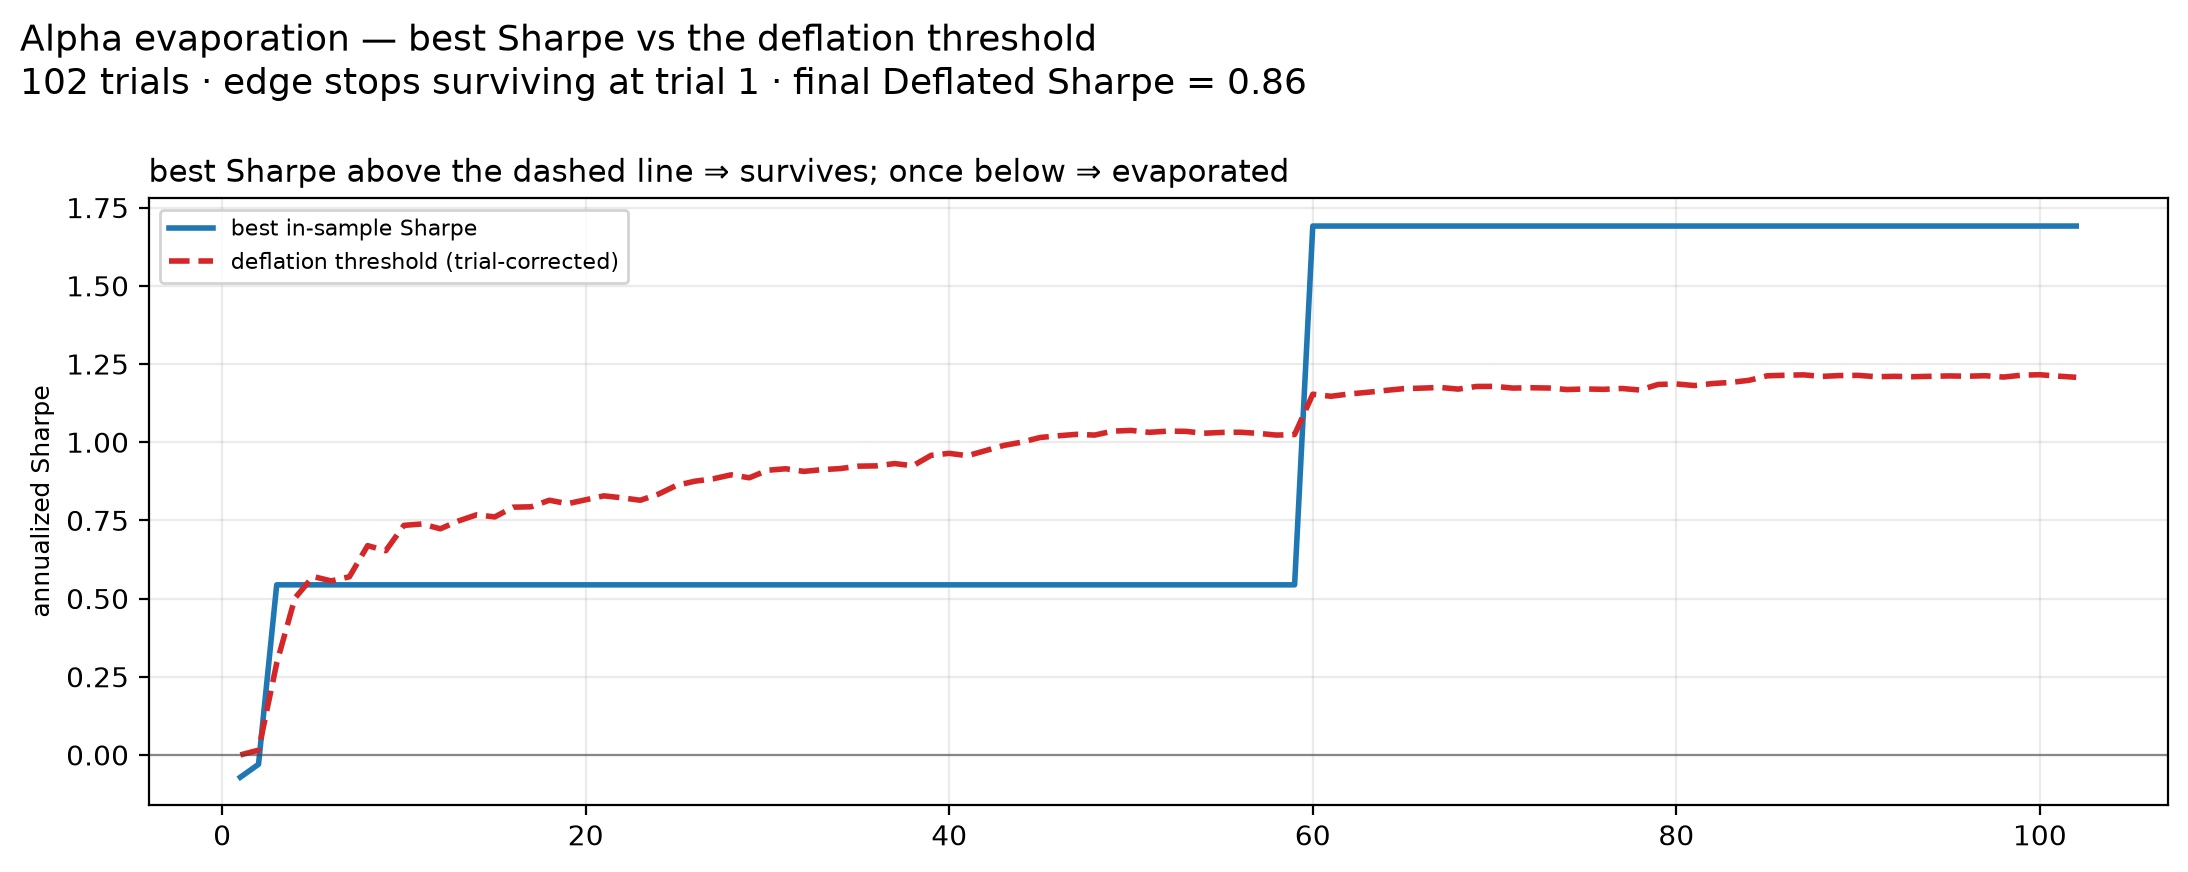
AI가 트레이딩 전략을 대량으로 만들어 그중 최고 성적만 보고하는 시대. 데이터 누수 차단과 탐색 횟수 보정으로 100개 후보를 정직하게 시험한 연구가 무엇을 남겼는지, 백테스트 과대평가의 함정부터 쉽게 풀어 설명합니다.

22분
LLM 트레이딩 전략백테스트 과대평가+5
KellyBoost 켈리 기준 포트폴리오 최적화
포트폴리오 최적화A

KellyBoost: 머신러닝으로 최적 포트폴리오를 직접 만드는 새로운 방법

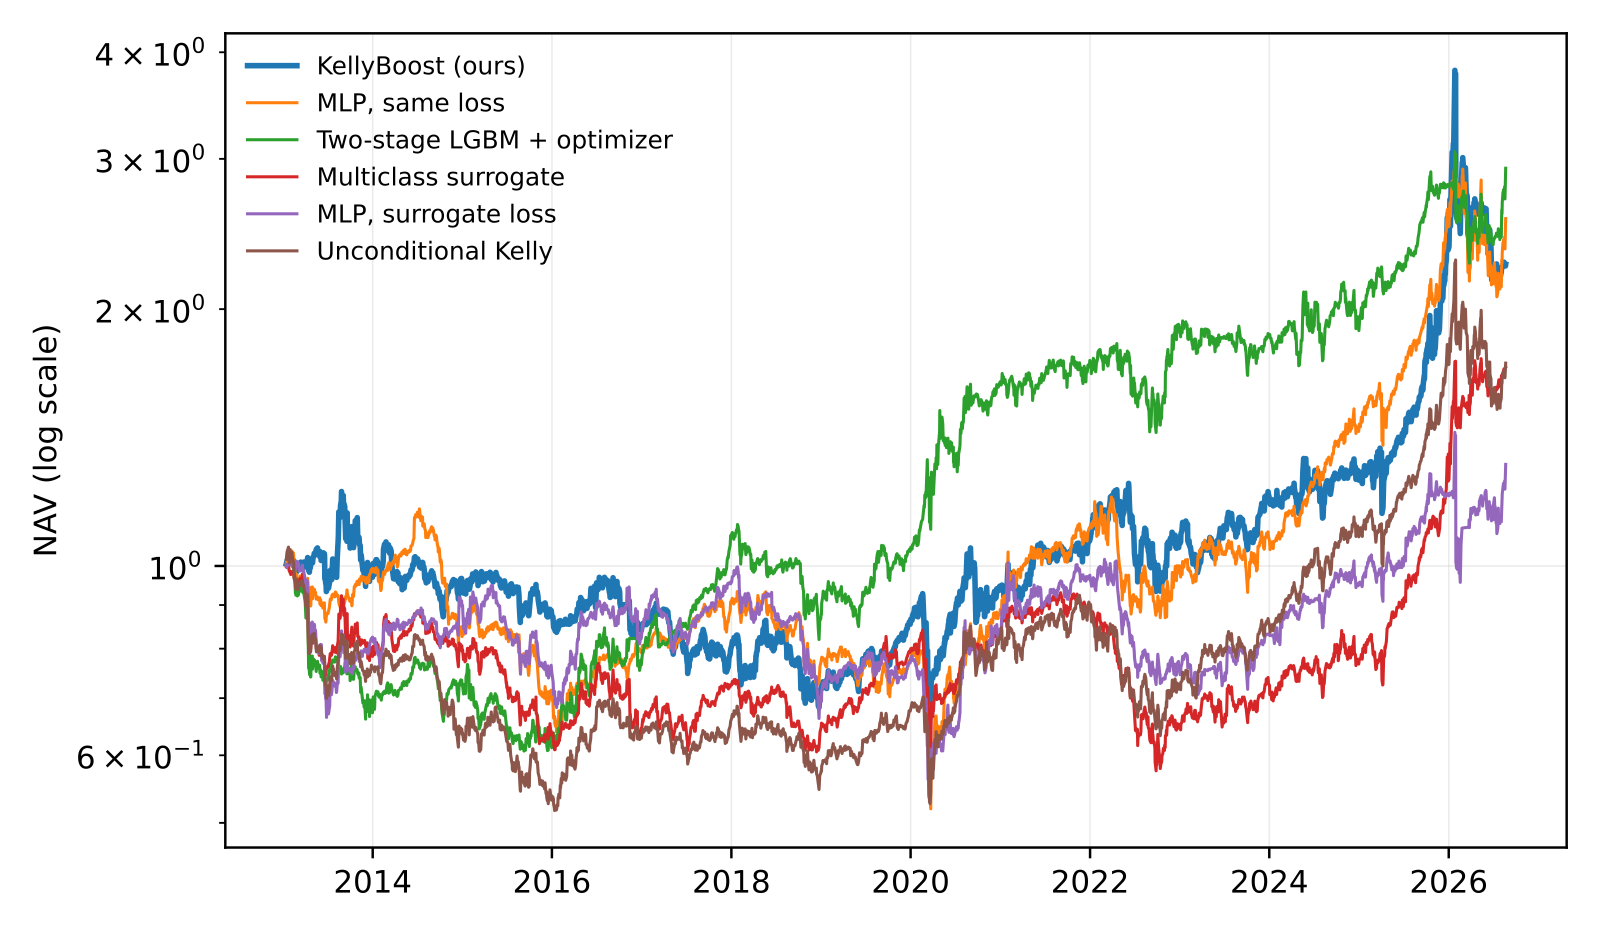
그래디언트 부스팅 트리로 켈리 기준 성장 최적 포트폴리오를 직접 학습하는 KellyBoost 방법론을 소개합니다. 예측과 최적화를 분리하는 기존 방식의 한계를 넘어, 목표 함수를 직접 최적화하는 엔드투엔드 접근법의 가능성과 한계를 살펴봅니다.

25분
KellyBoost켈리 기준+6
금융 뉴스 NLP 시간 누수: 주가 예측 성능 6.5배 부풀리는 함정과 M&A 신호
NLP·센티먼트 분석A

금융 뉴스 NLP 시간 누수: 주가 예측 성능 6.5배 부풀리는 함정과 M&A 신호

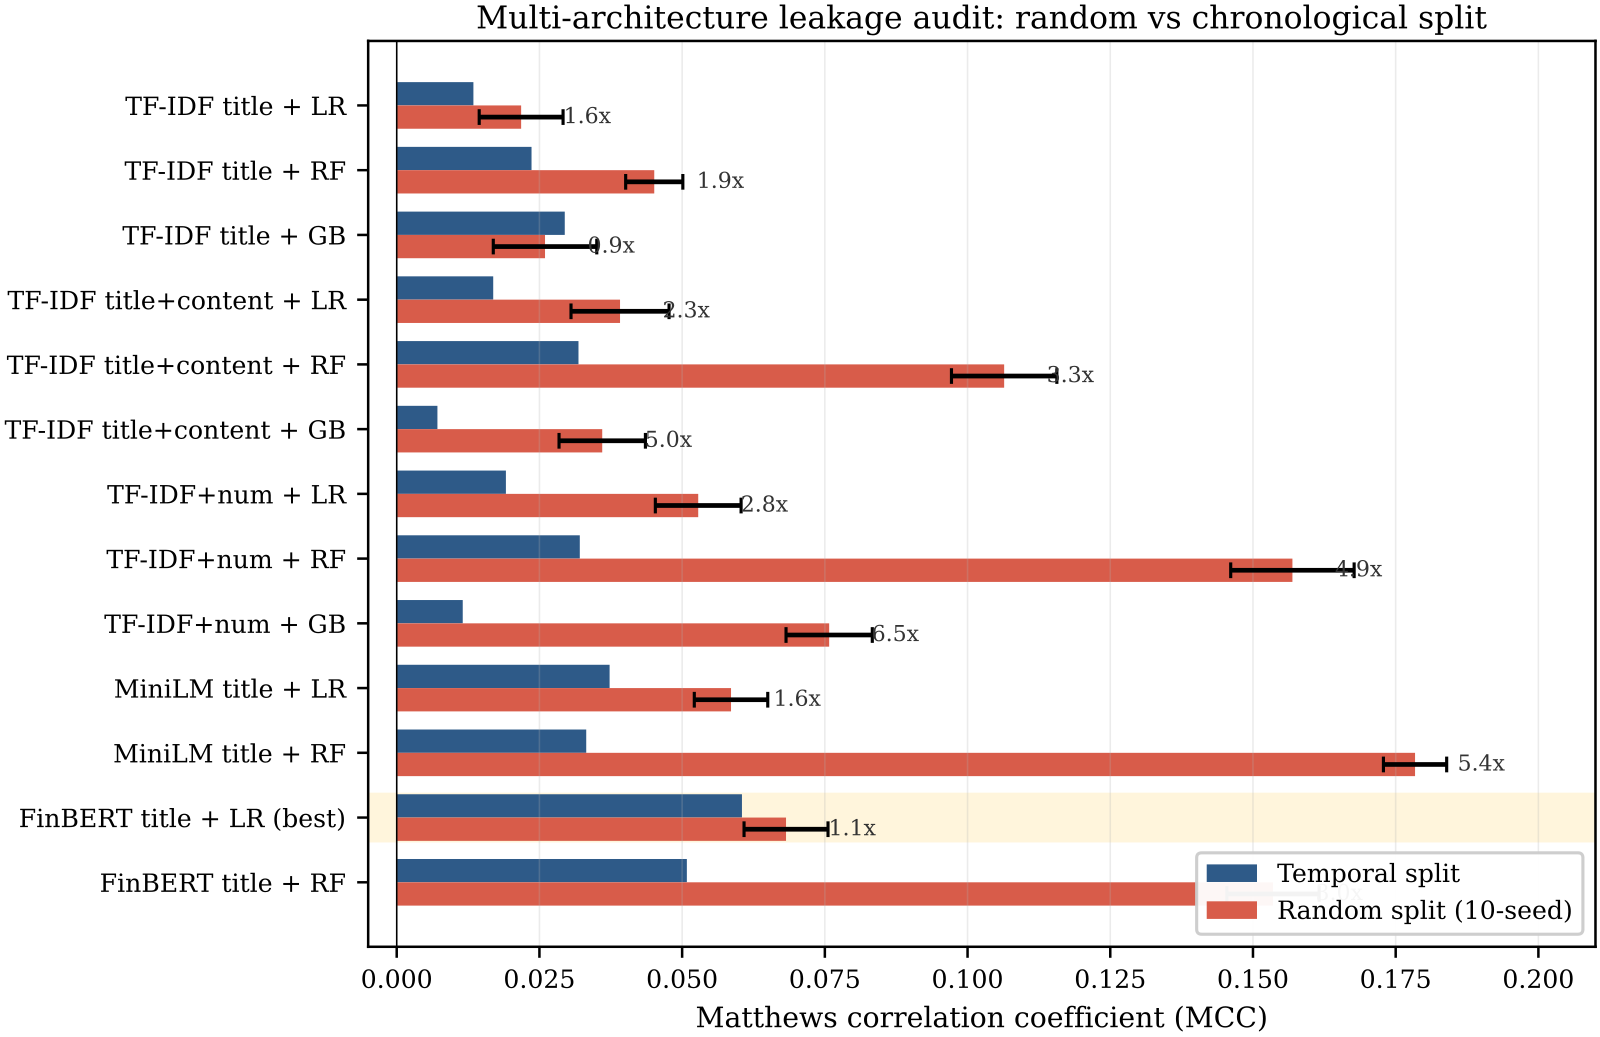
금융 뉴스로 주가 방향을 예측할 때 무작위 데이터 분할이 성능을 최대 6.5배 부풀리는 '시간 누수'를 16개 모델로 감사한 연구. 시간 순 분할로 검증하면 대부분의 신호가 사라지고 M&A 뉴스만 살아남는 이유를 쉽게 풀어 설명합니다.

17분
금융 뉴스 NLP시간 누수+5
금융 AI 에이전트 Mint-Agent — 근거 추론과 감사 가능한 실행이 범용 대형 모델을 이기다
LLM 트레이딩 에이전트A

금융 AI 에이전트 Mint-Agent — 근거 추론과 감사 가능한 실행이 범용 대형 모델을 이기다

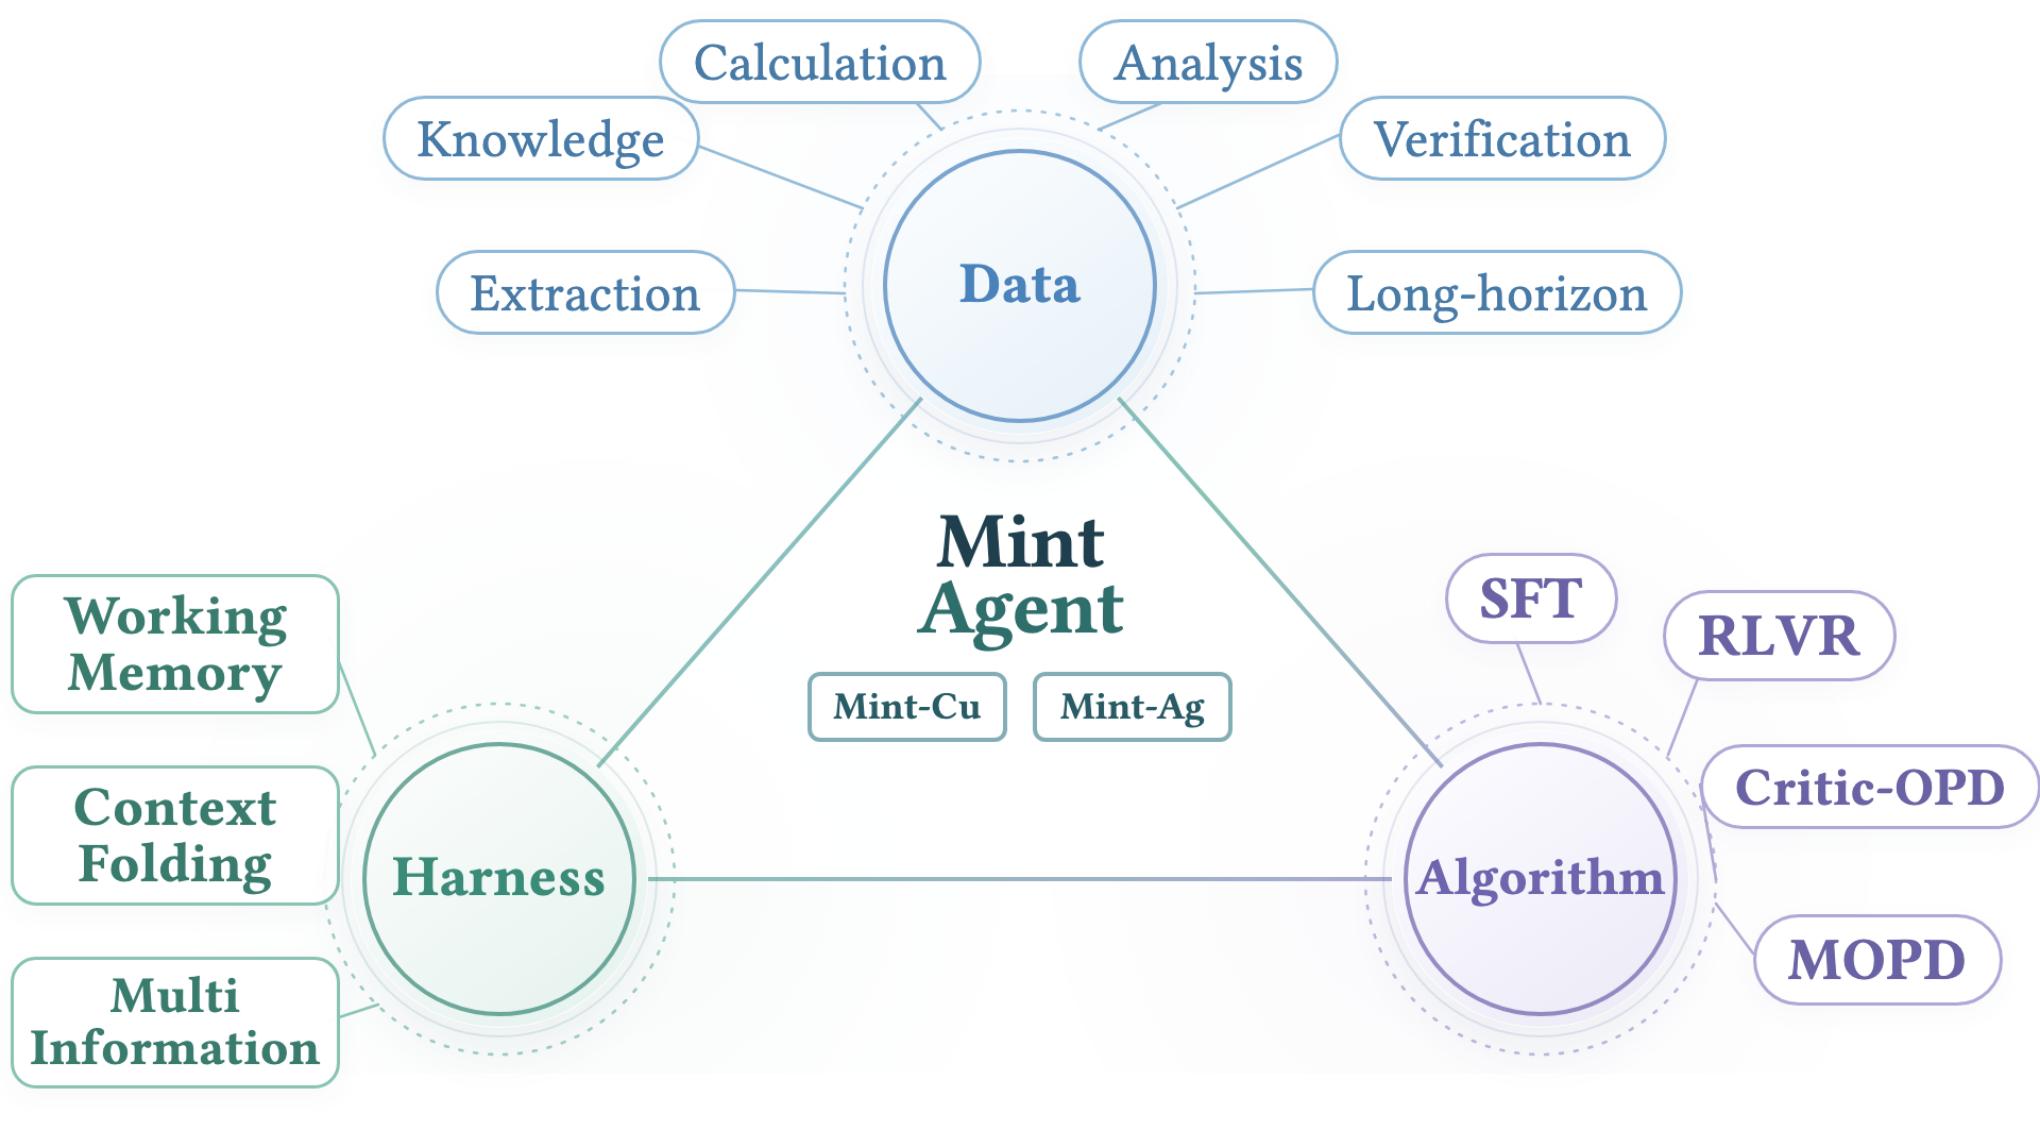
공시와 리서치 자료를 근거 기반으로 조사하는 금융 전용 에이전트 모델 Mint-Agent를 소개합니다. 9B와 27B의 작은 모델이 범용 초거대 모델을 벤치마크와 비용에서 모두 앞선 비결, 데이터 엔진과 근거 원장 설계를 쉽게 풀어 설명합니다.

18분
금융 AI 에이전트Mint-Agent+6
뉴스는 이미 반영됐을까? 457만 건 기사로 검증한 시장 격언의 진실
NLP·센티먼트 분석A

뉴스는 이미 반영됐을까? 457만 건 기사로 검증한 시장 격언의 진실

457만 건 미국 금융 기사와 LLM 분류로 '뉴스는 이미 가격에 반영된다'는 시장 격언을 정량 검증한 연구를 살펴봅니다. 뉴스 유형별로 가격 반영 속도가 어떻게 다른지, 투자에 어떤 의미가 있는지 쉽게 풀어 설명합니다.

16분
뉴스 트레이딩이벤트 스터디+5
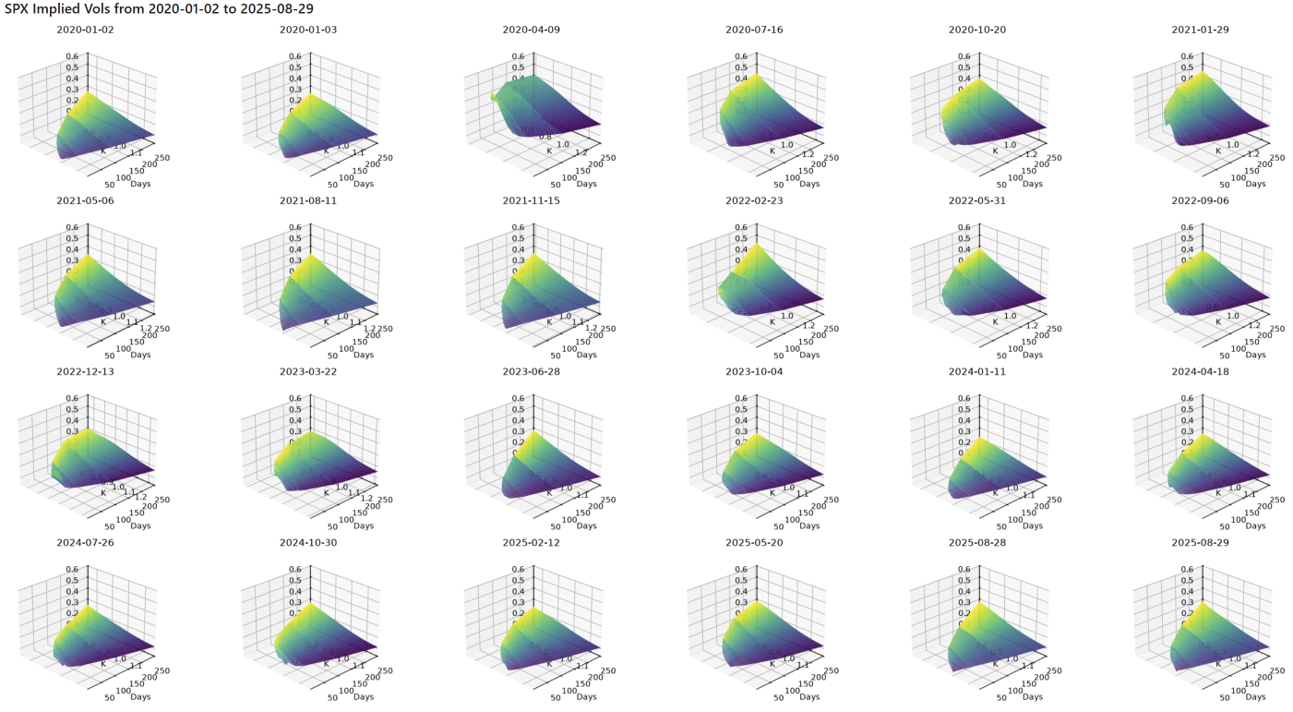
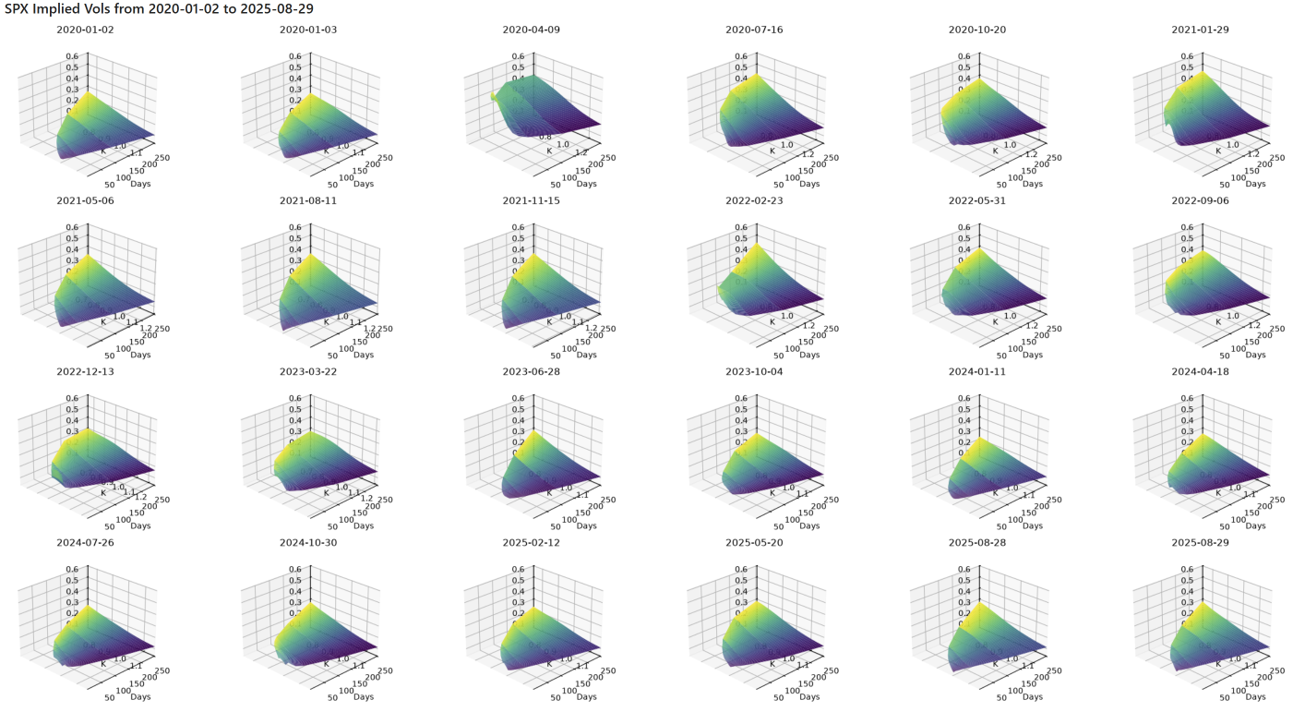
S&P 500 옵션의 역사적 내재변동성 (2020~2025)
생성 모델·합성 데이터B

옵션 가격을 '만들어내는' AI: 차익거래 없이 미래 시장을 시뮬레이션하는 방법

정적 차익거래 없이 매끄러운 옵션 변동성 곡면을 생성하는 최초의 AI 모형 DYSANOS. S&P 500 데이터로 검증된 이 모형이 파생상품 리스크 관리와 헤지 전략에 어떤 변화를 가져올 수 있는지 살펴봅니다.

12분
옵션면 생성차익거래 없는 시뮬레이션+5
옵션 가격을 '만들어내는' AI: 차익거래 없이 미래 시장을 시뮬레이션하는 방법
생성 모델·합성 데이터B

옵션 가격을 '만들어내는' AI: 차익거래 없이 미래 시장을 시뮬레이션하는 방법

정적 차익거래 없이 매끄러운 옵션 변동성 곡면을 생성하는 최초의 AI 모형 DYSANOS. S&P 500 데이터로 검증된 이 모형이 파생상품 리스크 관리와 헤지 전략에 어떤 변화를 가져올 수 있는지 살펴봅니다.

12분
옵션면 생성차익거래 없는 시뮬레이션+5
AI 금융 에이전트, 정말 똑똑할까? — 투자 리서치의 진짜 능력을 측정하는 벤치마크의 등장
LLM 트레이딩 에이전트A

AI 금융 에이전트, 정말 똑똑할까? — 투자 리서치의 진짜 능력을 측정하는 벤치마크의 등장

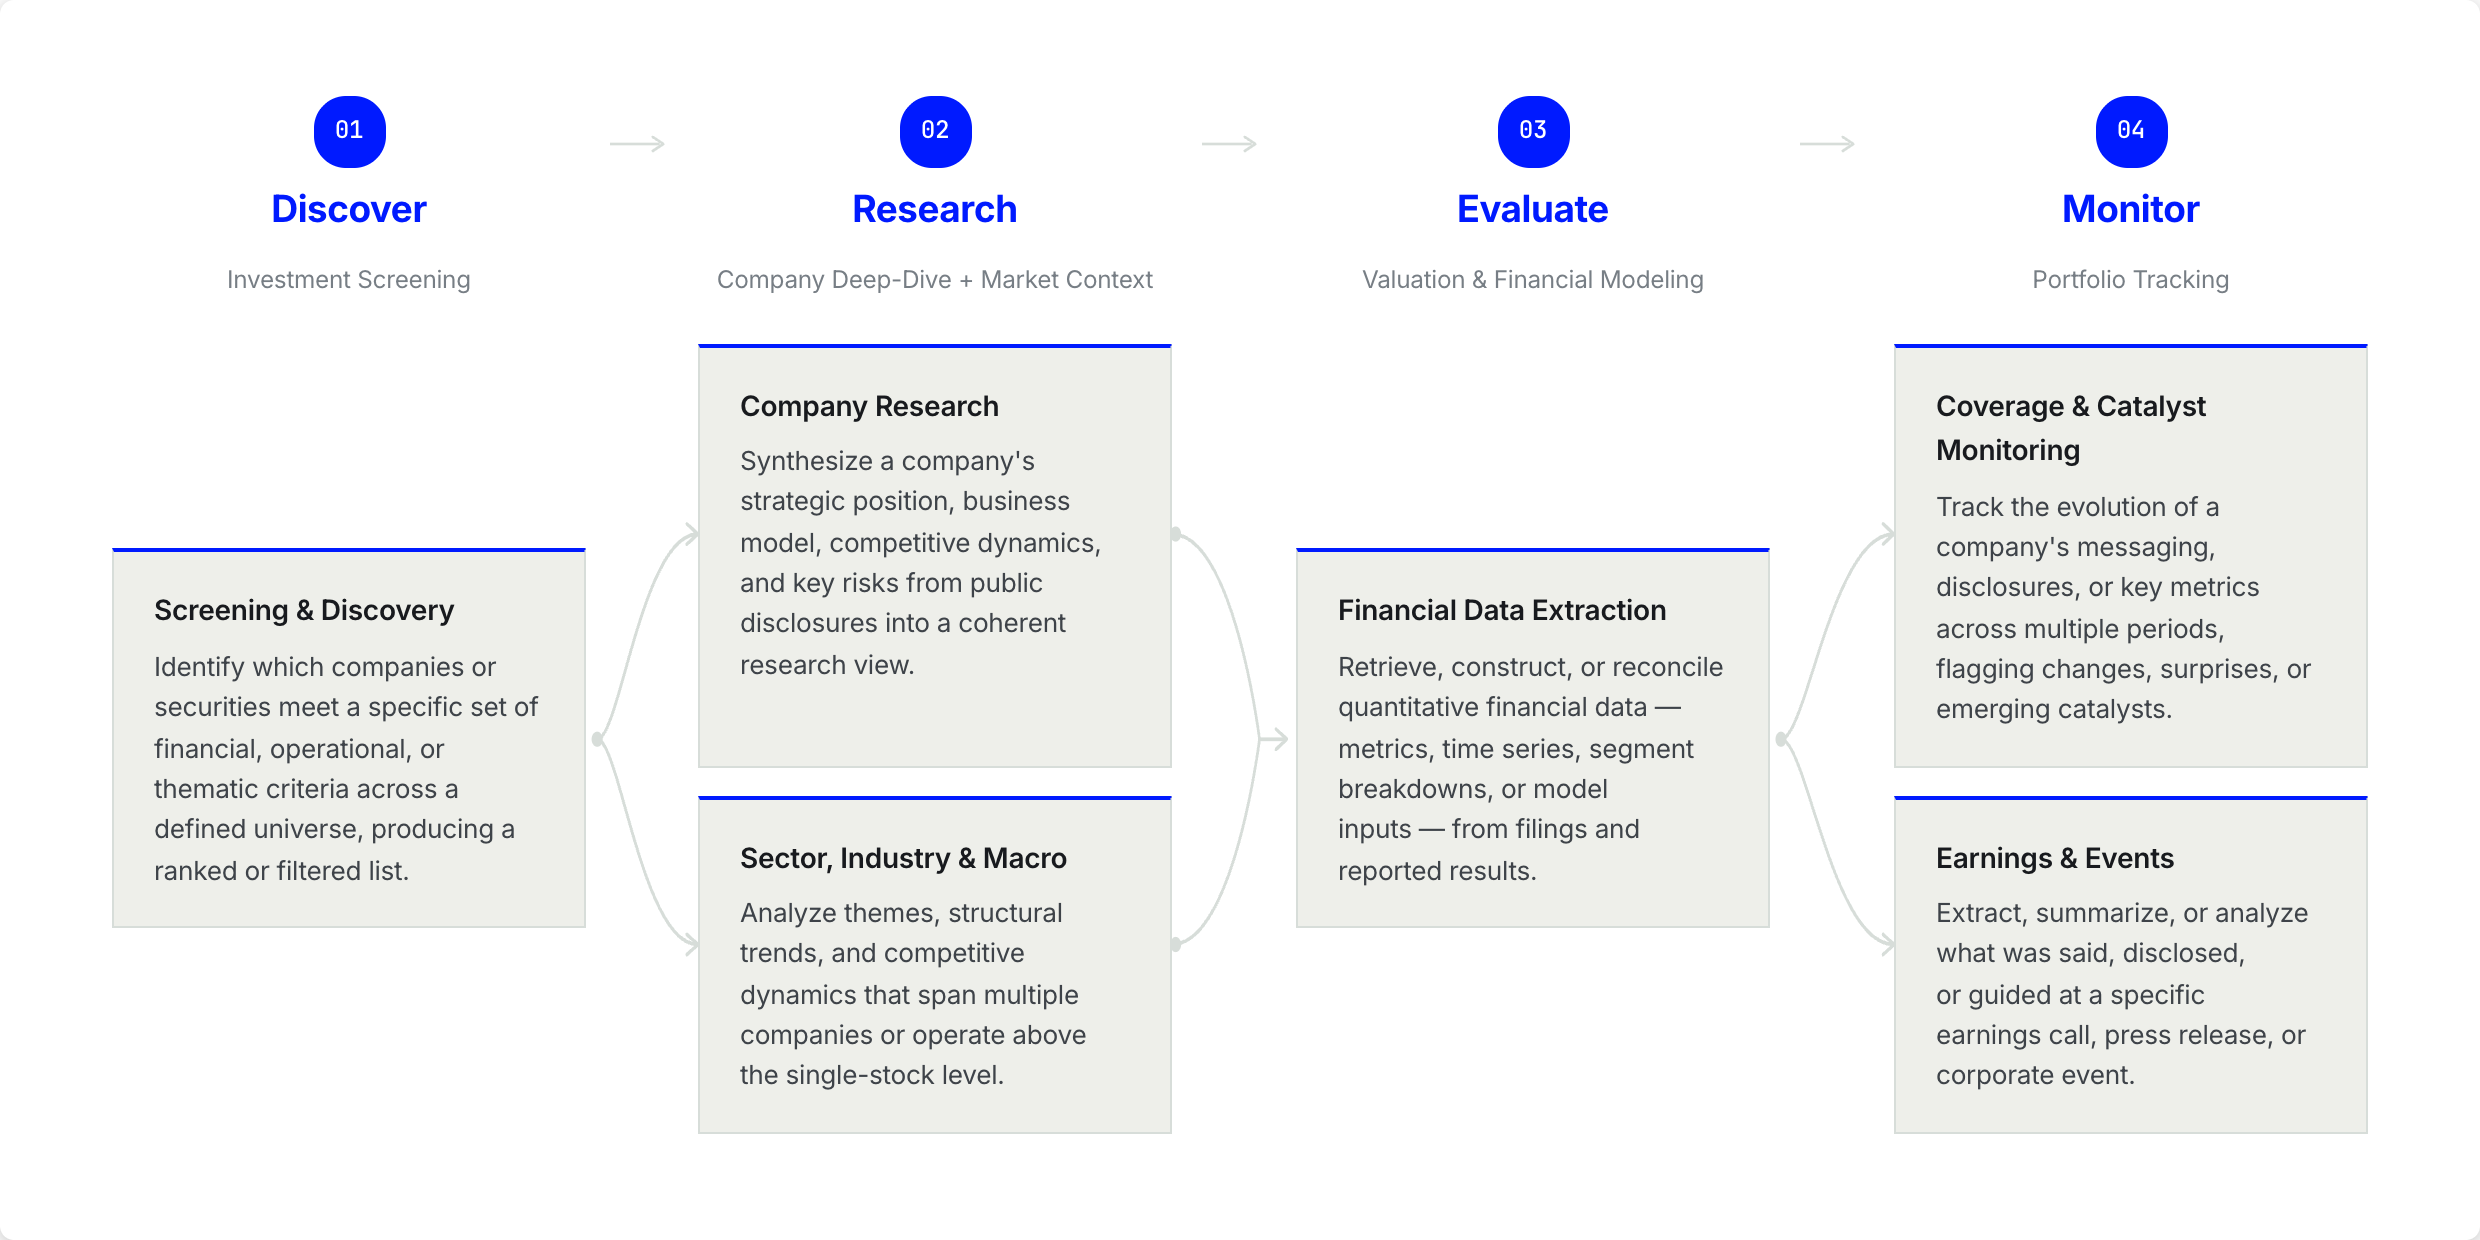
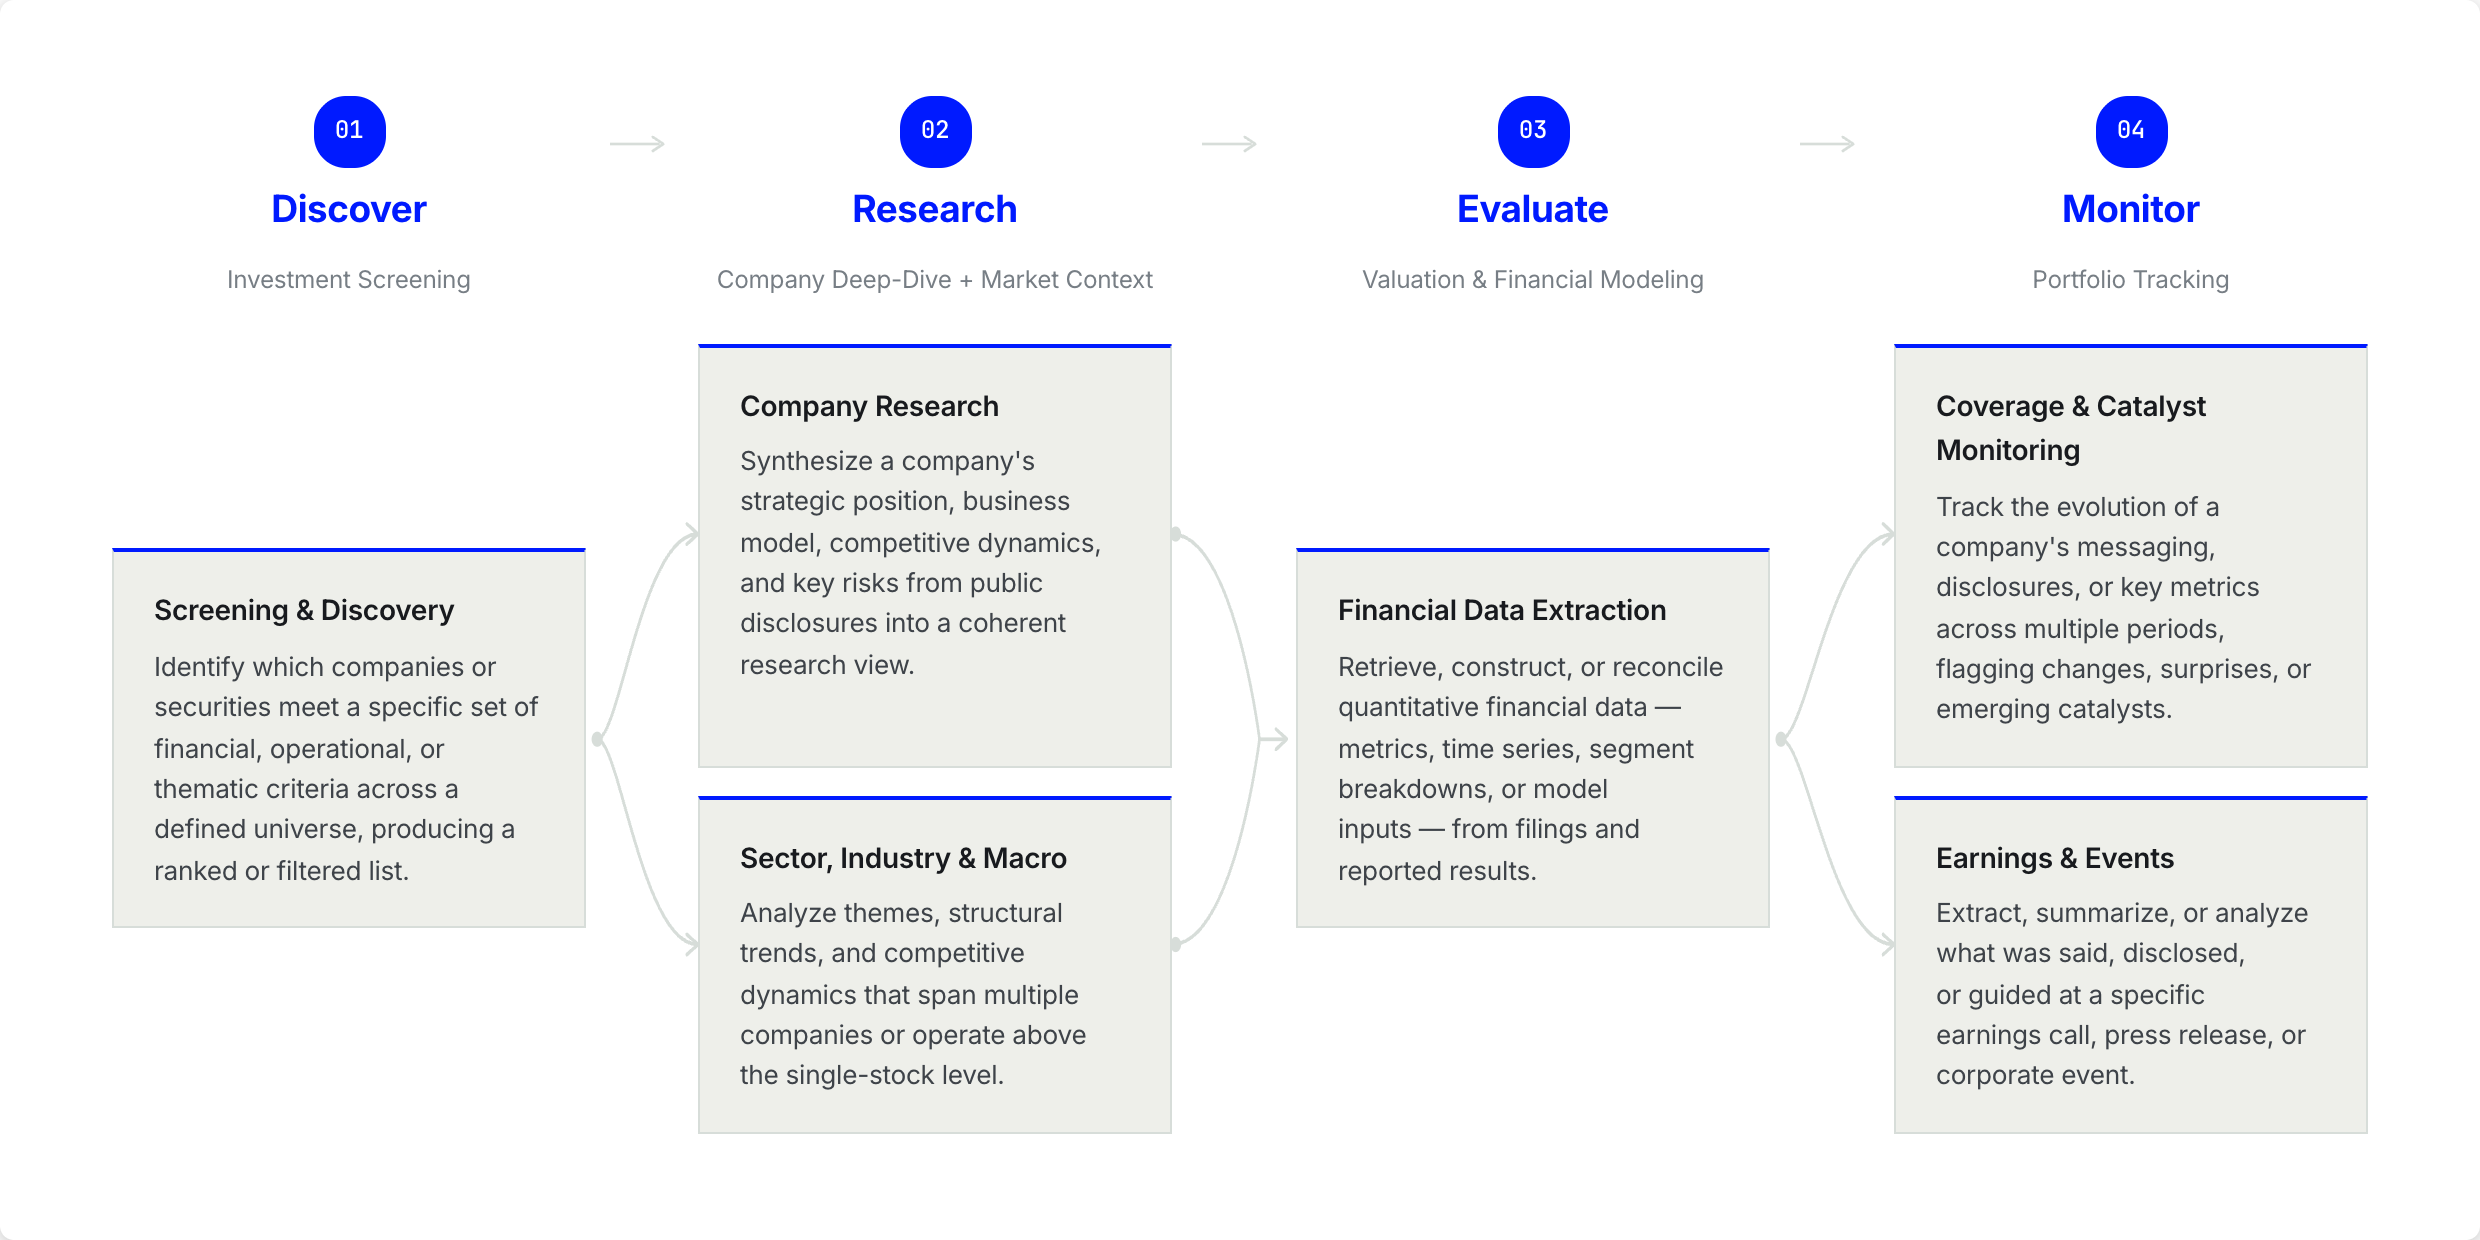
금융 데이터 추출을 넘어 실제 투자자 워크플로 전체를 평가하는 FrontierFinance 벤치마크를 소개합니다. 220개 전문가 설계 쿼리와 11,543개 이진 루브릭으로 금융 AI 에이전트의 진짜 능력을 측정한 결과, 최고 시스템도 56% 수준임을 보여줍니다.

13분
금융 AI에이전트+7
AI 금융 에이전트, 정말 똑똑할까? — 투자 리서치의 진짜 능력을 측정하는 벤치마크의 등장
LLM 트레이딩 에이전트A

AI 금융 에이전트, 정말 똑똑할까? — 투자 리서치의 진짜 능력을 측정하는 벤치마크의 등장

금융 데이터 추출을 넘어 실제 투자자 워크플로 전체를 평가하는 FrontierFinance 벤치마크를 소개합니다. 220개 전문가 설계 쿼리와 11,543개 이진 루브릭으로 금융 AI 에이전트의 진짜 능력을 측정한 결과, 최고 시스템도 56% 수준임을 보여줍니다.

20분
금융 AI에이전트+7
FrontierFinance가 평가하는 6개 투자 유스케이스
LLM 트레이딩 에이전트A

AI 금융 에이전트, 정말 똑똑할까? — 투자 리서치의 진짜 능력을 측정하는 벤치마크의 등장

금융 데이터 추출을 넘어 실제 투자자 워크플로 전체를 평가하는 FrontierFinance 벤치마크를 소개합니다. 220개 전문가 설계 쿼리와 11,543개 이진 루브릭으로 금융 AI 에이전트의 진짜 능력을 측정한 결과, 최고 시스템도 56% 수준임을 보여줍니다.

20분
금융 AI에이전트+7
90만 파라미터가 초거대 AI를 이겼다 — 재무제표 5년 장기 예측의 비밀
딥러닝 가격 예측A

90만 파라미터가 초거대 AI를 이겼다 — 재무제표 5년 장기 예측의 비밀

78개 재무제표 항목을 최대 20분기 앞까지 jointly 예측하는 전문 트랜스포머 Forma가 랜덤포레스트, LLM, 시계열 기반 모델 모두를 압도한 연구를 소개합니다. DCF 밸류에이션의 핵심 입력을 장기로 정확하게 추정하는 방법을 살펴봅니다.

14분
재무제표예측DCF+7
블랙박스 포트폴리오 솔버, 정말 믿어도 될까? — 정책 품질을 수학적으로 인증하는 새로운 방법
포트폴리오 최적화A

블랙박스 포트폴리오 솔버, 정말 믿어도 될까? — 정책 품질을 수학적으로 인증하는 새로운 방법

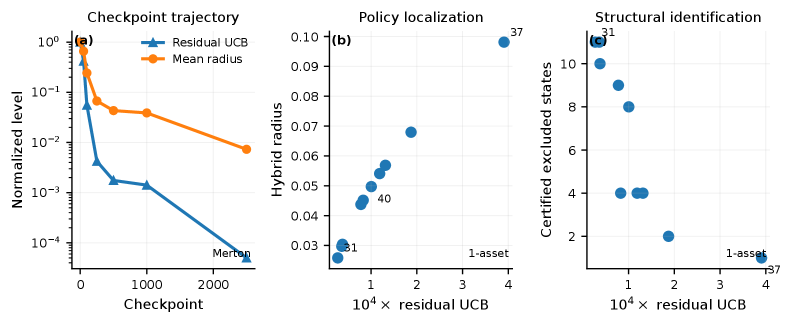
동적 포트폴리오 최적화에서 신경망·수치 솔버의 결과를 정책 거리와 제약 활성면으로 동시에 인증하는 Same-Grid Duality 프레임워크를 쉽게 풀어 설명합니다.

13분
포트폴리오 최적화정책인증+4
LLM 트레이딩 에이전트는 자기 지능값을 벌까? TradeLens 손익 감사
LLM 트레이딩 에이전트A

LLM 트레이딩 에이전트는 자기 지능값을 벌까? TradeLens 손익 감사

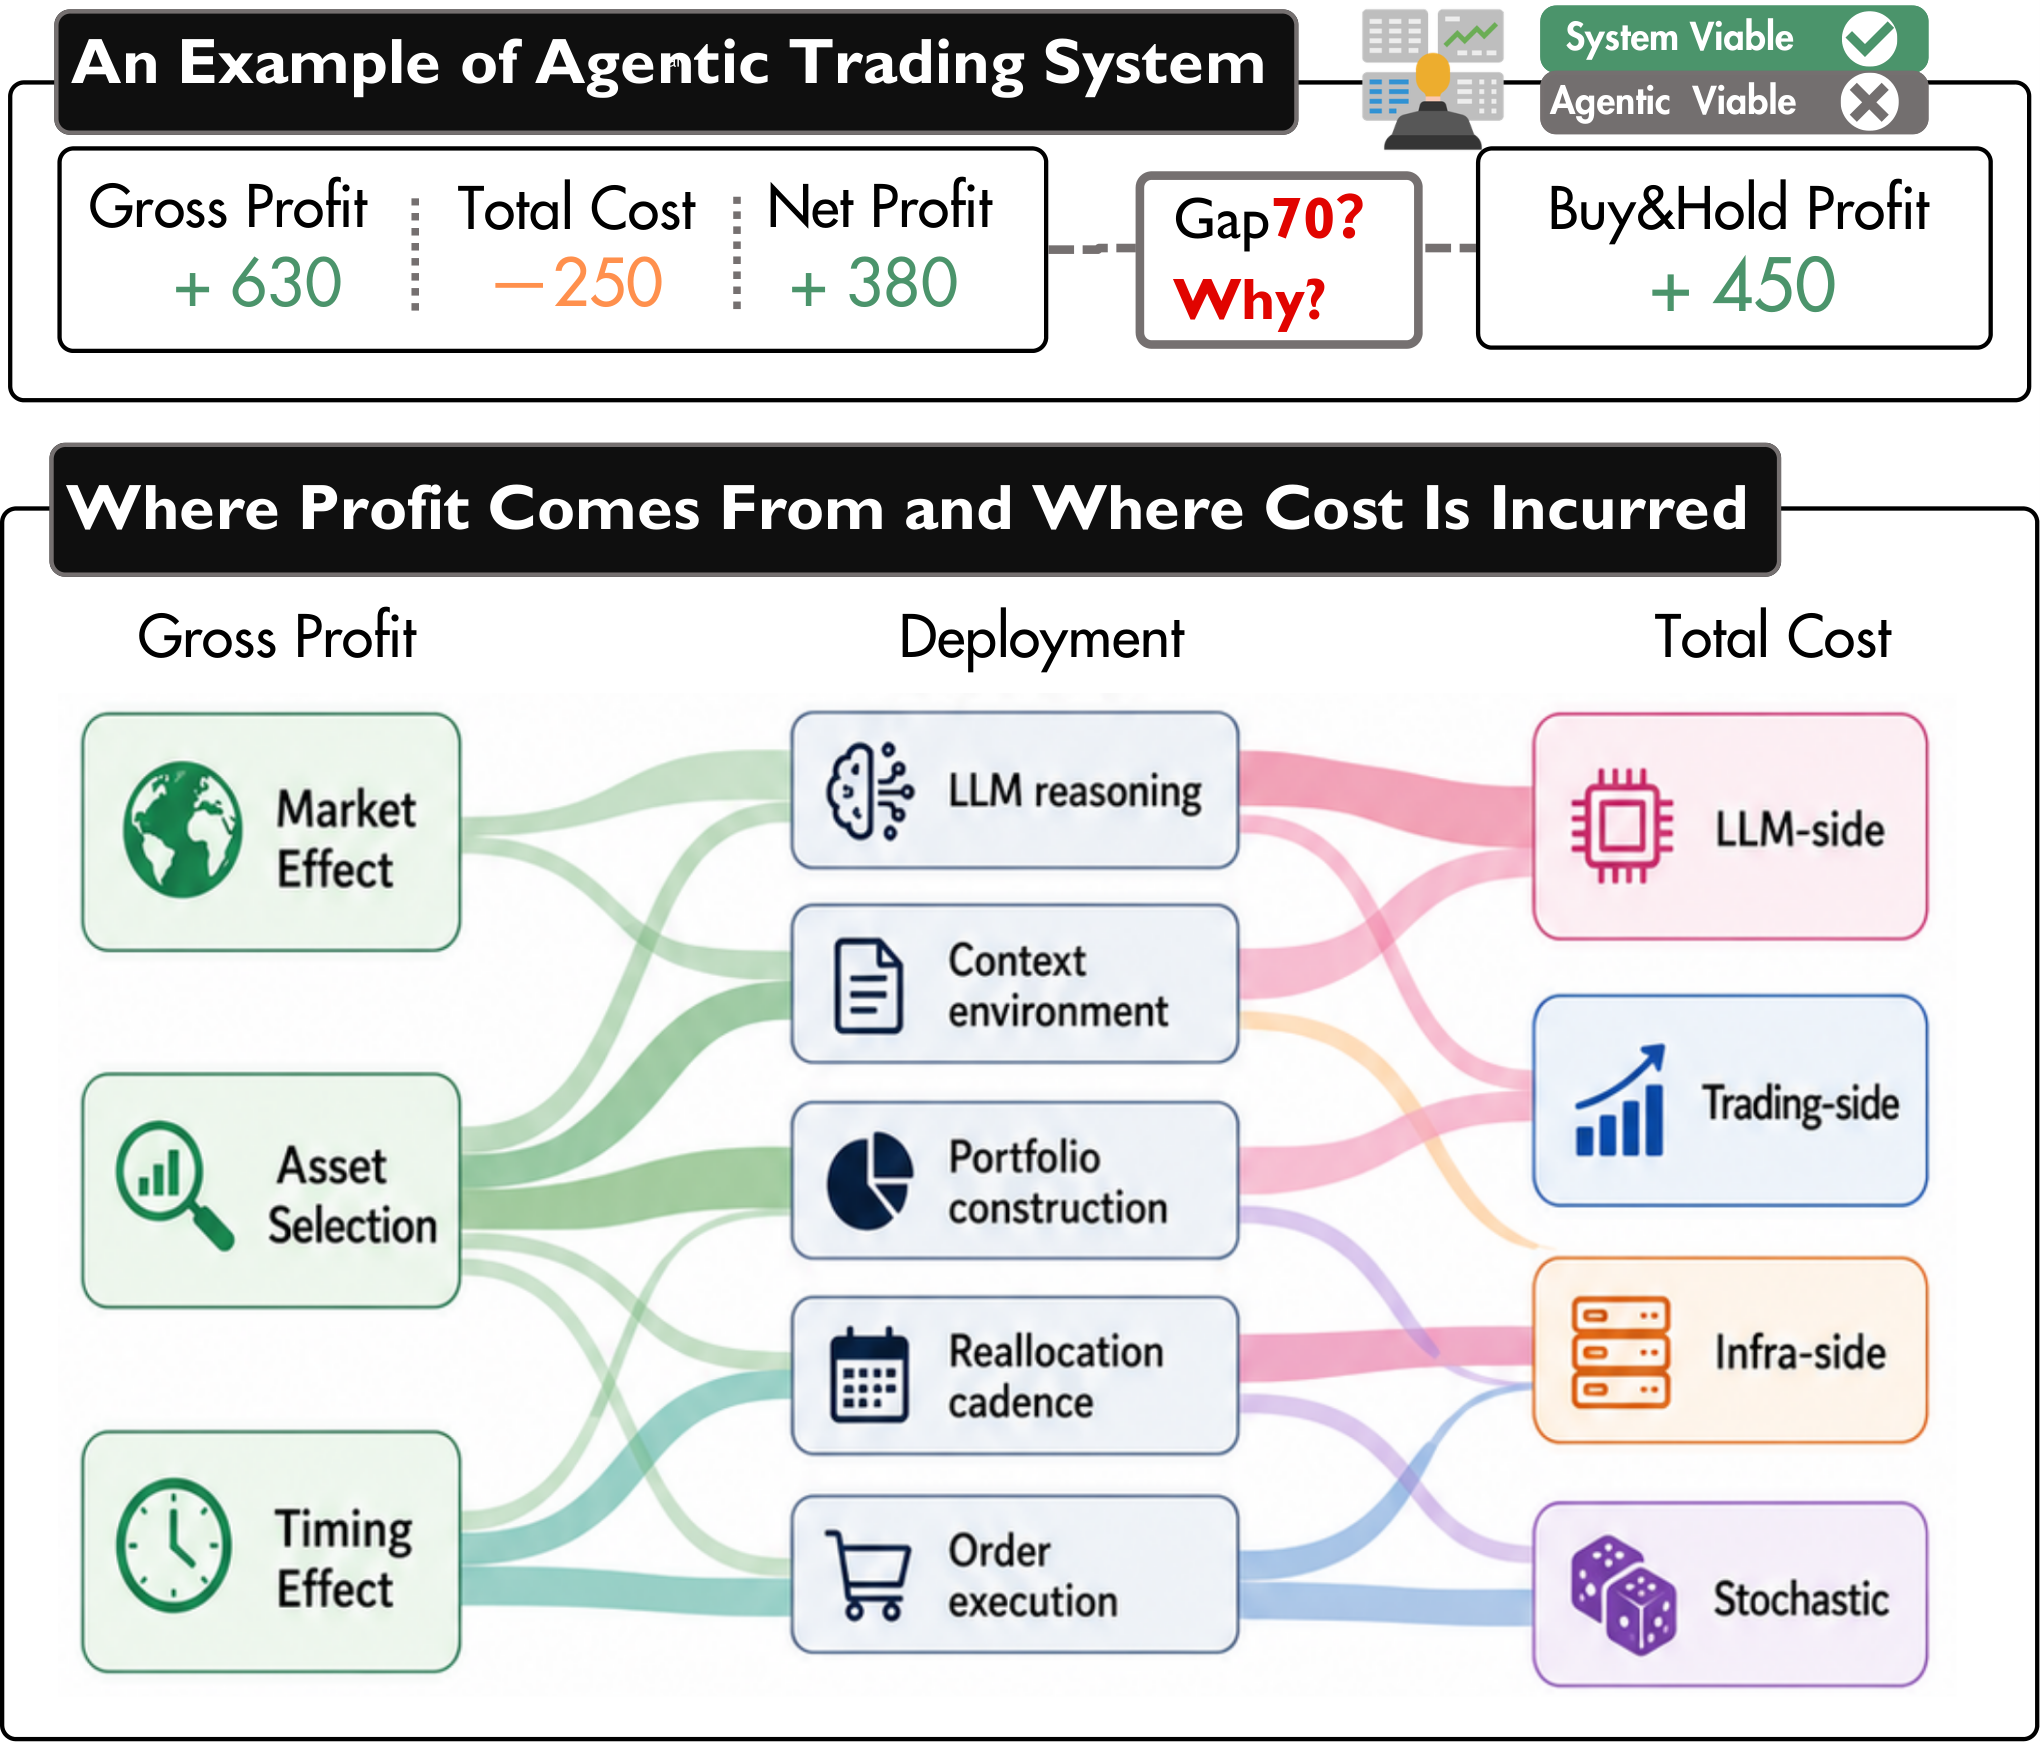
AI 트레이딩 봇이 벌어들인 수익에서 추론 비용을 빼면 남는 건 무엇일까? 10개 LLM 백본의 손익을 시장·자산선택·타이밍으로 분해한 TradeLens 진단에서, 성패를 가른 것은 AI 사용 비용이 아니라 의사결정의 질이었다. LLM 트레이딩 에이전트 비용효율성 분석.

21분
LLM 트레이딩 에이전트AI 트레이딩 비용+5
백테스트가 거짓말하는 이유 — 그리고 컴퓨터가 그 거짓말을 잡아내는 방법
알고리즘 트레이딩A

백테스트가 거짓말하는 이유 — 그리고 컴퓨터가 그 거짓말을 잡아내는 방법

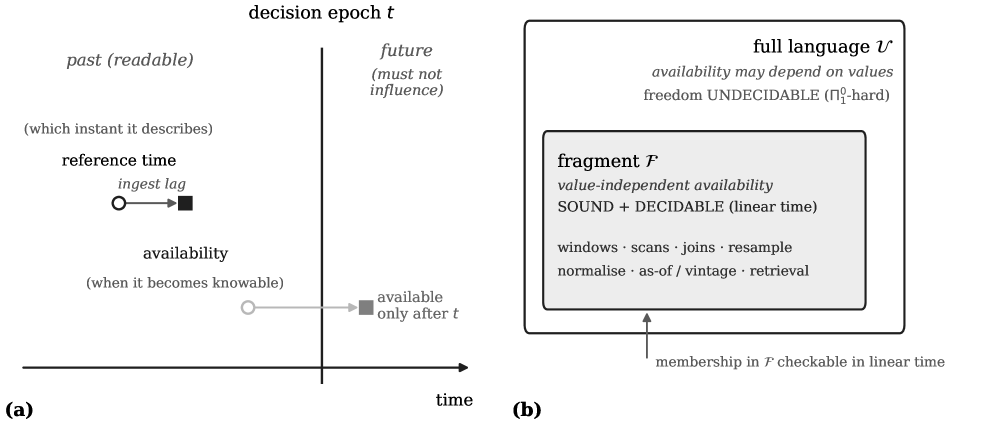
룩어헤드 바이어스를 '시간적 비간섭'이라는 수학적 개념으로 형식화하고, 백테스트 파이프라인의 정확성을 선형 시간에 검증하는 방법을 소개합니다.

11분
룩어헤드 바이어스백테스트+4
Kronos 파운데이션 모델 프레임워크 개요
딥러닝 가격 예측A

120억 개 캔들차트로 배운 AI, 주식·비트코인·환율까지 꿰뚫다 — Kronos 파운데이션 모델

45개 거래소, 120억 개 K-line 데이터로 사전학습한 금융 시계열 파운데이션 모델 Kronos를 소개합니다. 가격 예측, 변동성 예측, 합성 데이터 생성을 하나의 모델로 제로샷 처리하는 구조와 실전 시사점을 쉽게 풀어 설명합니다.

12분
파운데이션모델금융 AI+6
RL 포트폴리오 이론적 한계 분석
강화학습 포트폴리오A

강화학습 포트폴리오는 왜 돈을 잃을까? — 마이opic 최적화의 역습

강화학습(RL) 기반 포트폴리오 전략이 실전에서 손실로 이어지는 이유를 이론적으로 분석한 논문을 소개합니다. 실행 비용과 청산 마찰을 무시한 RL이 마이opic 최적화에 왜 뒤처지는지, 그리고 투자자에게 어떤 시사점을 주는지 설명합니다.

10분
강화학습포트폴리오+6
AI가 주식을 예측할 때, '기억'하고 있었다면? — MemGuard-Alpha로 LLM 알파의 함정을 걸러내는 방법
LLM 트레이딩 에이전트A

AI가 주식을 예측할 때, '기억'하고 있었다면? — MemGuard-Alpha로 LLM 알파의 함정을 걸러내는 방법

대형 언어 모델(LLM)이 금융 데이터를 '기억'해서 만든 허위 알파 신호를 실시간으로 걸러내는 MemGuard-Alpha 프레임워크를 소개합니다. Sharpe 비율 49% 개선, 오염 신호 대비 7배 수익 차이의 핵심 원리를 쉽게 풀어 설명합니다.

14분
LLM알파신호+6